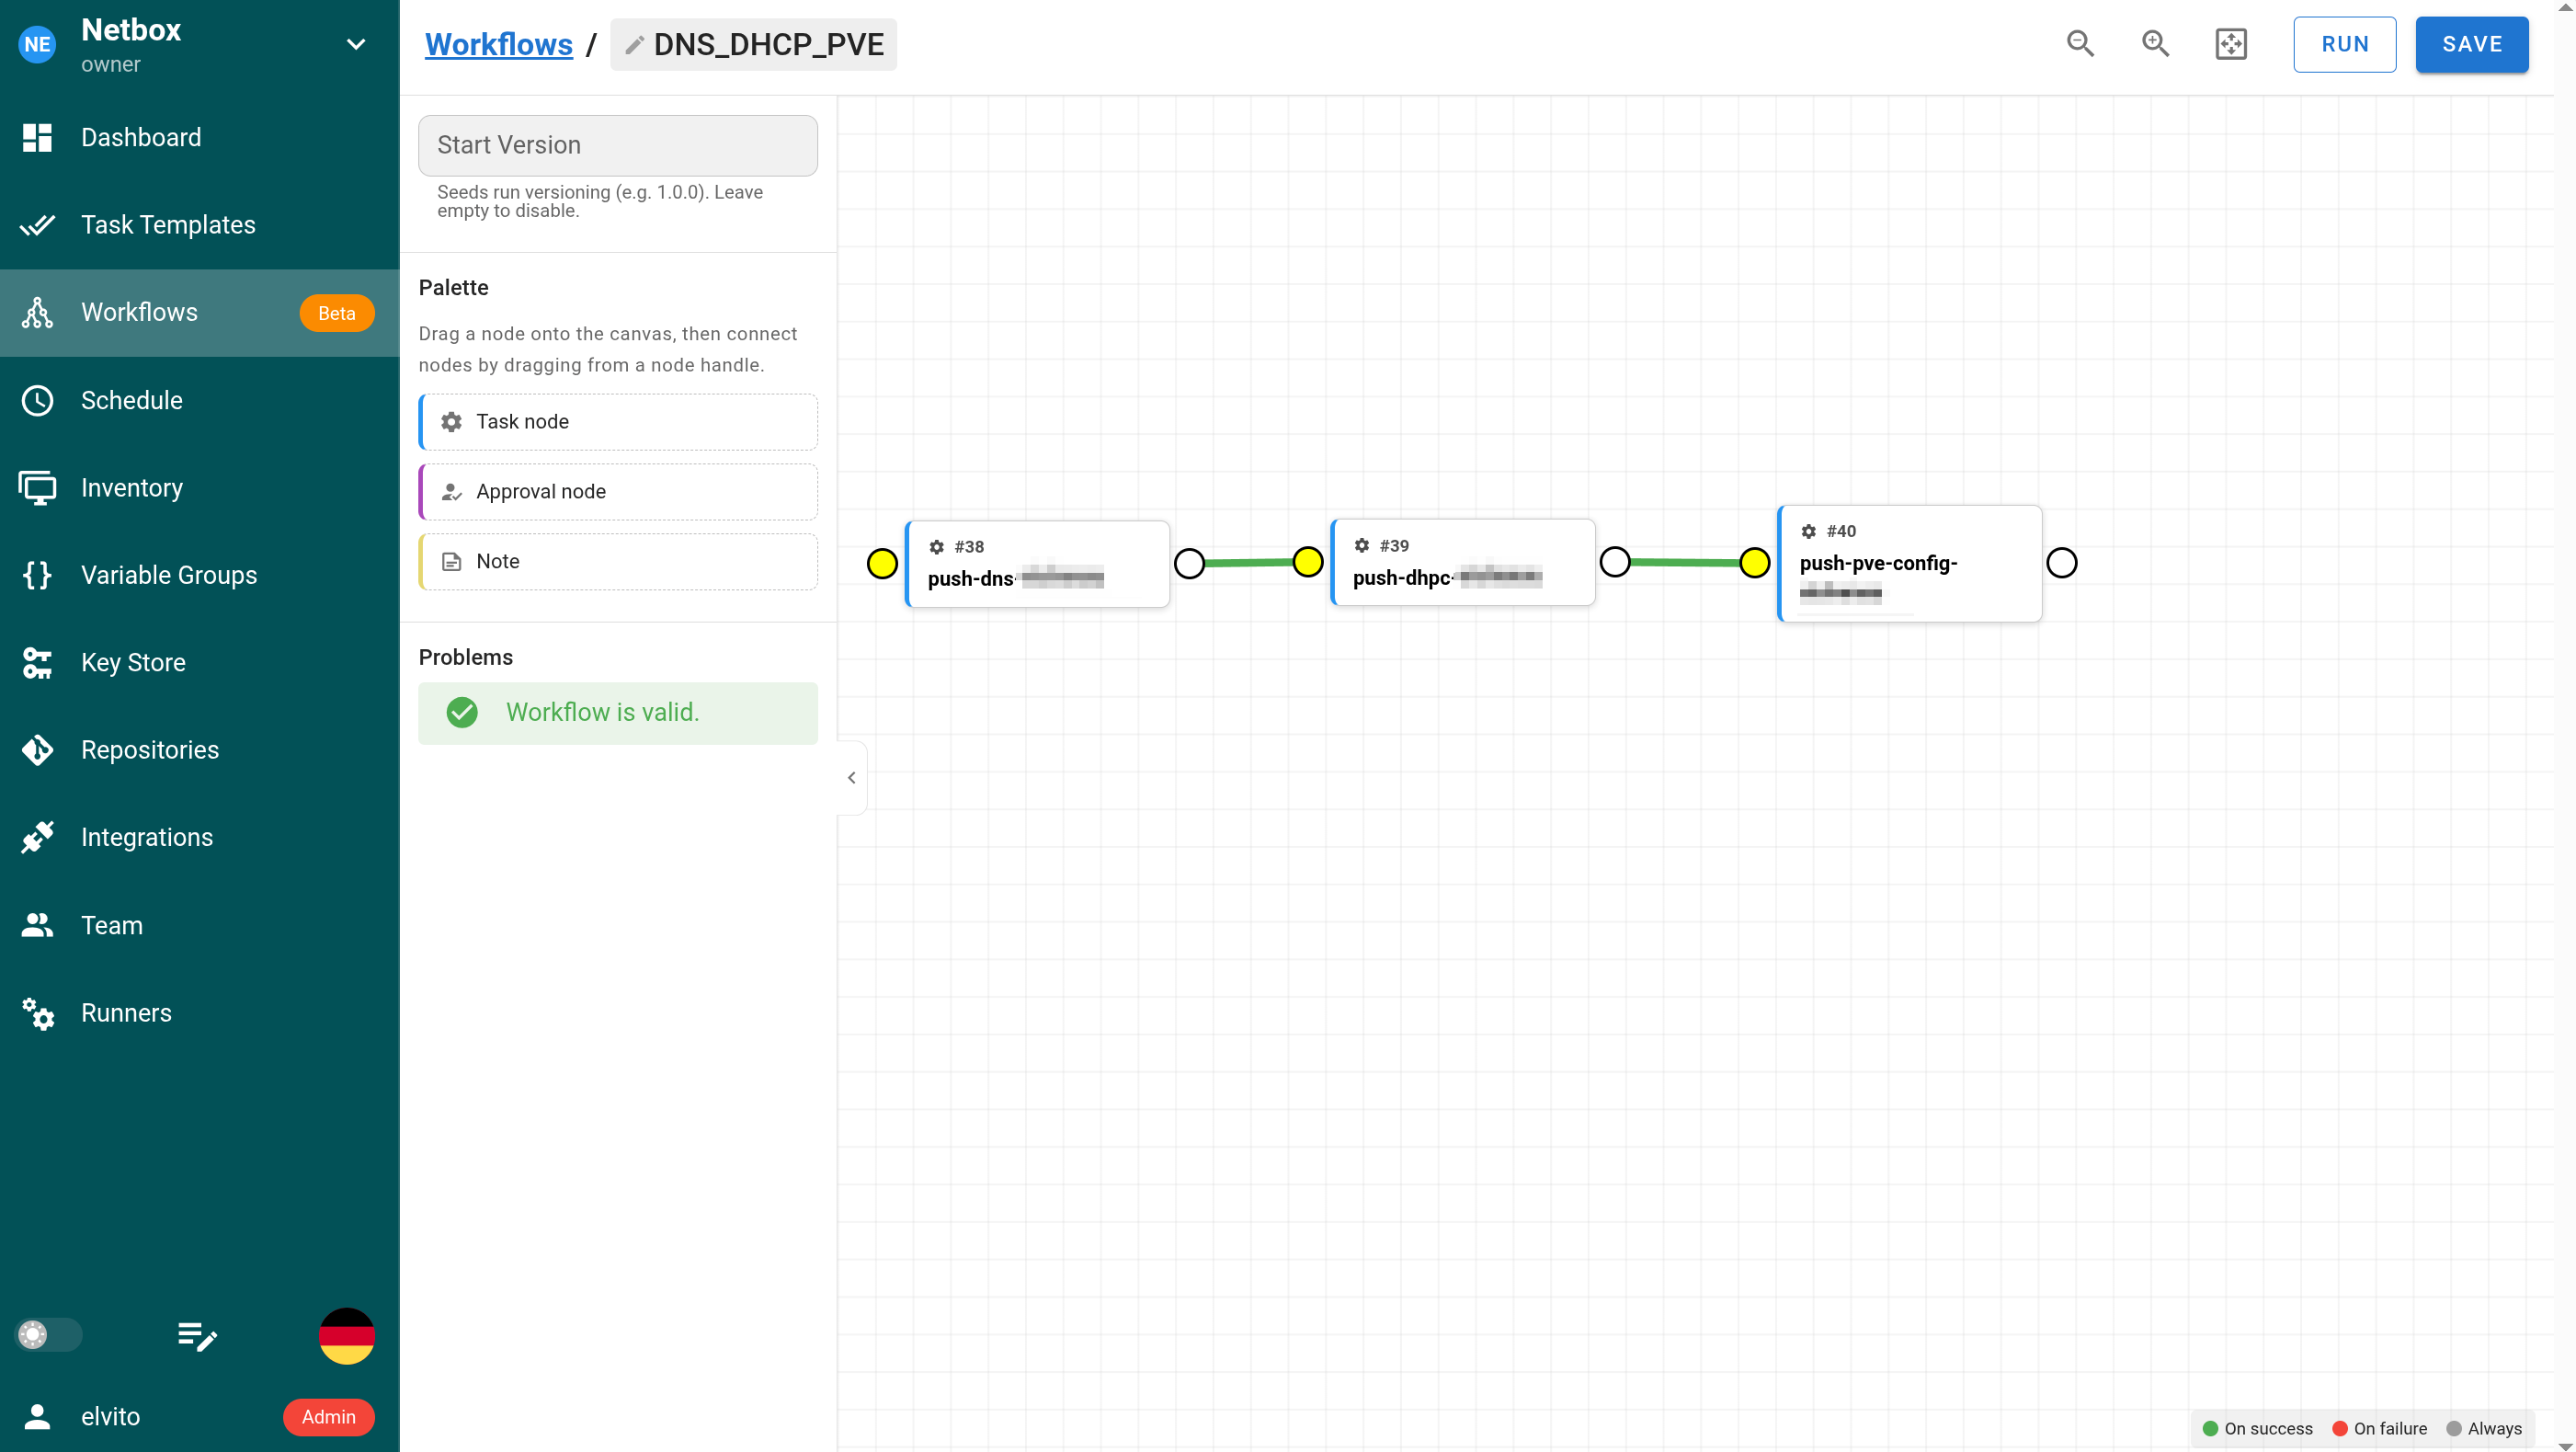
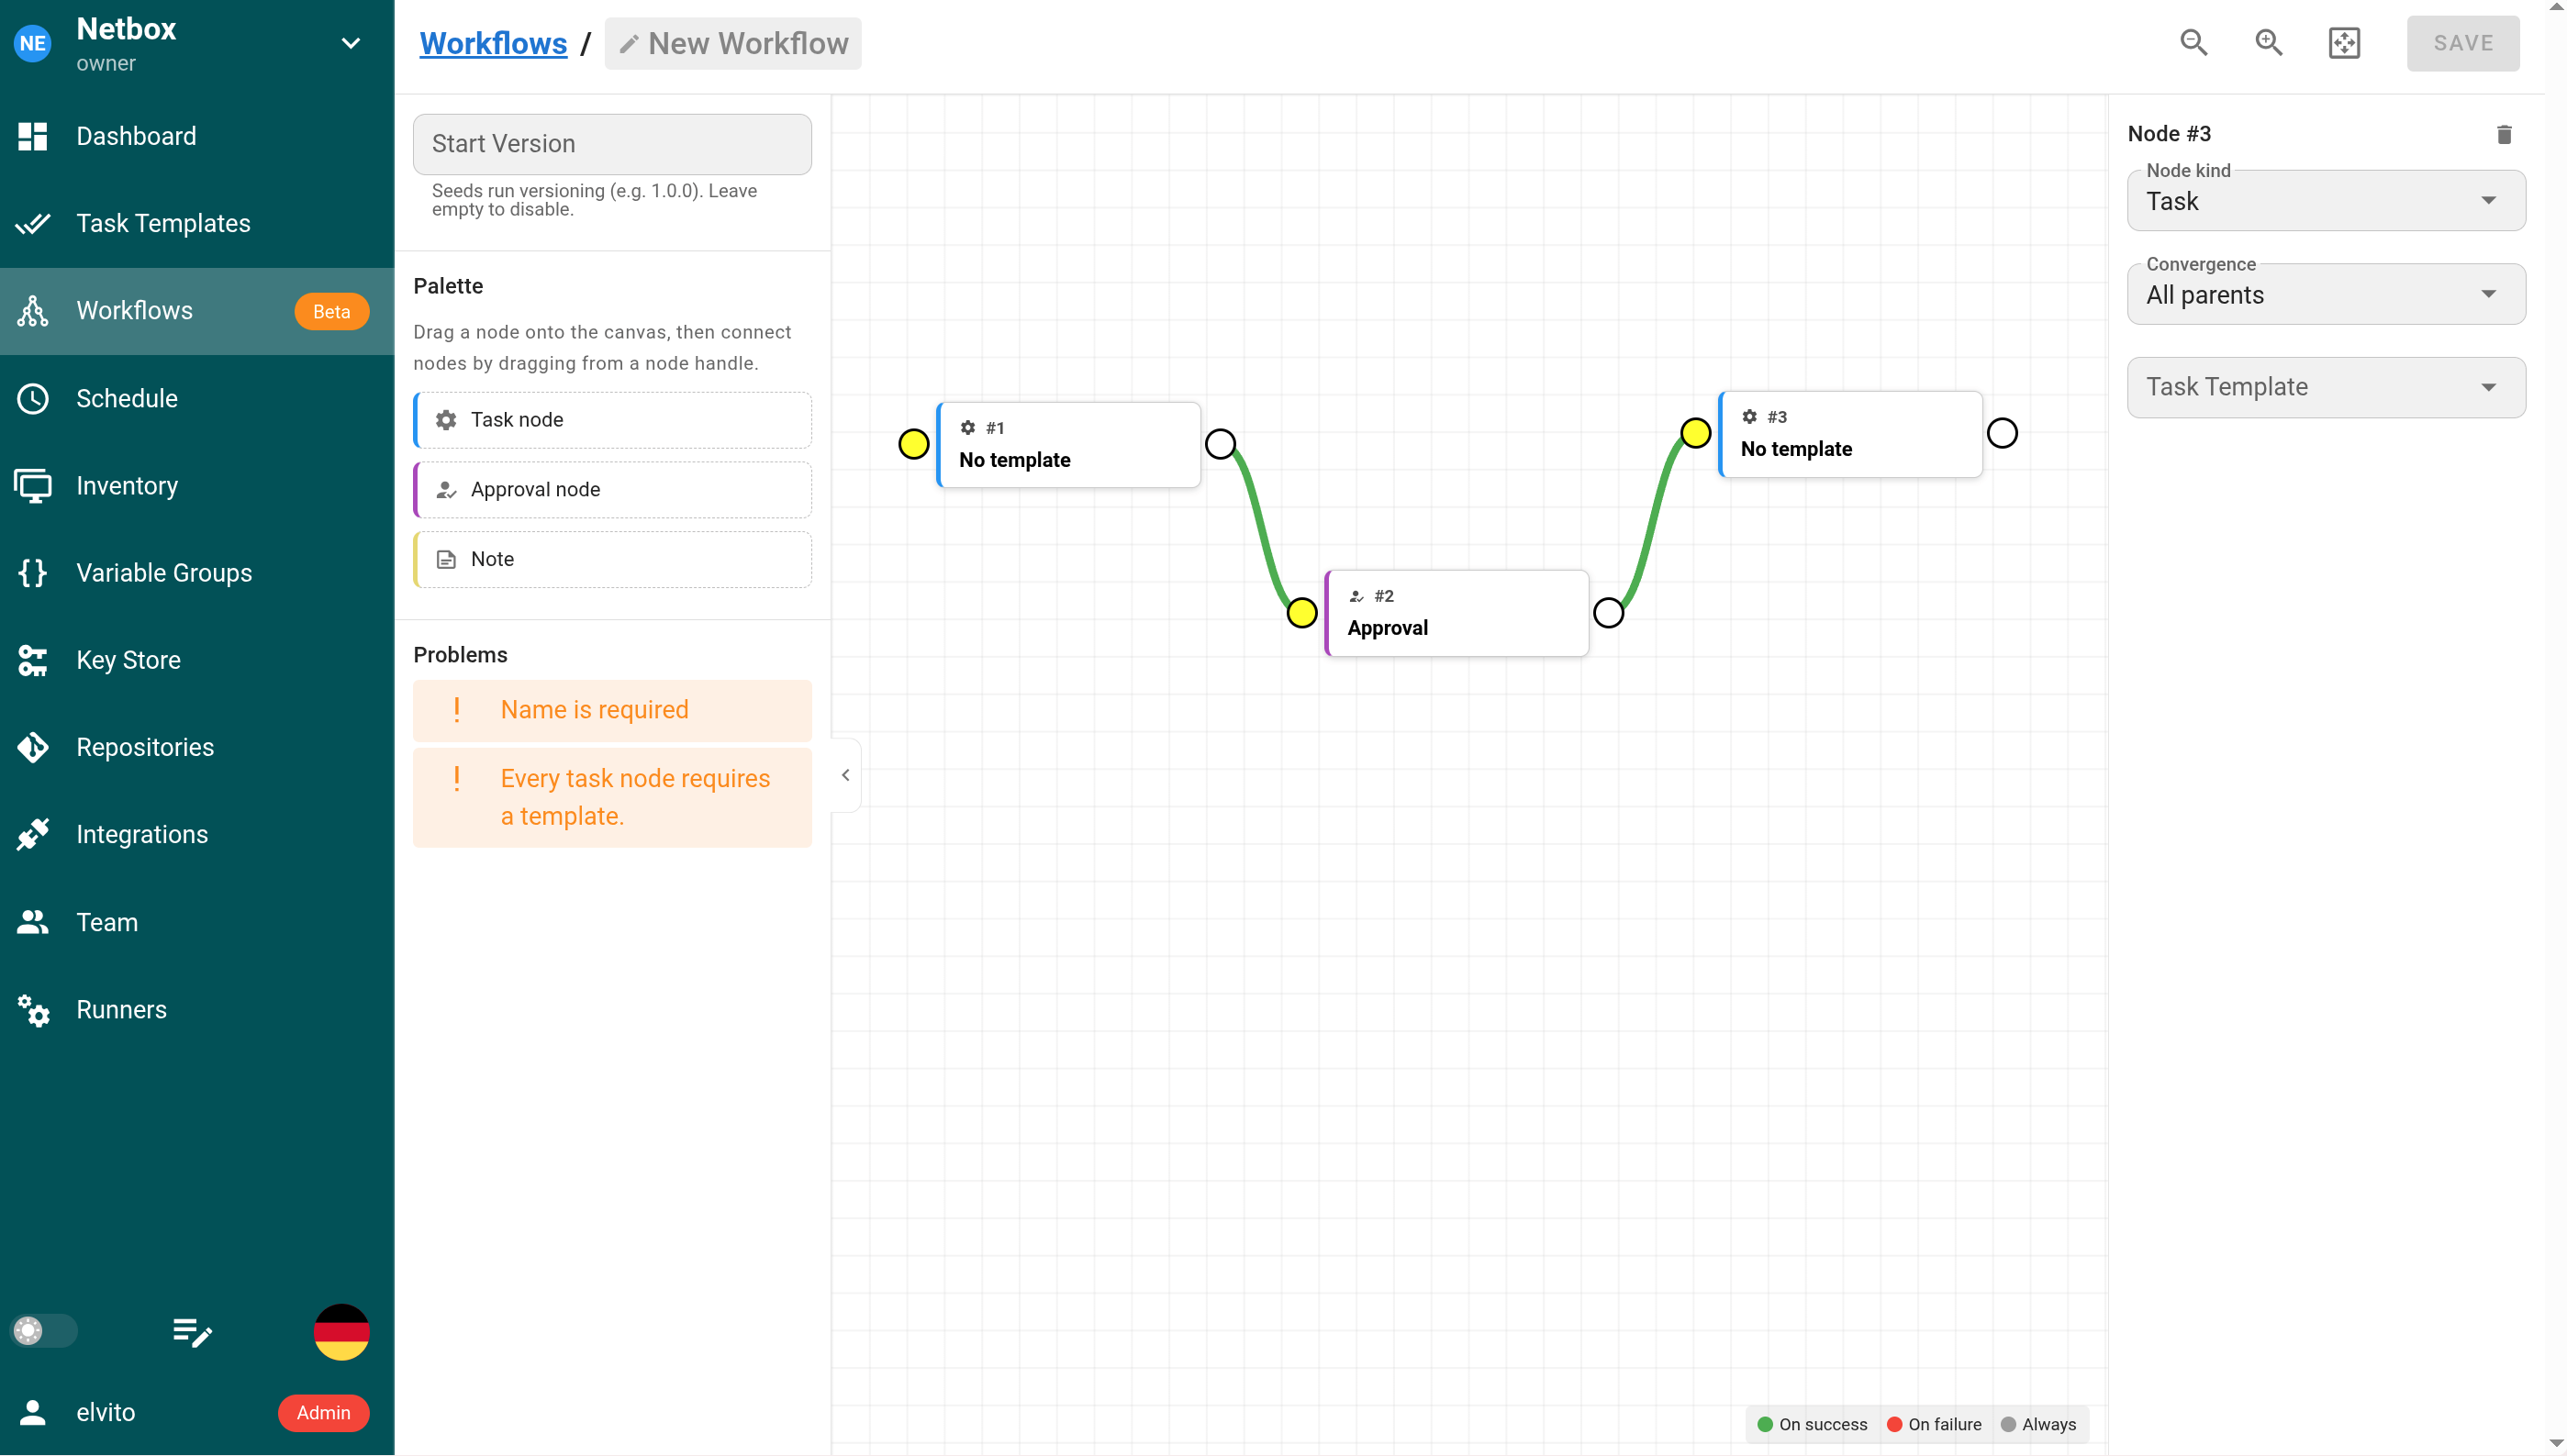
Ich habe mir nun die Workflows angesehen. Sie sind aktuell (noch) etwas rudimentär, da wird sich aber vermutlich zukünftig noch was tun. Aktuell sind Workflows jedenfalls gut geeignet, um die Ausführung verschiedener Playbooks aneinanderzureihen.
Der große Vorteil so einer Kette ist, dass man dann das Ausführen eines nachfolgenden Playbooks an die Bedingung knüpfen kann, dass das vorherige Playbook ohne Fehler durchgelaufen ist. Bisher habe ich alle Playbooks zeitversetzt per cron aufgerufen, da ist die neue Methode per Workflow doch wesentlich besser.
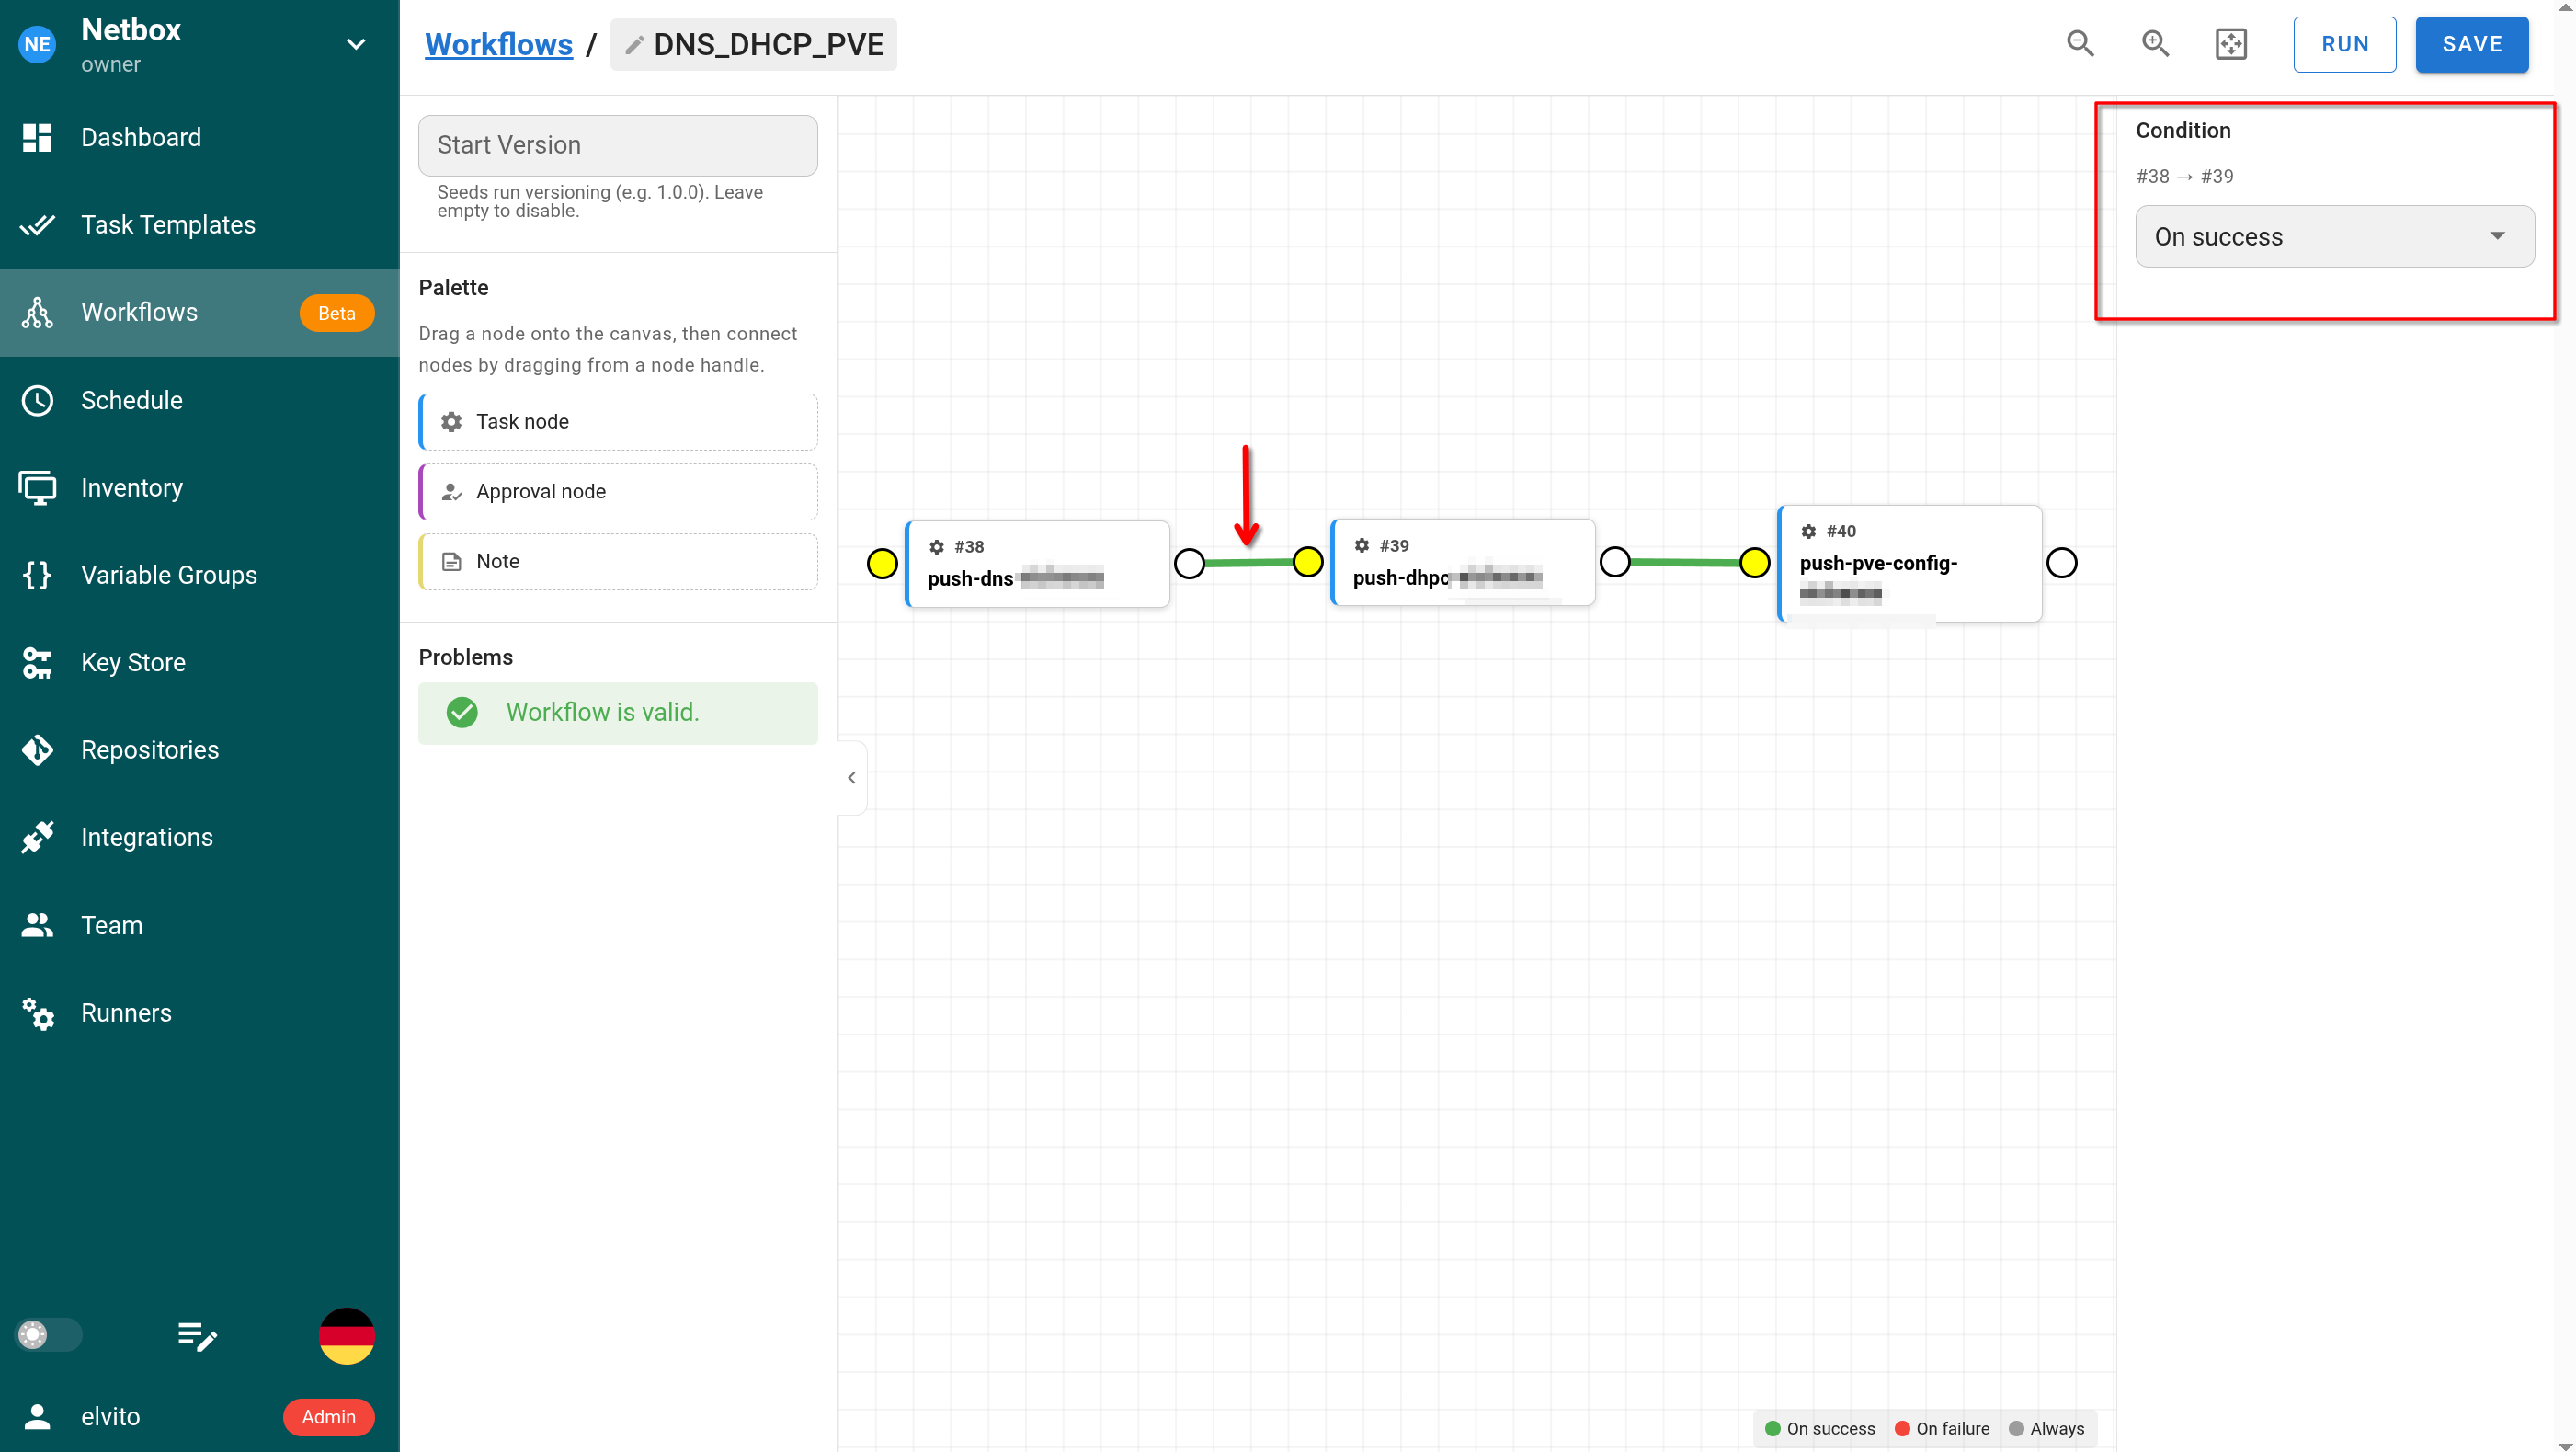
Die Bedingungen wann/ob das nächste verknüpfte Playbook ausgeführt wird, musste ich erst suchen. Diese Einstellungsmöglichkeit versteckt sich hinter der Verbindungslinie zwischen zwei Tasks.
Scheinbar gibt es derzeit noch keine Möglichkeit so einen Workflox per Schedule in Semaphore anzustoßen. Bei “Schedule” kann man in Semaphore nur Tasks aber keine Workflows als cronjob eintragen. Das kann man jedoch mit einem kleinen Trick umgehen. Dazu stoße ich den Workflow per http API Call mit einem neu erstellten Bashskript an. Das Bash Skript kann ich als “Task” bei Schedules in Semaphore eintragen. Ich erstelle in meinem Playbook Verzeichnis im LXC mit Semaphore eine neue .sh Datei z.B. trigger-sync-standorta.sh. Anschliessend noch per chmod 755 ausführbar machen. Folgender Inhalt –>
#!/bin/bash
set -euo pipefail
curl -sf -X POST
  -H "Authorization: Bearer ${SEMAPHORE_API_TOKEN}"
  -H "Content-Type: application/json"
  "http://localhost:3000/api/project/2/workflows/1/run"
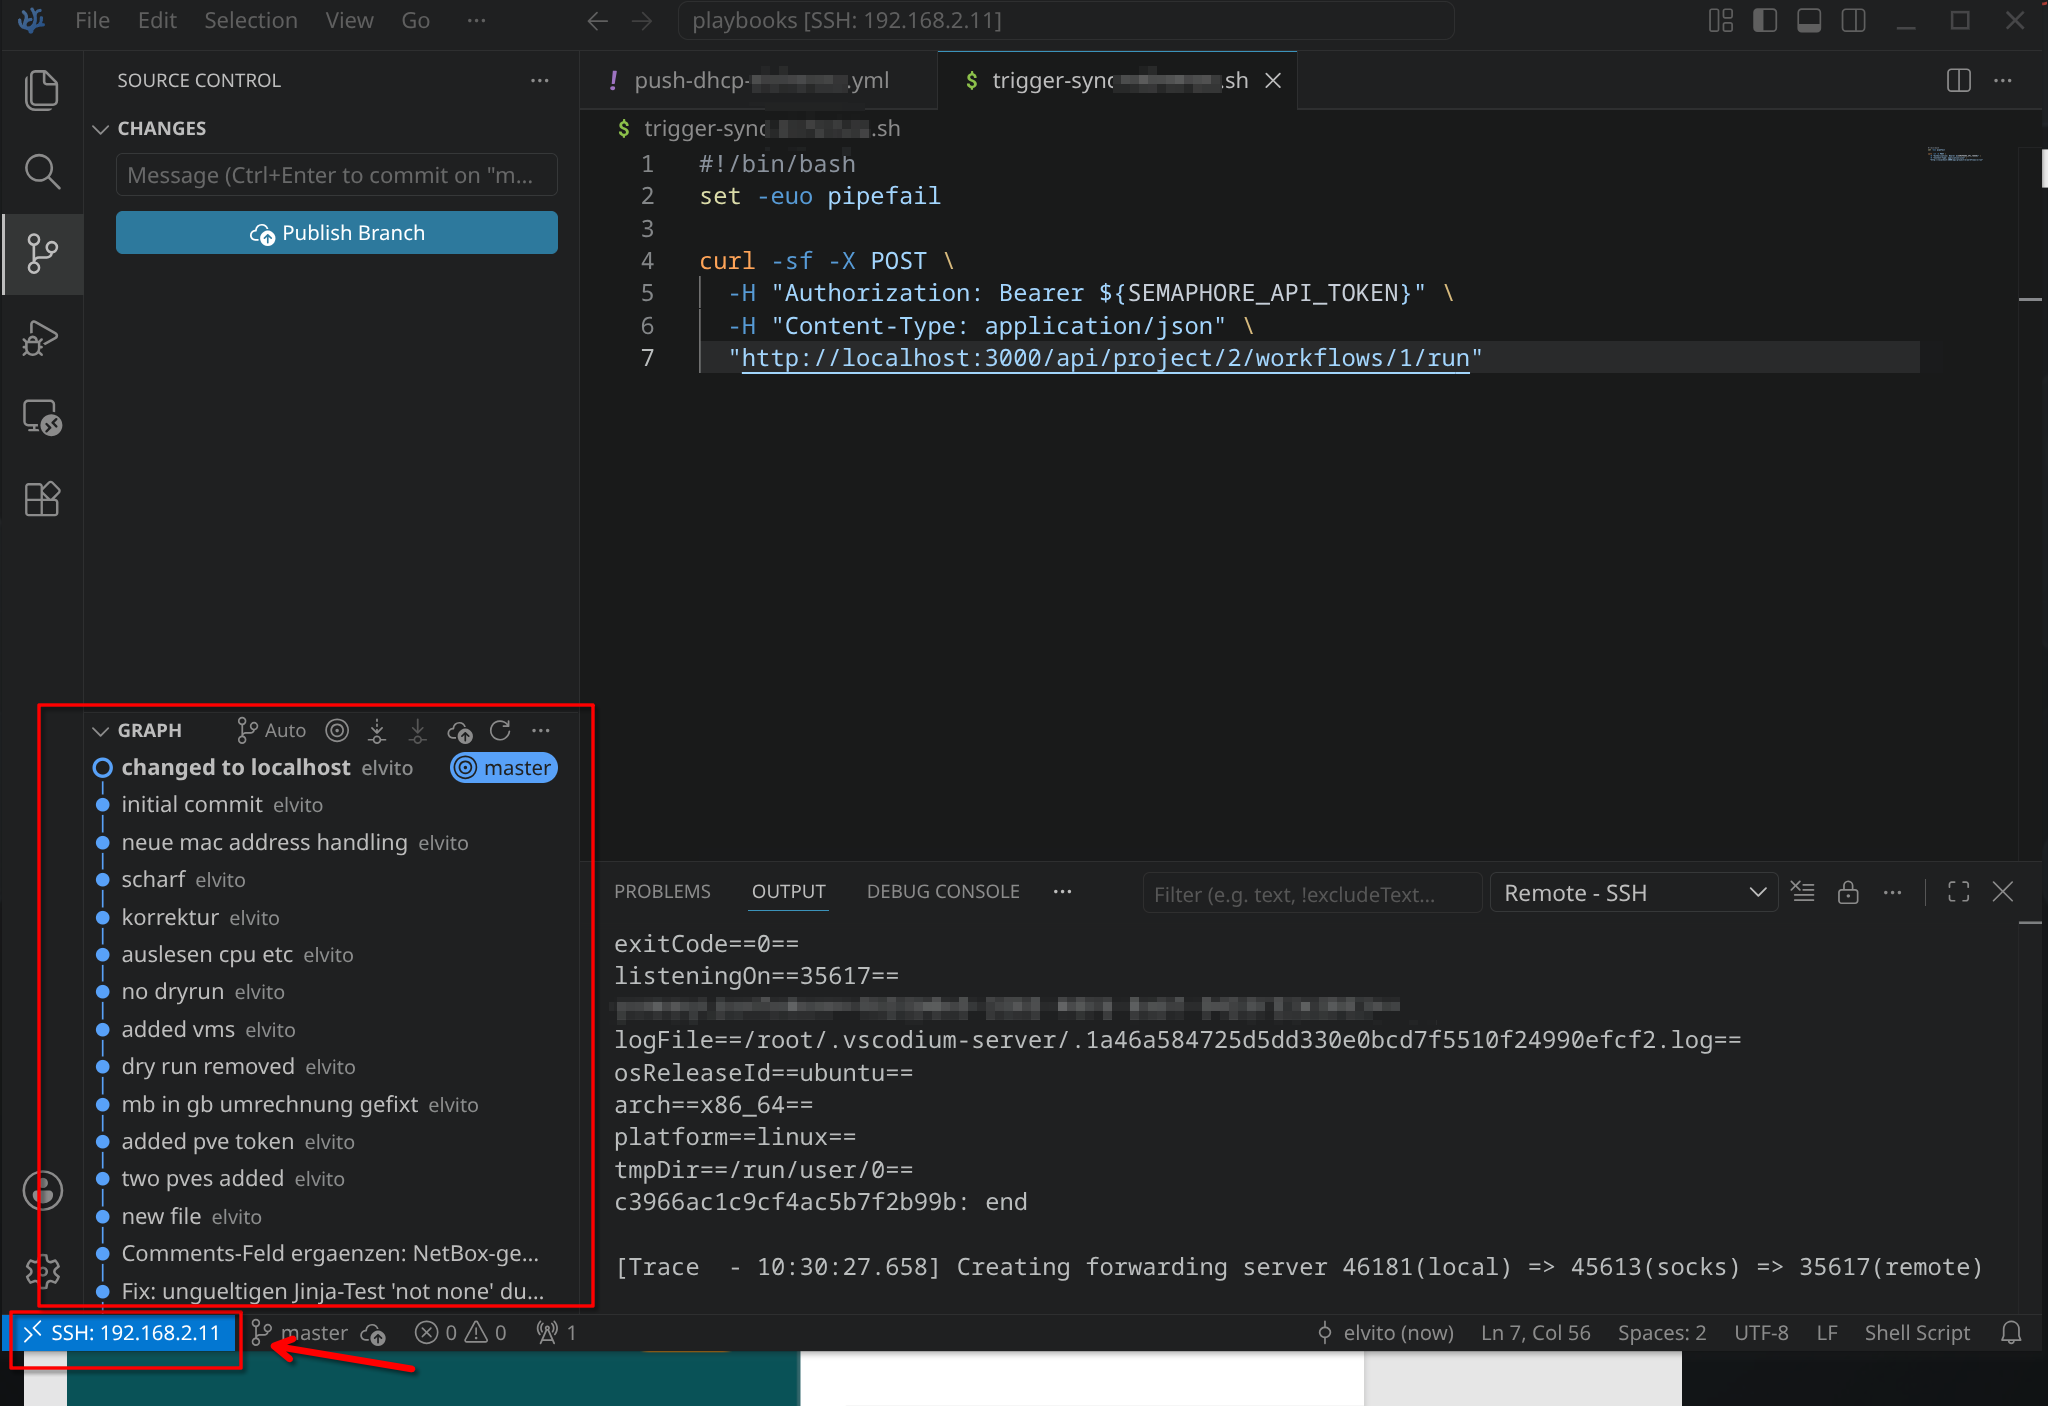
speichern und per git commiten, damit das Skript auch in Semaphore zur Verfügung steht. Das ssh Plugin für VSCodium macht solche Aktionen superkomfortabel. Das lästige commiten auf der CLI entfällt hiermit.
Es scheint als würden die Workflows einfach durchnummeriert. Ein zweiter Workflow hätte die Adresse
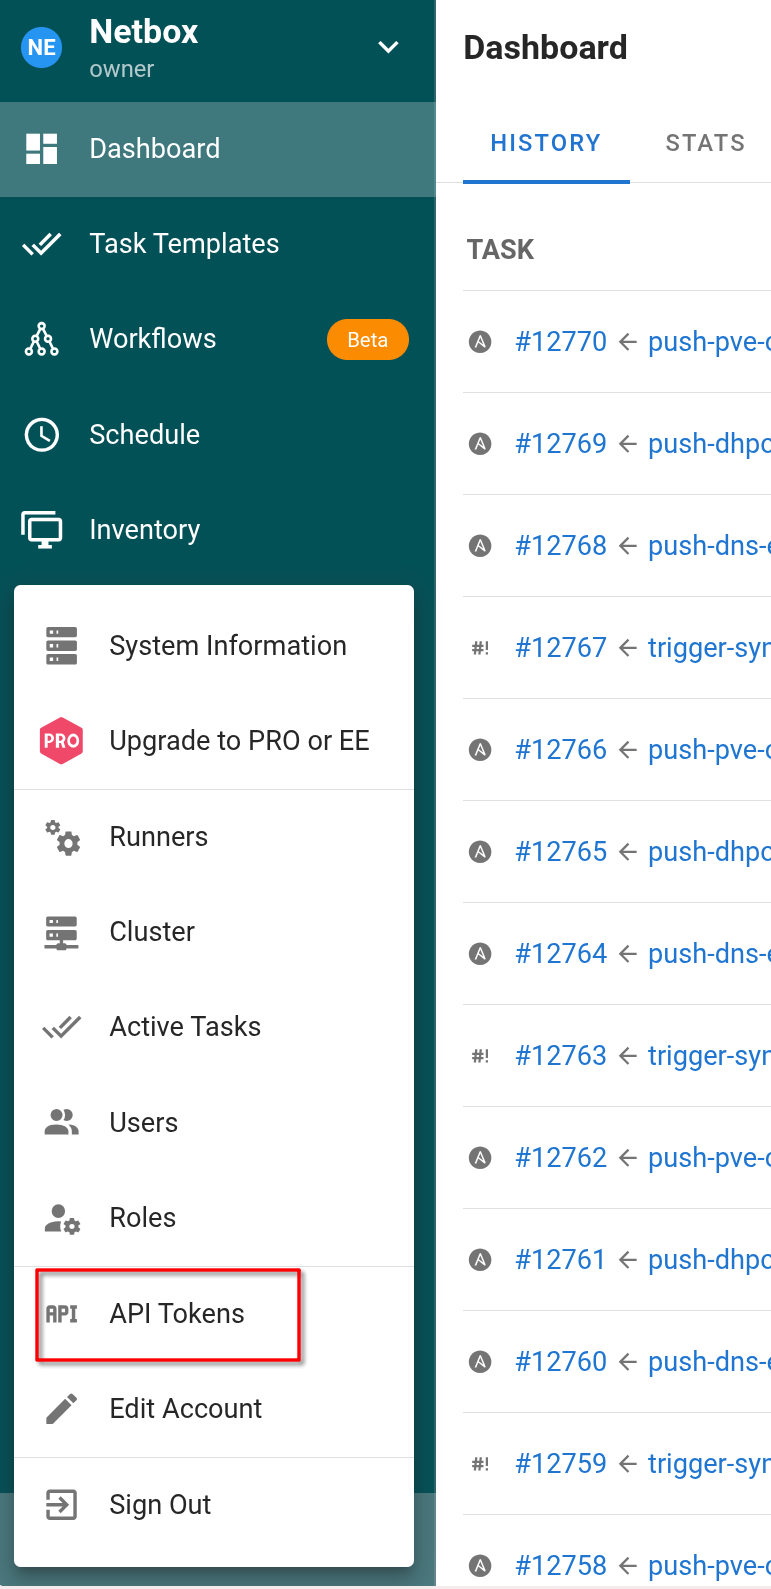
(man beachte die “2” nach ../workflows) Die Authorisierung läuft über ein Token das ich zuerst in der Semaphore GUI neu anlegen musste.
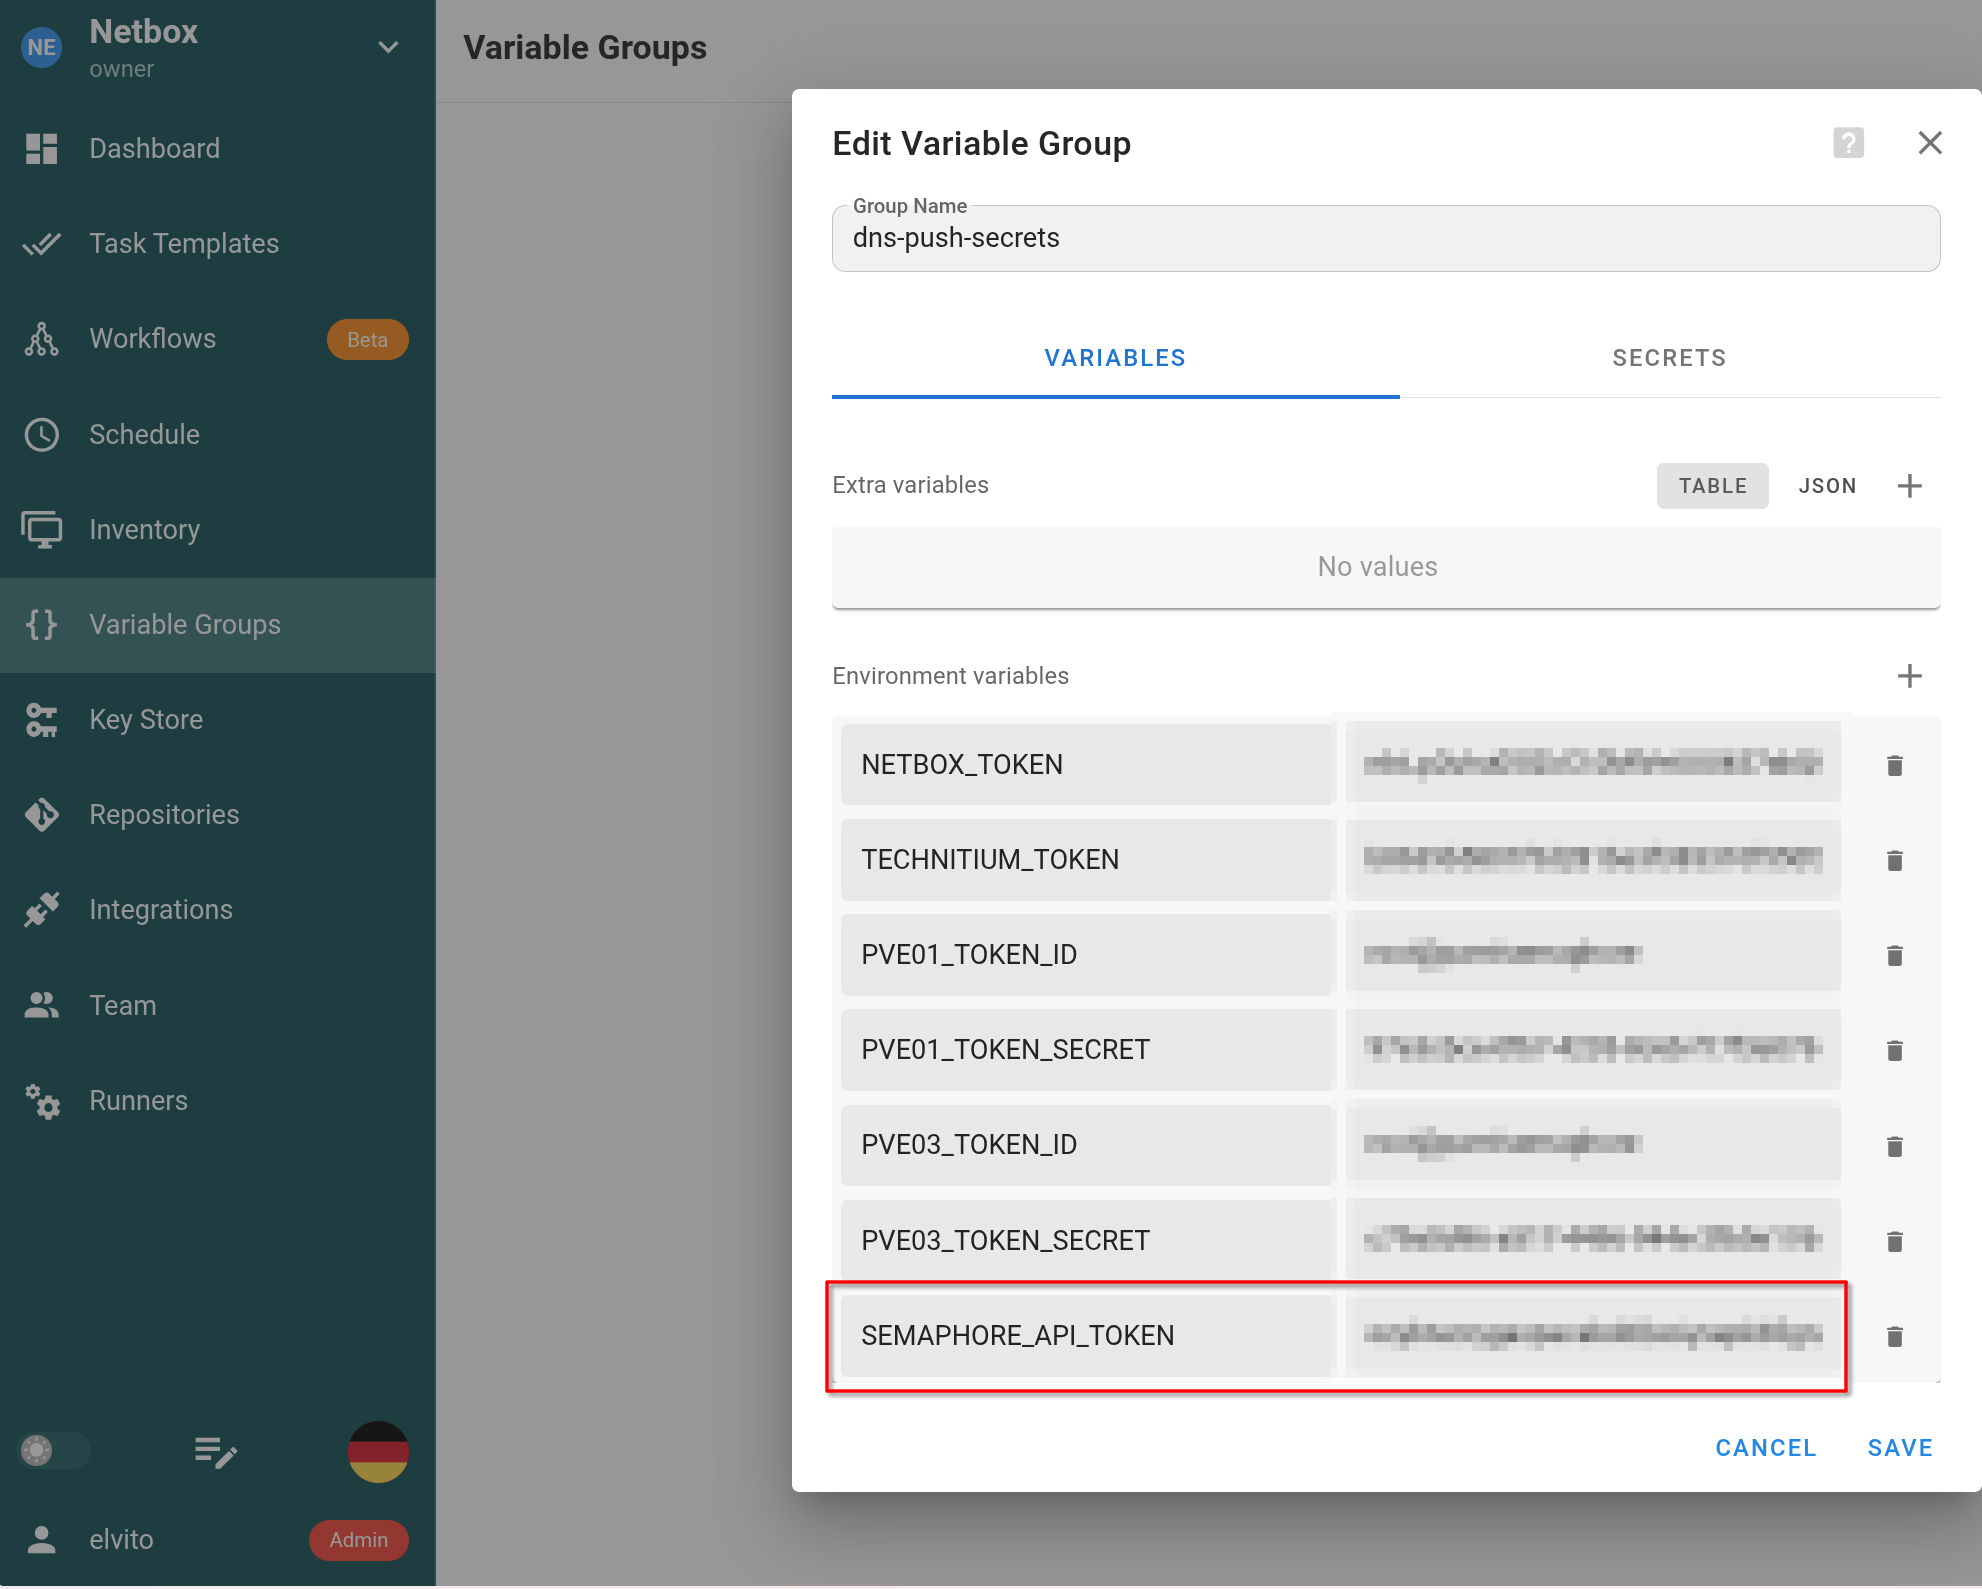
Das neu erstellte Token trage ich ebenfalls in die altbekannte Variablendatei ein.
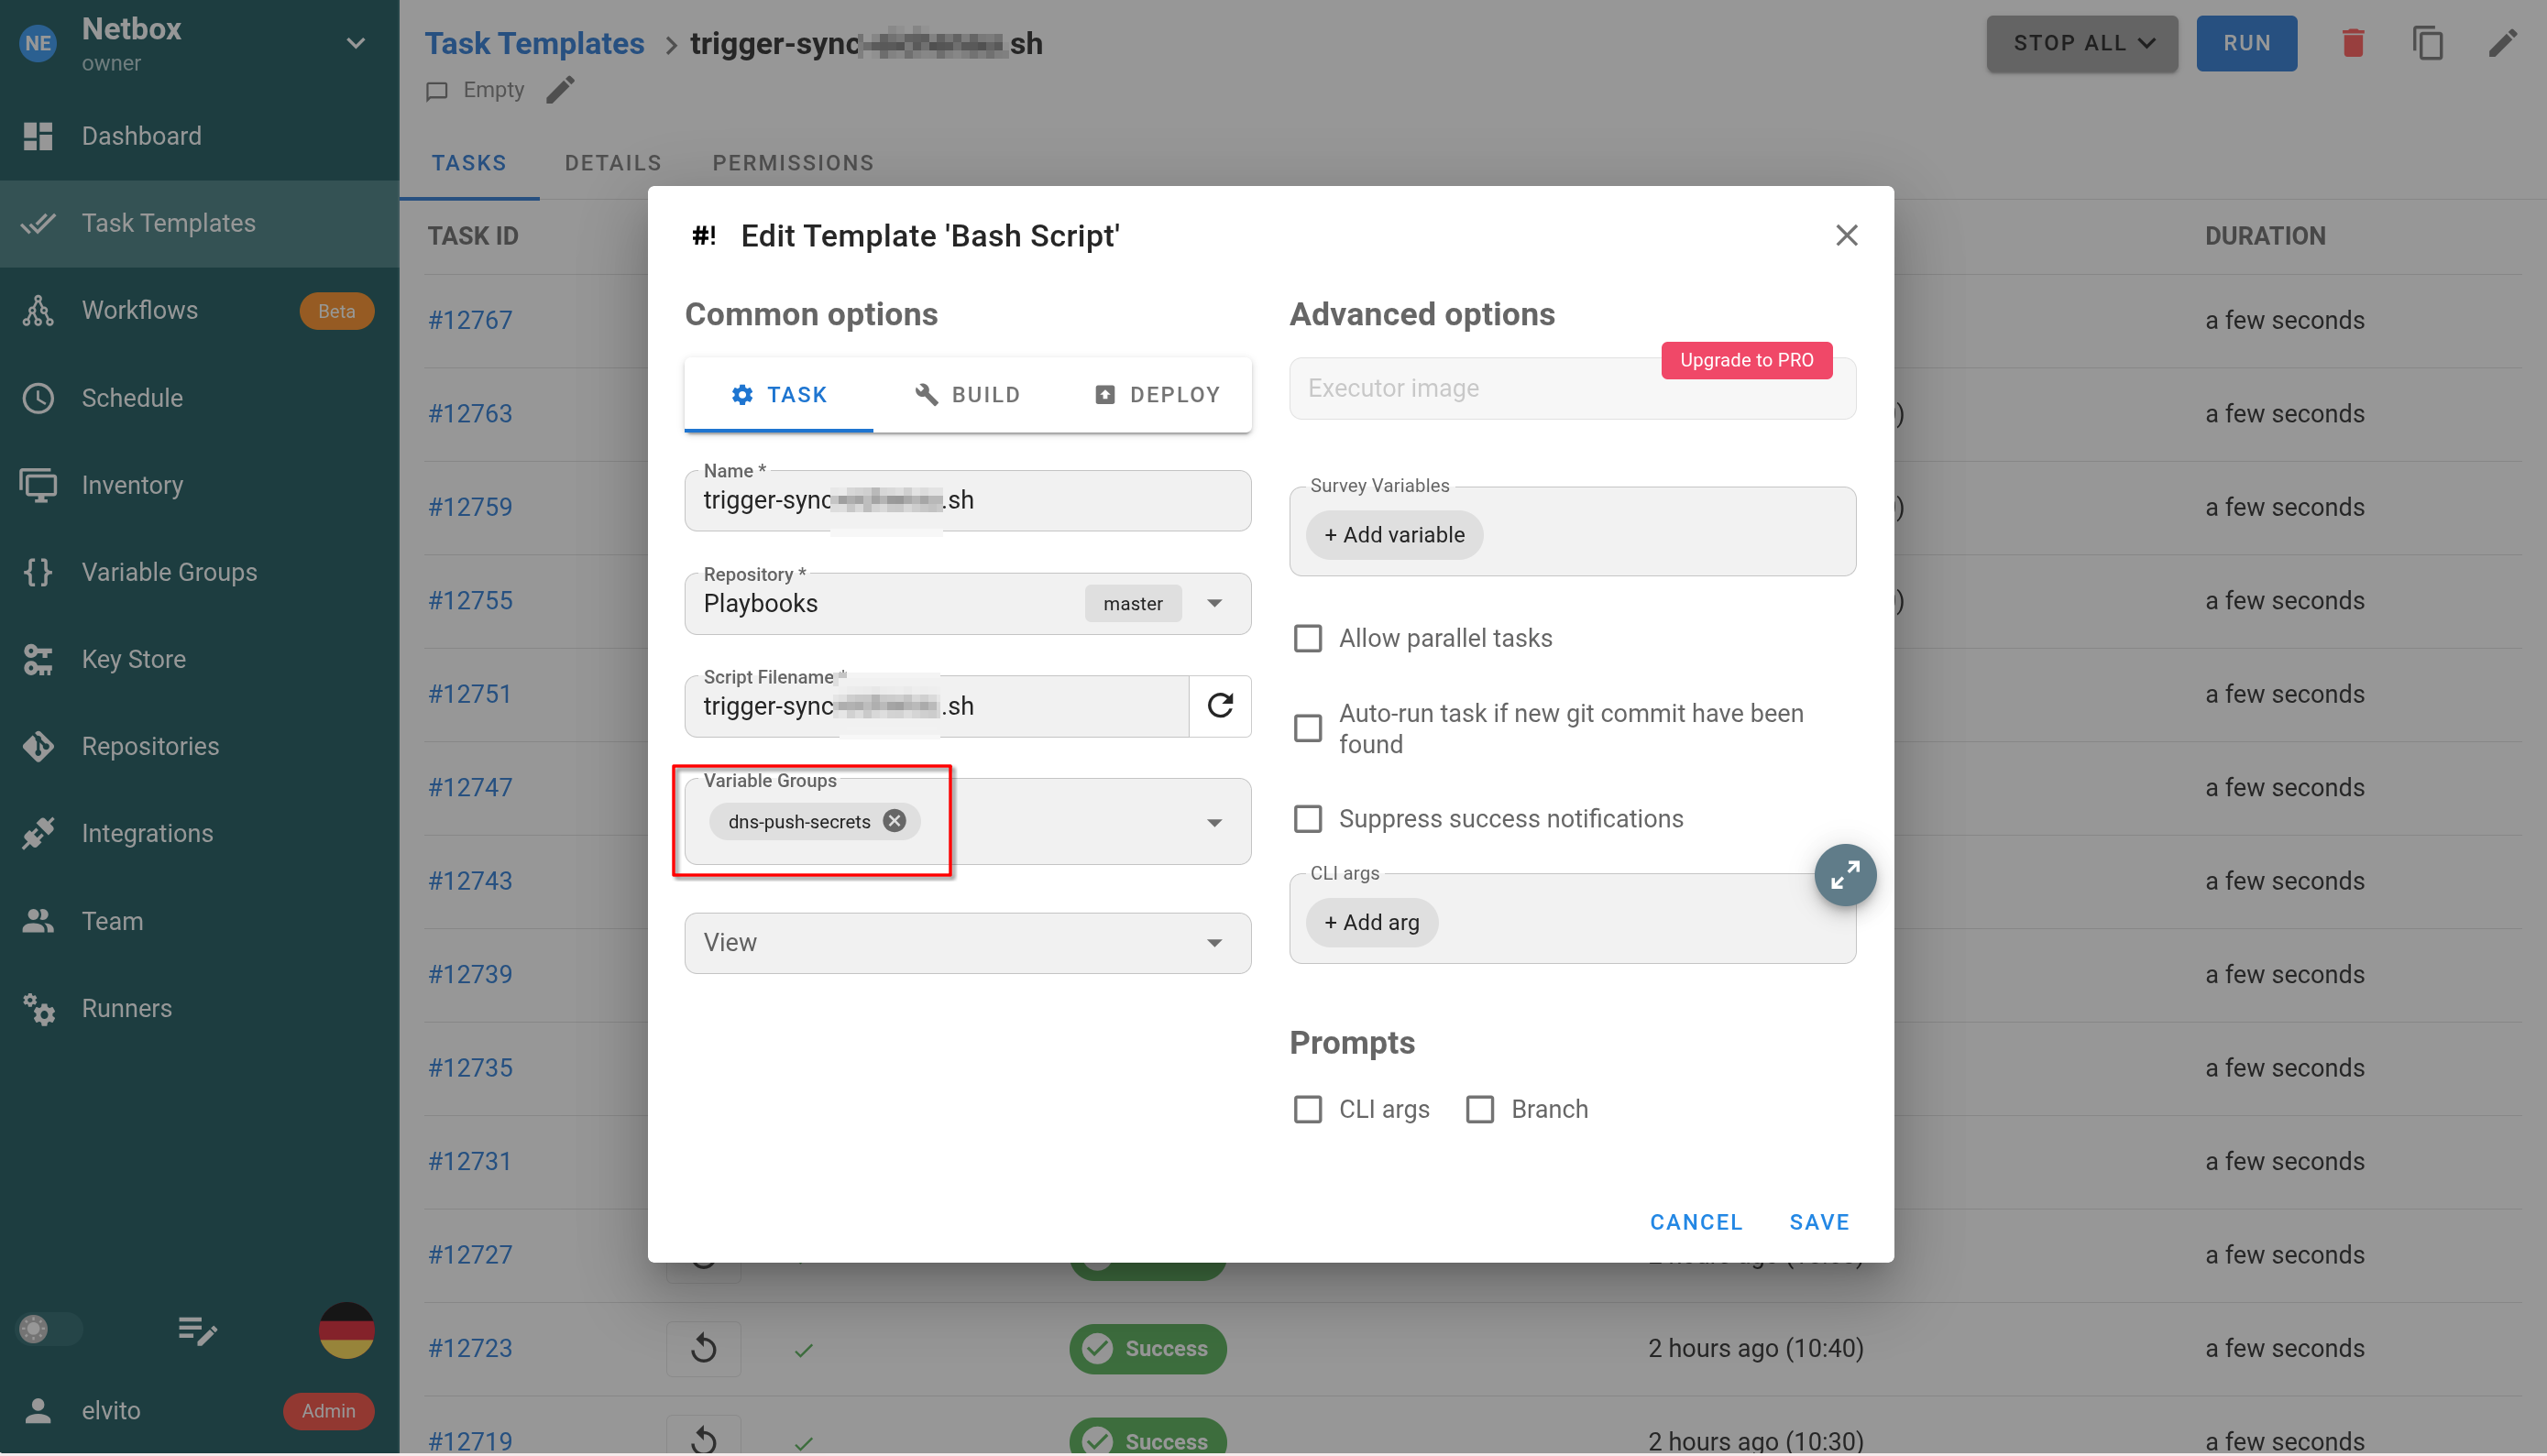
“passwords” o.ä. wäre ein besserer Name für für diese Variablendatei gewesen, das ändere ich evtl im Verlauf noch. Als nächstes unter Templates ein neues Bashskript einrichten. Hier die o.g. Variablendatei mit angeben sonst klappt die Authentifizierung nicht.
Das neu angelegte Template kann man nun bei Schedules als cronjob eintragen. Das läuft seit 2 Tagen ausgezeichnet. Theoretisch kann man mit solchen Bashskripten am Anfang und Ende solcher Ketten auch Aufzweigungen, Schleifen usw. basteln. Ich bin aber ziemlich sicher, dass die Workflows noch erweitert werden, daher werde ich von solchen Bastellösungen eher Abstand nehmen.
Netbox/Semaphore usw. läuft bisher nur bei mir zuhause und wie sich aktuell zeigt, aus gutem Grund. Das letzte Netbox Update, genauer gesagt ein Update des DHCP Plugins hat beim Sprung auf Netbox 4.7.0 diverse Änderungen mit sich gebracht, die eines meiner Playbooks leider in die Knie gezwungen haben. Das DHCP Plugin von Peter Eckel ist weiterhin beta, weswegen ich das Setup mit Netbox/Semaphore auch weiterhin (noch) nicht in einem produktiven Umfeld einsetzen werde. Ich vermute die Änderungen vom 04.08.26 im Netbox DHCP Plugin sind der konkrete Grund.
Die Fehlermeldung bei Semaphore lautet (exemplarisch für das dashy LXC):
7:35:10 PM
ok: [dns-redacted] => (item=dashy) => {
7:35:10 PM
    "msg": "WARNUNG: dashy hat hw_address_id={'id': 7, 'url': 'https://192.168.2.10/api/dcim/mac-addresses/7/', 'display': 'BC:24:11:xx:xx:xx', 'mac_address': 'BC:24:11:xx:xx:xx', 'description': ''}, keine passende MAC in mac_lookup gefunden - wird uebersprungen"
7:35:10 PM
}
ich habe jedenfalls das dhcp-push skript an die neuen Gegebenheiten angepasst. –>
---
# push-dhcp-standort-a.yml
#
# Discovery-Phase: schreibt noch NICHTS in Technitium, liest nur
# Host-Reservations aus netbox-plugin-dhcp + Scope-Config aus Technitium.
#
# Aufruf:
#   ansible-playbook -i inventory/netbox.yml push-dhcp-standort-a.yml --limit dns-standort-a
- name: DHCP-Reservierungen NetBox <-> Technitium - Discovery
  hosts: dns-standort-a
  gather_facts: false
  vars:
    netbox_api: "https://192.168.2.10"
    netbox_token: "{{ lookup('env', 'NETBOX_TOKEN') }}"
    technitium_url: "https://{{ ansible_host }}:53443"
    technitium_token: "{{ lookup('env', 'TECHNITIUM_TOKEN') }}"
    target_vrf_name: "VRF Standort A"
    technitium_scope_name: "StandortA"
    dry_run: true  # true = nur anzeigen, kein Schreibzugriff
  tasks:
    - name: Alle VRFs holen (ungefiltert, wegen Leerzeichen im Namen)
      ansible.builtin.set_fact:
        all_vrfs: >-
          {{ query('netbox.netbox.nb_lookup', 'vrfs',
                    api_endpoint=netbox_api, token=netbox_token,
                    validate_certs=false)
             | map(attribute='value') | list }}
    - name: Ziel-VRF lokal per Namen herausfiltern
      ansible.builtin.set_fact:
        target_vrf: "{{ all_vrfs | selectattr('name', 'equalto', target_vrf_name) | first }}"
    - name: Prefixe der Ziel-VRF holen
      ansible.builtin.set_fact:
        target_prefixes: >-
          {{ query('netbox.netbox.nb_lookup', 'prefixes',
                    api_endpoint=netbox_api, token=netbox_token,
                    api_filter='vrf_id=' ~ target_vrf.id, validate_certs=false)
             | map(attribute='value') | map(attribute='prefix') | list }}
    - name: Alle Host Reservations holen
      ansible.builtin.set_fact:
        all_dhcp_reservations: >-
          {{ query('netbox.netbox.nb_lookup', 'hostreservations',
                    api_endpoint=netbox_api, token=netbox_token,
                    plugin='netbox-dhcp', validate_certs=false)
             | map(attribute='value') | list }}
    - name: Anzahl gefundener Reservations
      ansible.builtin.debug:
        msg: "{{ all_dhcp_reservations | length }} Host Reservations gesamt gefunden"
    # Fallback-Lookup fuer den Fall, dass hw_address wieder nur eine ID liefert
    # (Plugin < 0.1.10). Seit 0.1.10 ("Fixed nested serializers") liefert
    # hw_address bereits ein verschachteltes Objekt inkl. mac_address.
    - name: MAC-Address-Objekte holen (limit=0, fuer Lookup-Fallback)
      ansible.builtin.uri:
        url: "{{ netbox_api }}/api/dcim/mac-addresses/?limit=0"
        method: GET
        headers:
          Authorization: "Token {{ netbox_token }}"
        validate_certs: false
        status_code: [200]
      register: mac_addresses_raw
      ignore_errors: true
    - name: MAC-Adressen-Lookup-Tabelle bauen (id -> mac_address, Fallback)
      ansible.builtin.set_fact:
        mac_lookup: "{{ dict(mac_addresses_raw.json.results | map(attribute='id') | map('string')
                         | zip(mac_addresses_raw.json.results | map(attribute='mac_address'))) }}"
      when: mac_addresses_raw.json is defined and mac_addresses_raw.json.results is defined
    - name: Aktuelle Technitium-Scope-Konfiguration holen (inkl. reservedLeases)
      ansible.builtin.uri:
        url: "{{ technitium_url }}/api/dhcp/scopes/get"
        method: GET
        body_format: form-urlencoded
        body:
          token: "{{ technitium_token }}"
          name: "{{ technitium_scope_name }}"
        validate_certs: false
        status_code: [200]
      register: technitium_scope_raw
      no_log: true
    # -----------------------------------------------------------------
    # Push-Vorbereitung (noch kein Schreibzugriff)
    # -----------------------------------------------------------------
    - name: Ziel-Reservierungen filtern (IP innerhalb Ziel-VRF-Prefixe)
      ansible.builtin.set_fact:
        site_reservations: "{{ site_reservations | default([]) + [item] }}"
      loop: "{{ all_dhcp_reservations }}"
      loop_control:
        label: "{{ item.hostname }}"
      vars:
        record_ip: "{{ item.ipv4_address.address | ansible.utils.ipaddr('address') }}"
      when:
        - item.ipv4_address is defined
        - item.ipv4_address.address is defined
        - record_ip is ansible.utils.in_one_network target_prefixes
    # hw_address ist seit Plugin 0.1.10 ein verschachteltes Objekt mit
    # mac_address inline; nutze das direkt, mit Fallback auf mac_lookup.
    - name: Ziel-Reservierungen im Technitium-Format aufbauen
      ansible.builtin.set_fact:
        target_reserved_leases: "{{ target_reserved_leases | default([]) + [{
          'hostName': item.hostname,
          'address': item.ipv4_address.address | ansible.utils.ipaddr('address'),
          'hardwareAddress': (
            (item.hw_address.mac_address if (item.hw_address is mapping and item.hw_address.mac_address is defined)
             else mac_lookup[item.hw_address | string] | default('UNBEKANNT'))
            | replace(':', '-') | upper
          ),
          'comments': item.comments | default(None)
        }] }}"
      loop: "{{ site_reservations | default([]) }}"
      loop_control:
        label: "{{ item.hostname }}"
      when: >-
        item.hw_address is defined and
        ((item.hw_address is mapping and item.hw_address.mac_address is defined)
         or (item.hw_address is not mapping and (item.hw_address | string) in mac_lookup))
    - name: Reservierungen ohne aufgeloeste MAC warnen (werden NICHT gepusht)
      ansible.builtin.debug:
        msg: "WARNUNG: {{ item.hostname }} hat hw_address={{ item.hw_address | default('NULL') }}, keine MAC aufloesbar - wird uebersprungen"
      loop: "{{ site_reservations | default([]) }}"
      loop_control:
        label: "{{ item.hostname }}"
      when: >-
        not (item.hw_address is defined and
             ((item.hw_address is mapping and item.hw_address.mac_address is defined)
              or (item.hw_address is not mapping and (item.hw_address | string) in mac_lookup)))
    - name: Anzahl push-bereiter Reservierungen
      ansible.builtin.debug:
        msg: "{{ target_reserved_leases | default([]) | length }} von {{ site_reservations | default([]) | length }} push-bereit"
    - name: "DRY RUN - geplante reservedLeases-Liste anzeigen"
      ansible.builtin.debug:
        var: target_reserved_leases
      when: dry_run | bool
    - name: Bestehende Technitium-Reservierungen nach hardwareAddress indexieren
      ansible.builtin.set_fact:
        existing_leases_by_mac: "{{ dict(technitium_scope_raw.json.response.reservedLeases | map(attribute='hardwareAddress')
                                     | zip(technitium_scope_raw.json.response.reservedLeases)) }}"
    - name: Aktionsplan bauen (neu / aendern / unveraendert)
      ansible.builtin.set_fact:
        lease_actions: "{{ lease_actions | default([]) + [{
          'mac': item.hardwareAddress,
          'target': item,
          'existing': existing_leases_by_mac.get(item.hardwareAddress),
          'action': ('unveraendert'
                     if (existing_leases_by_mac.get(item.hardwareAddress) is not none and
                         existing_leases_by_mac[item.hardwareAddress].address == item.address and
                         existing_leases_by_mac[item.hardwareAddress].hostName == item.hostName)
                     else ('aendern' if existing_leases_by_mac.get(item.hardwareAddress) is not none else 'neu'))
        }] }}"
      loop: "{{ target_reserved_leases | default([]) }}"
      loop_control:
        label: "{{ item.hostName }}"
        loop_var: item
    - name: Zusammenfassung des Aktionsplans
      ansible.builtin.debug:
        msg: >-
          {{ lease_actions | selectattr('action', 'equalto', 'neu') | list | length }} neu,
          {{ lease_actions | selectattr('action', 'equalto', 'aendern') | list | length }} aendern,
          {{ lease_actions | selectattr('action', 'equalto', 'unveraendert') | list | length }} unveraendert
    - name: "DRY RUN - Details je geplanter Aktion"
      ansible.builtin.debug:
        msg: >-
          [{{ item.action | upper }}] {{ item.target.hostName }}
          ({{ item.mac }}) -> {{ item.target.address }}
          {{ '(vorher: ' ~ item.existing.hostName ~ ' -> ' ~ item.existing.address ~ ')' if item.action == 'aendern' else '' }}
      loop: "{{ lease_actions | rejectattr('action', 'equalto', 'unveraendert') | list }}"
      loop_control:
        label: "{{ item.target.hostName }}"
      when: dry_run | bool
    - name: Bestehende Reservierung entfernen vor Aenderung (Remove-vor-Add)
      ansible.builtin.uri:
        url: "{{ technitium_url }}/api/dhcp/scopes/removeReservedLease"
        method: POST
        body_format: form-urlencoded
        body:
          token: "{{ technitium_token }}"
          name: "{{ technitium_scope_name }}"
          hardwareAddress: "{{ item.mac }}"
        validate_certs: false
        status_code: [200]
      loop: "{{ lease_actions | selectattr('action', 'equalto', 'aendern') | list }}"
      loop_control:
        label: "{{ item.target.hostName }}"
      no_log: true
      register: remove_result
      when: not (dry_run | bool)
    - name: Reservierung anlegen (neu oder nach Remove bei Aenderung)
      ansible.builtin.uri:
        url: "{{ technitium_url }}/api/dhcp/scopes/addReservedLease"
        method: POST
        body_format: form-urlencoded
        body:
          token: "{{ technitium_token }}"
          name: "{{ technitium_scope_name }}"
          hardwareAddress: "{{ item.mac }}"
          ipAddress: "{{ item.target.address }}"
          hostName: "{{ item.target.hostName }}"
          comments: "{{ item.target.comments | default('') }}"
        validate_certs: false
        status_code: [200]
      loop: "{{ lease_actions | rejectattr('action', 'equalto', 'unveraendert') | list }}"
      loop_control:
        label: "{{ item.target.hostName }}"
      no_log: true
      register: add_result
      ignore_errors: true
      when: not (dry_run | bool)
    - name: Fehlgeschlagene Add-Aktionen auflisten
      ansible.builtin.debug:
        msg: "FEHLER bei {{ item.item.target.hostName }}: {{ item.msg | default('unbekannt') }}"
      loop: "{{ add_result.results | default([]) }}"
      loop_control:
        label: "{{ item.item.target.hostName }}"
      when:
        - not (dry_run | bool)
        - item.failed | default(false)
und kommentartechnisch ein bisschen gestrafft. Ich bin wegen der Fragilität meines aktuellen Setups etwas unglücklich. Ich werde die nächsten Tage ein paar alternative Ansätze bei dem Skript testen, die hoffentlich etwas robuster sind. Bei Netbox sind beim letzten Update diverse neue Felder hinzugekommen, das muss ich mir aber zunächst in Ruhe ansehen.
Nachtrag: Dafür wollte ich keinen eigenen neuen Blogpost erstellen, aber ich habe grade gesehen, dass es in Semaphore UI scheinbar als neues Feature sogenannte Workflows gibt –>
Das sieht einem Blatt bei NodeRed verdächtig ähnlich. Damit ließen sich anschaulich verschiedene Playbooks miteinander verknüpfen bzw. aneinanderreihen, ggf sogar verschiedene Wege je nach Ausgabe wählen. Das sieht jedenfalls äußerst spannend aus und könnte meinen bisherigen Ansatz ganz erheblich vereinfachen. Man könnte die einzelnen Arbeitsschritte in einzelne Skripte modularisieren und durch Aneinanderreihung miteinander verknüpfen. Das wäre wesentlich einfacher zu warten, als ein monolithisches Skript das mit der Zeit immer größer und fehleranfälliger wird.
11:00:08 AM
fatal: [localhost]: FAILED! => {"msg": "failed to transfer file to /root/.ansible/tmp/ansible-tmp-1788598808.745682-600055-252320871827258/AnsiballZ_uri.py: [Errno 28] No space left on device: b'/opt/semaphore/tmp/project_2/repository_1_template_7_home/.ansible/tmp/ansible-local-599946yh9hvxgy/tmp9rlk1asu' -> b'/root/.ansible/tmp/ansible-tmp-1788598808.745682-600055-252320871827258/AnsiballZ_uri.py'"}
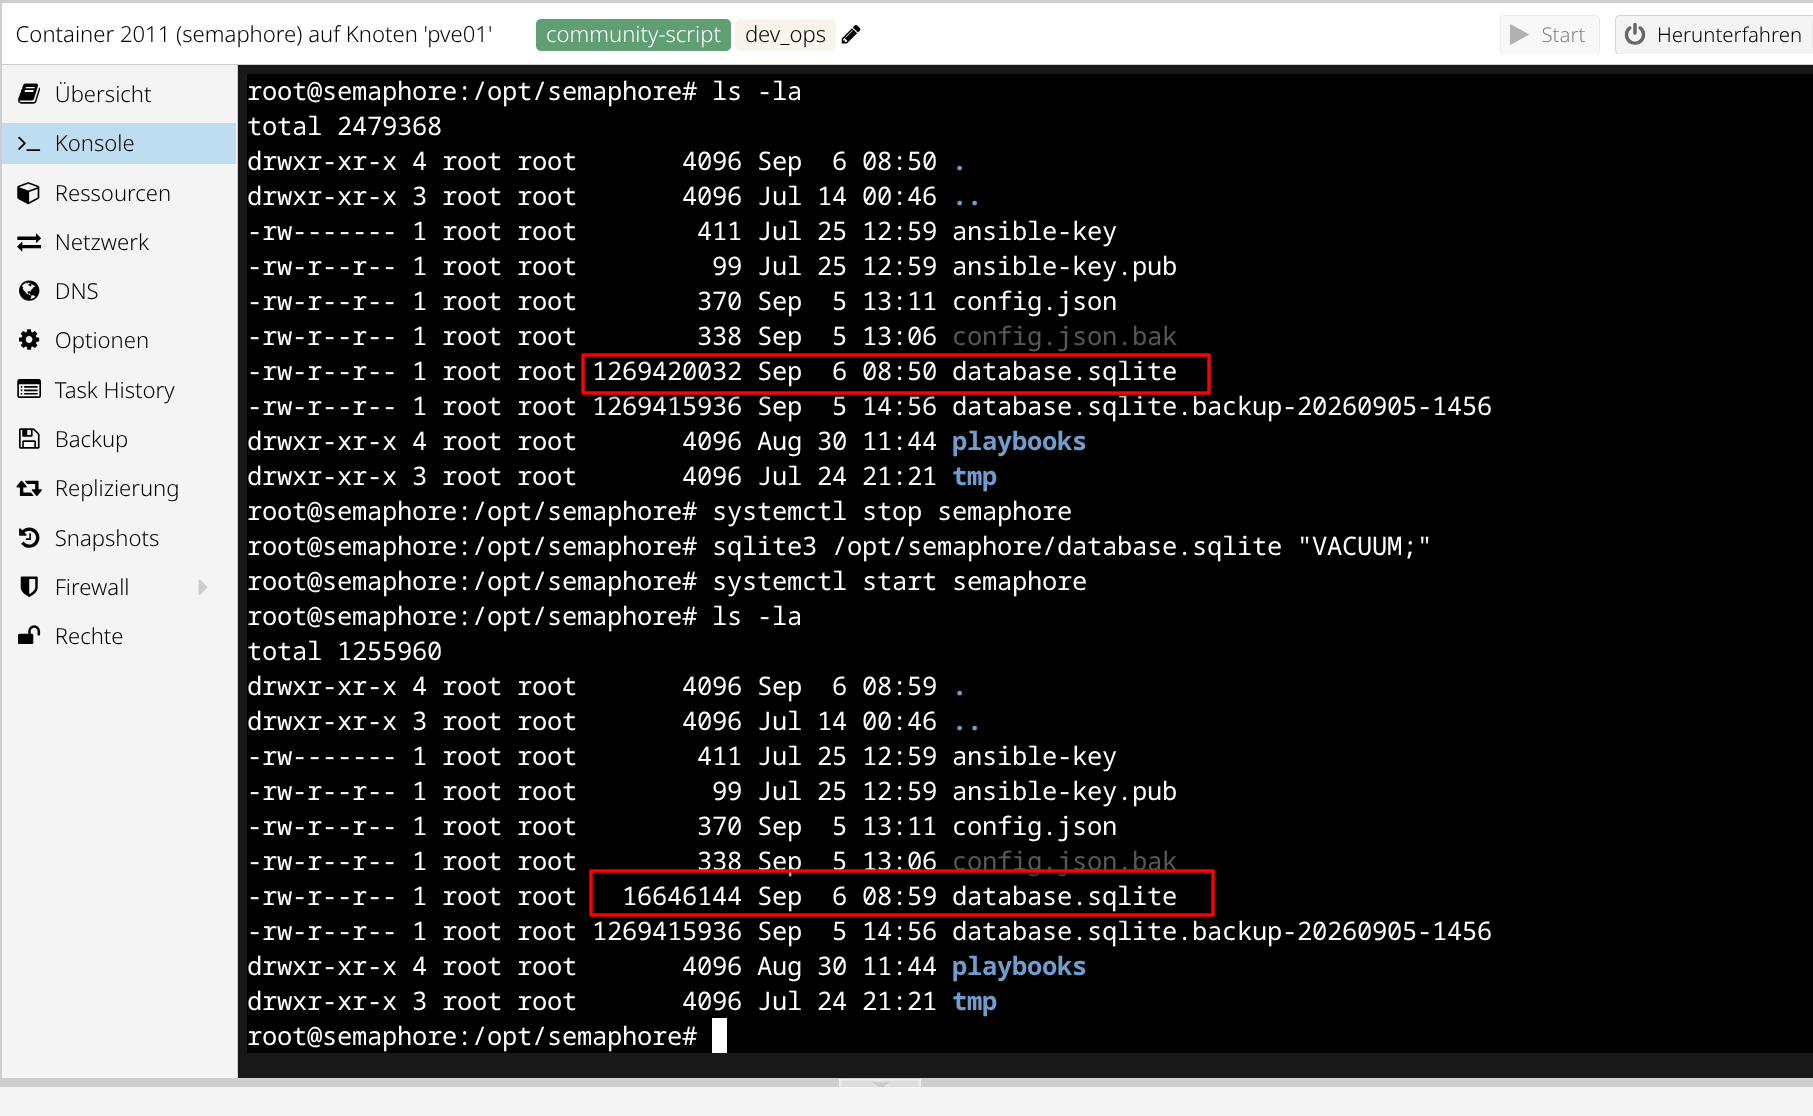
Das LXC war schlicht vollgelaufen. Als Schuldigen habe ich /opt/semaphore/database.sqlite ausgemacht. Die Datenbank ist auf 1,2gb angewachsen. Jeder Durchlauf der Templates wird scheinbar in der Datenbank gespeichert. Notfallmäßig habe ich das Semaphore LXC zunächst um 4GB vergrößert. Um die Datenbank automatisch aufzuräumen, muss man die config.json von Semaphore etwas ergänzen.
die neue Zeile “max_tasks_per_template”: 30, regelt, das nur die letzten 30 Durchläufe aufbewahrt werden. Man muss den Dienst semaphore nach dem Ändern der Config neu starten
Nachtrag: Ich habe den Wert inzwischen auf 670 gesetzt, das entspricht bei meinen Logs derzeit in etwa 7 Tage. 30 ist viel zu wenig.
systemctl restart semaphore
Die GUI ist danach erst mal nicht mehr erreichbar. Via Proxmox Shell komme ich noch auf das LXC. Neben der database.sqlite ist eine neue Datei erschienen mit dem Namen database.sqlite-journal
Es müssen zahlreiche Einträge gelöscht werden und für ein eventuelles Recovery wird eine solche Sicherungsdatei angelegt. Sobald der Löschvorgang abgschlossen ist, verschwindet auch die database.sqlite-journal wieder. In meinem Fall hätte ich ohne Vergößerung des LXCs auch nichts löschen können, da die Recoverydatei ja auch Platz bekegt. Man muss also den o.g. Mechanismus direkt nach der Installation des Semaphore LXCs aktivieren, um das Semaphore LXC dauerhaft schlank zu halten. Der Löschprozess hat bei mir seeehr lange gedauert. Danach ist die database.sqlite immer noch 1,2gb groß, allerdings sind das nur leere Seiten. Endgültig los wird man die leeren Seiten erst durch einen Eingriff in sqlite. Dazu muss der o.g. Löschprozess zuerst abgeschlossen sein und der semaphore Dienst angehalten werden
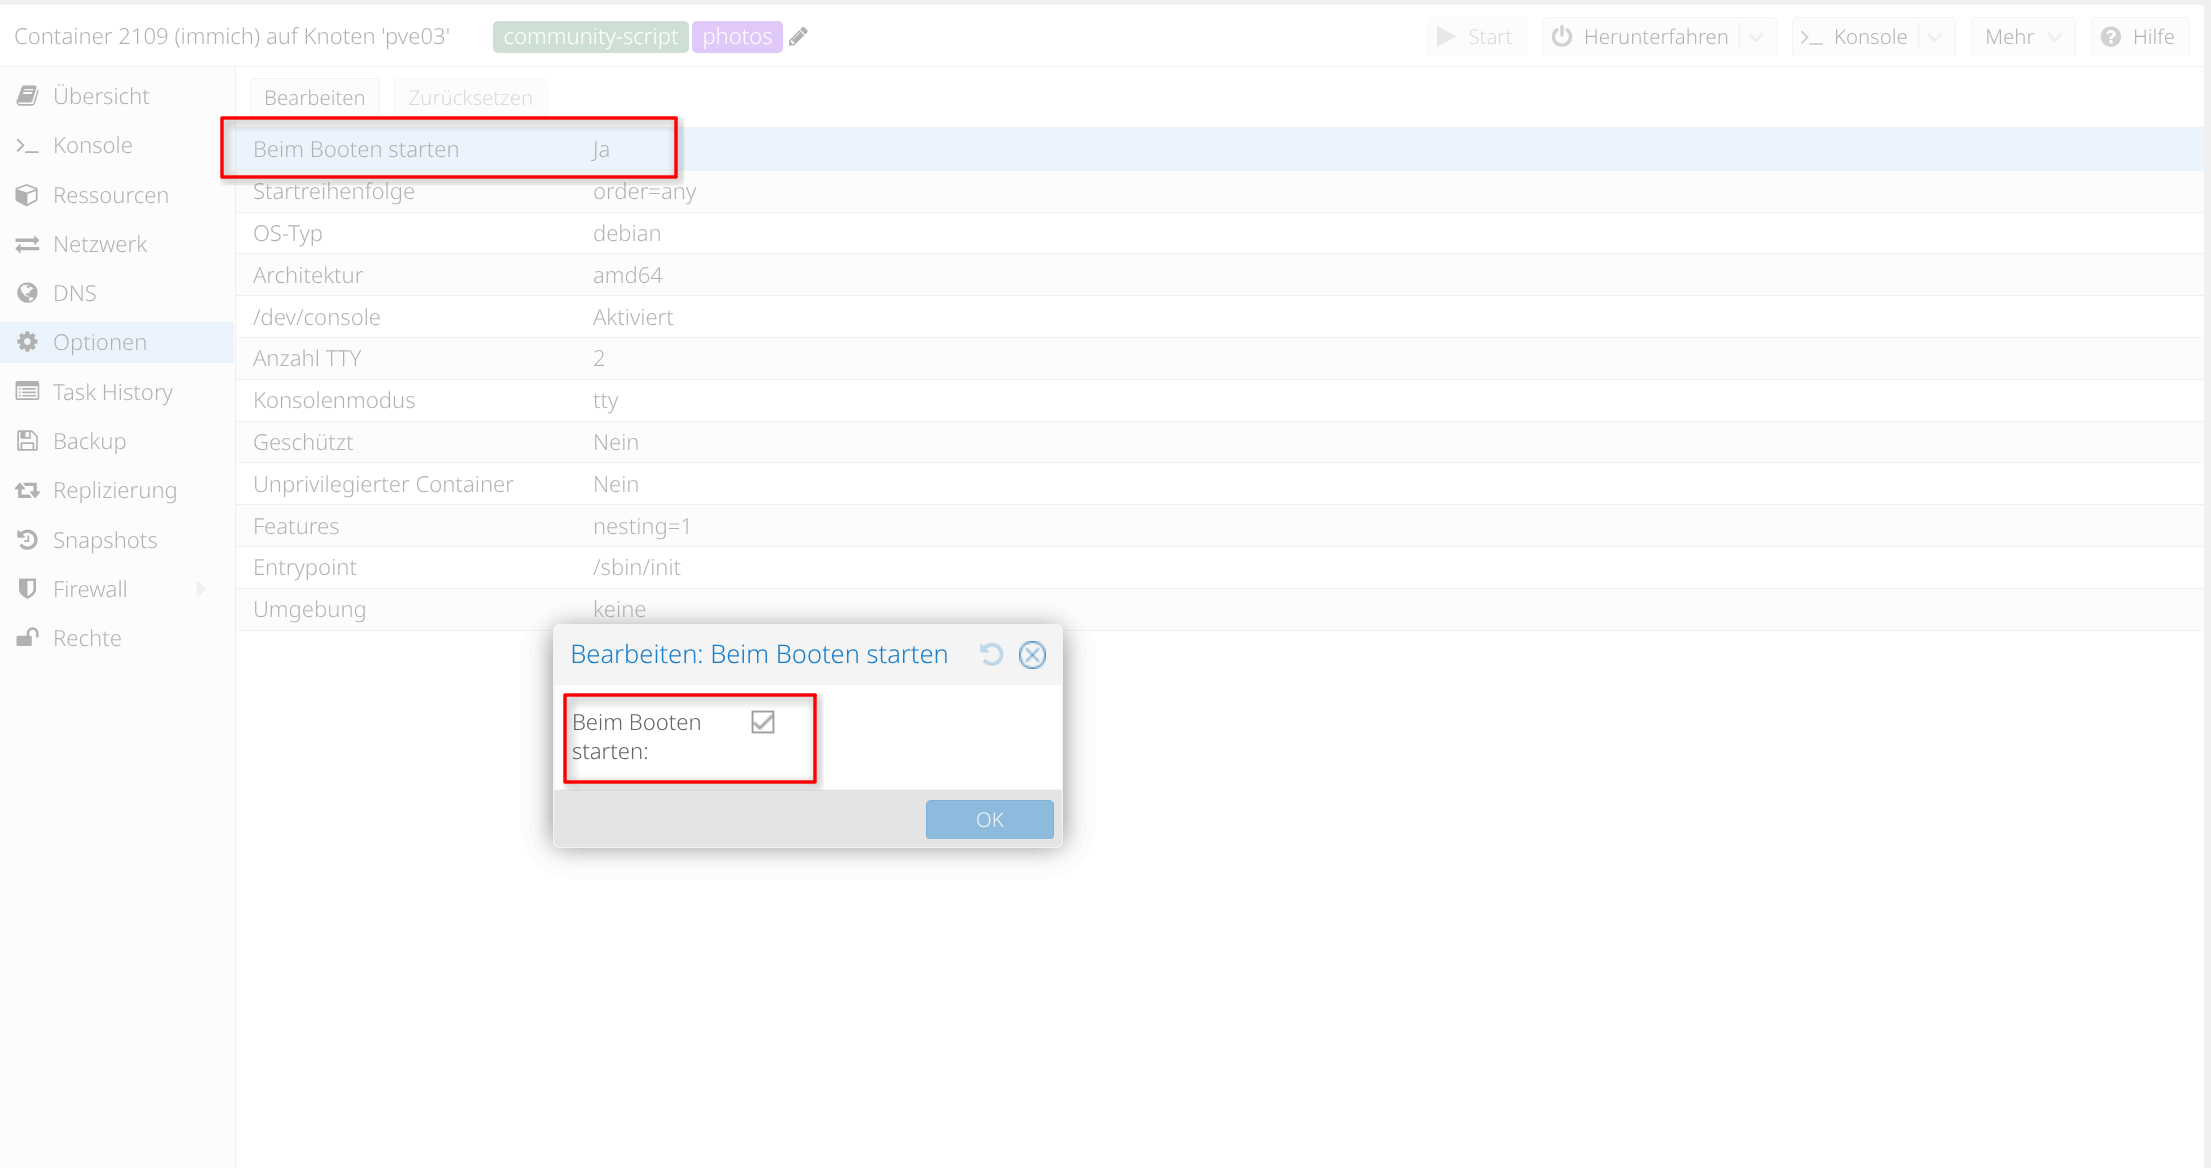
Manchmal möchte ich nach einem Reboot eines PVE Hosts nicht, dass die VMs und LXCs automatisch hochgefahren werden. Ich habe bisher vor so einem Reboot immer den Autostart Haken bei jedem einzelnen LXC und VM entfernen und später wieder setzen müssen.
Das wollte ich unbedingt vereinfachen und gleichzeitig die jeweils aktuellen Settings der einzelnen VMs und LXCs nach Netbox synchronisieren. In diesem Fall dienen tatsächlich die jeweiligen PVE Hosts als “source of truth” für Netbox. Ich habe mir ausserdem das Leben etwas leichter gemacht, indem ich VSCodium (Opensource Alternative zu VSCode von M$) mit zwei praktischen Plugins nachgerüstet habe –> 1. Open Remote - SSH und 2. YAML. Open Remote - SSH macht entfernte Dateisysteme auf dem lokalen Rechner via ssh in VSCodium zugänglich und YAML hilft dabei keine Fehler z.B. bei den Leerzeichen in den Playbooks zu machen. Die Einrichtung erkläre ich hier nicht, das sollte jeder mit dem bereits vorhandenen Material selbst hinkriegen können. VSCodium kann nativ mit git commits umgehen, das macht das Anlegen und V.a. das Ändern von Playbooks wesentlich komfortabler.
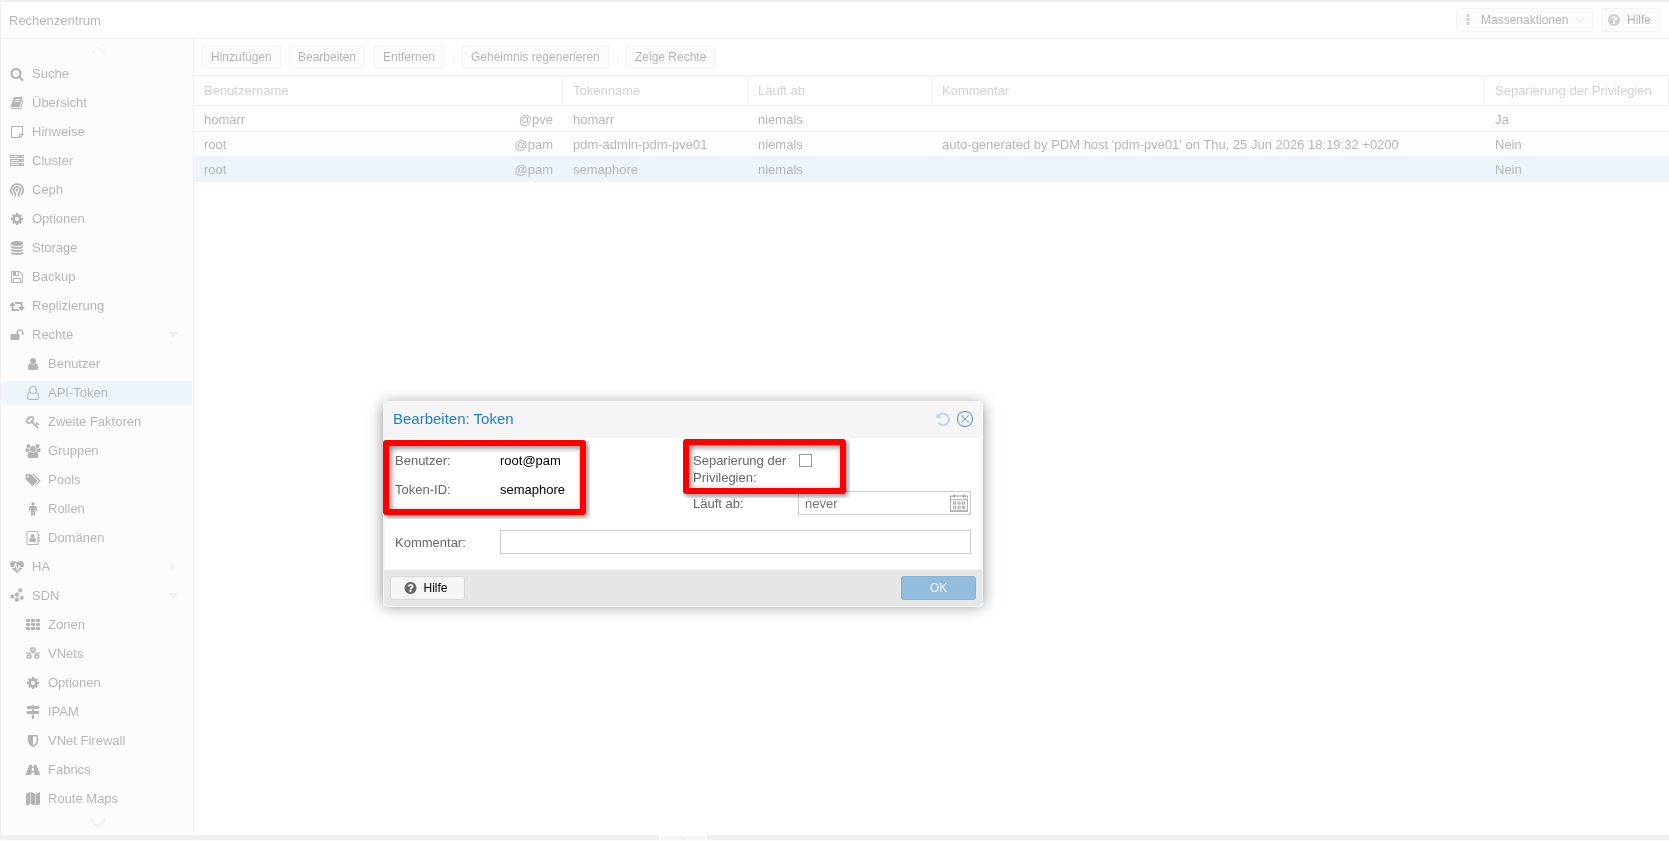
An den PVE Hosts die ferngesteuert und abgefragt werden sollen, müssen noch API Token generiert werden. Bei mir zuhause sind das zwei PVE Hosts, jeweils standalone. Ich muss also zwei API Token generieren. Der Token wird nur einmal, direkt nach dem Erzeugen angezeigt, es empfiehlt sich daher den Token an einem sicheren Ort (Passwortmanager) zu speichern.
Bei den Playbooks habe ich ein neues yml File angelegt mit folgendem Inhalt:
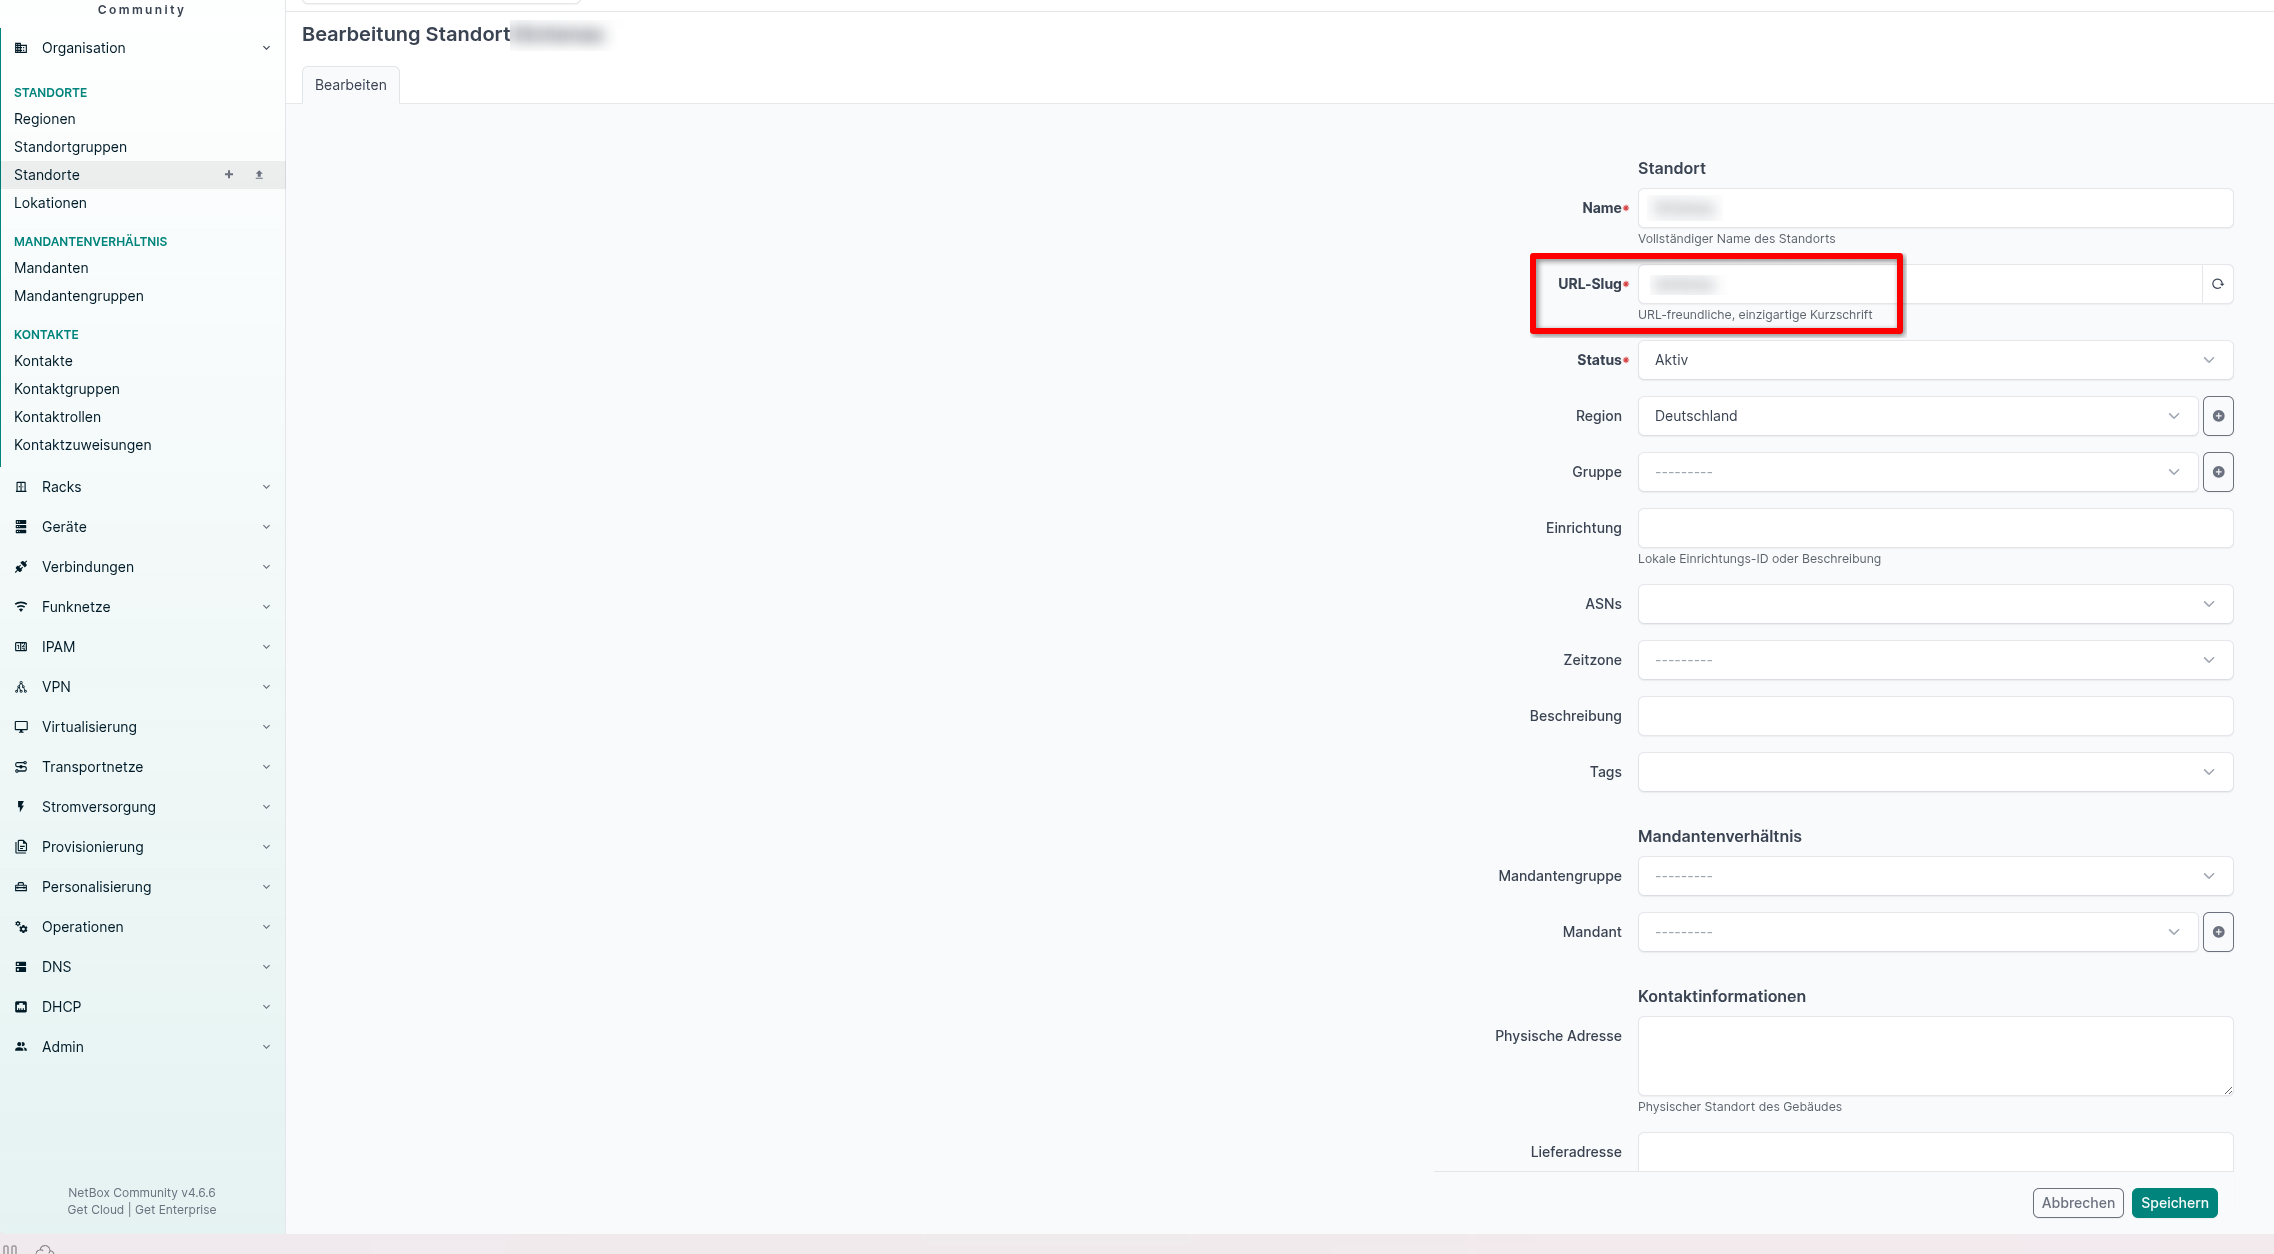
den “slug” sieht man am Standort wenn man auf Bearbeiten klickt. Da ich meinen Wohnrt nicht im Internet teilen möchte, habe ich die Felder verpixelt. In meinem Fall sind zwei PVE Hosts vorhanden und deren beiden IPs sind hart in das Skript kodiert. Wer das Skript verwenden möchte muss es an die eigene Situation anpassen.
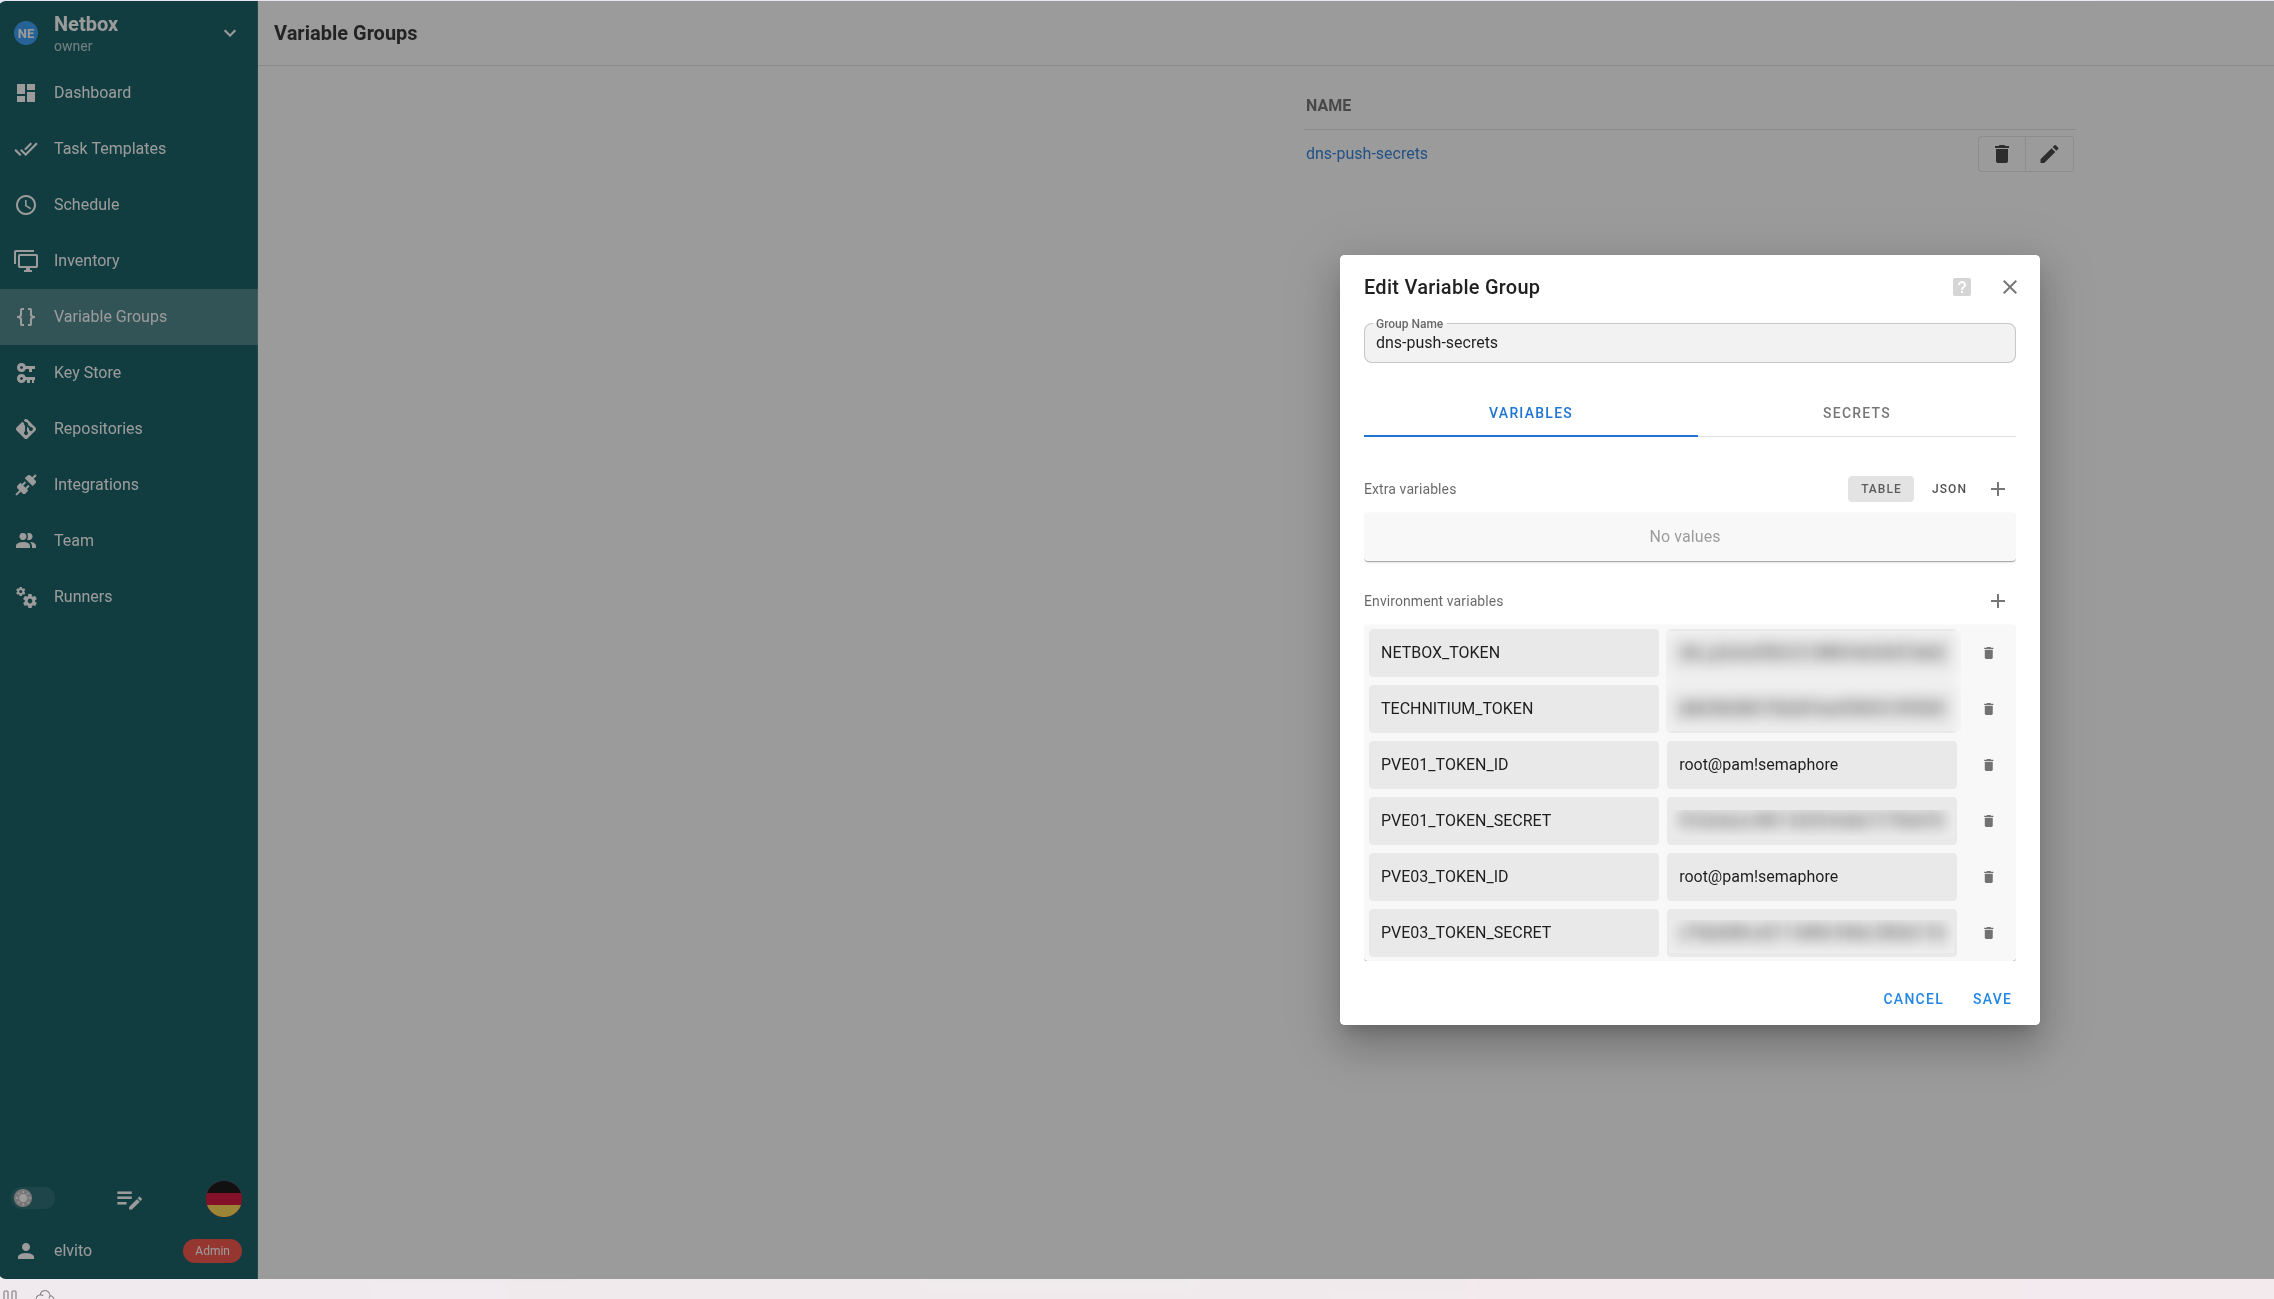
Aus Faulheitsgründen habe ich die vorher erzeugten PVE Token einfach in das Variablenfile der dns-push skripte dazugepackt. Man könnte das natürlich auch trennen, hat beides Vor- und Nachteile…
Dem bereits vorhandenen Netbox Token habe ich nachträglich noch Scheibrechte eingeräumt (geht nachträglich über die GUI), sonst ließen sich keine Werte (vCPU, RAM etc.) aus PVE in Netbox schreiben. Zum Schluss noch das neue Playbook via Template in Semaphore einfügen.
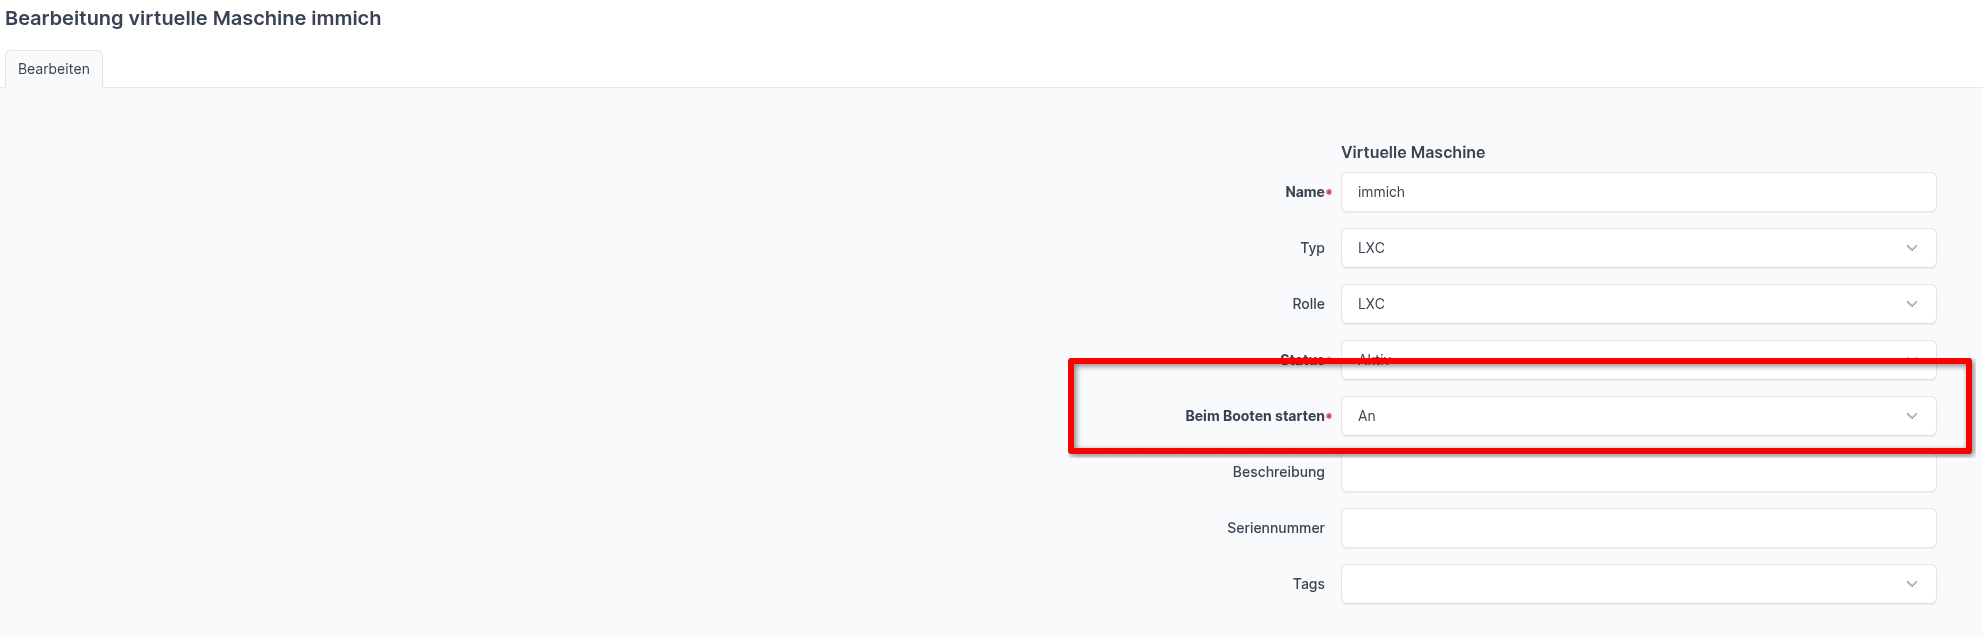
Die virtuellen Maschinen kennen bei Netbox bereits ein Feld für den Zustand nach Reboot
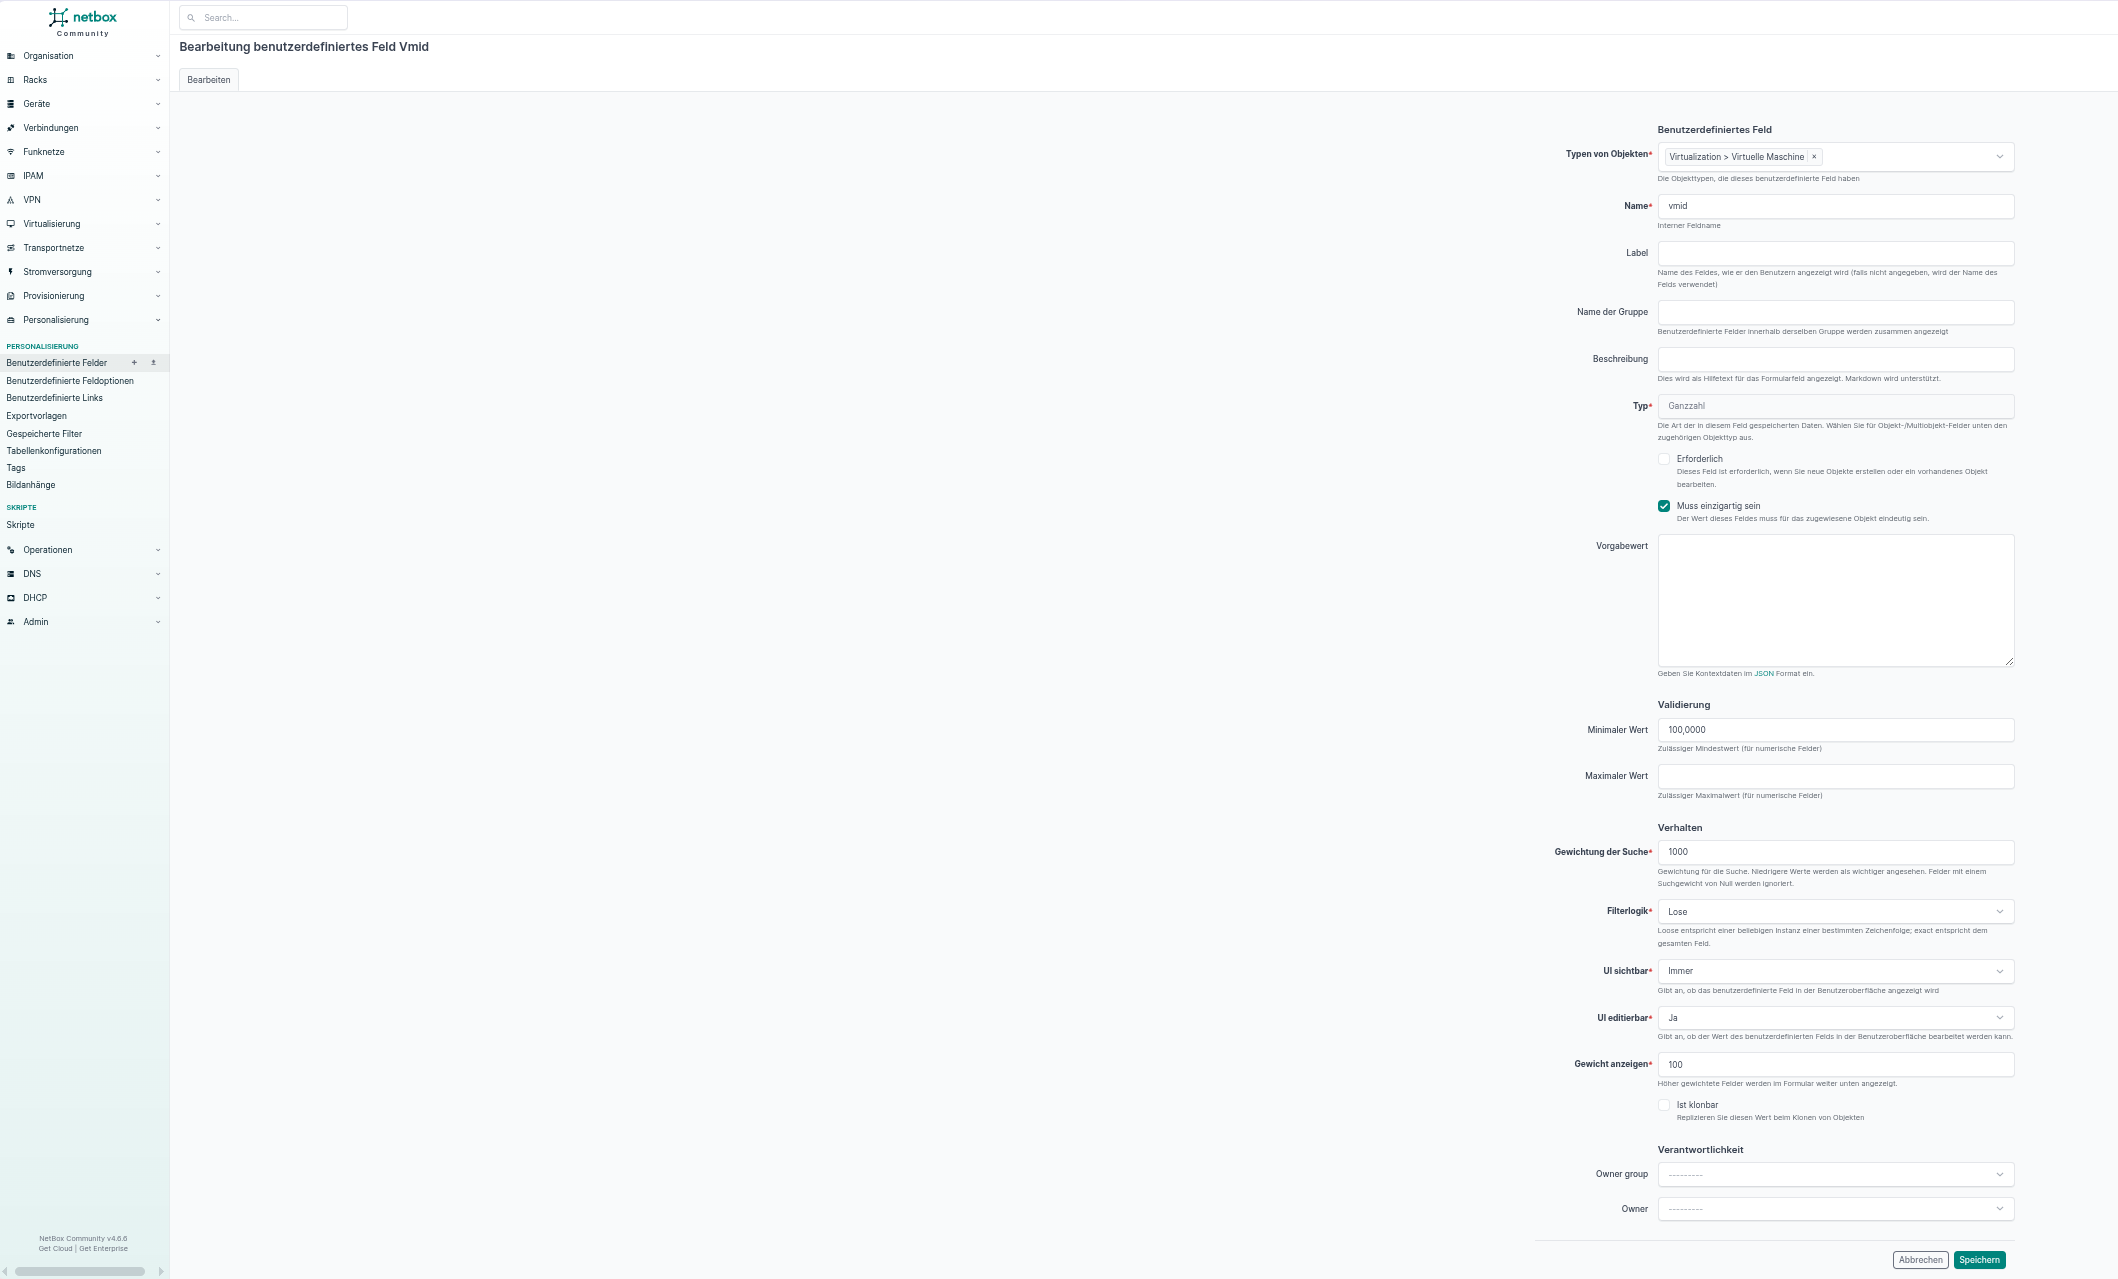
Bei PVE wird als “Primary Key” zur Identifikation die sogenannte VMID verwendet. Dafür gibt es (noch) kein Feld bei Netbox. Nachdem man das neue Feld erzeugt hat, muss man es noch für jede virtuelle Instanz manuell befüllen. Nur LXCs und VMs die in Netbox manuell eine solche vmid zugewiesen bekommen haben, werden von obigen Skript auch berücksichtigt, der Rest wird ignoriert.
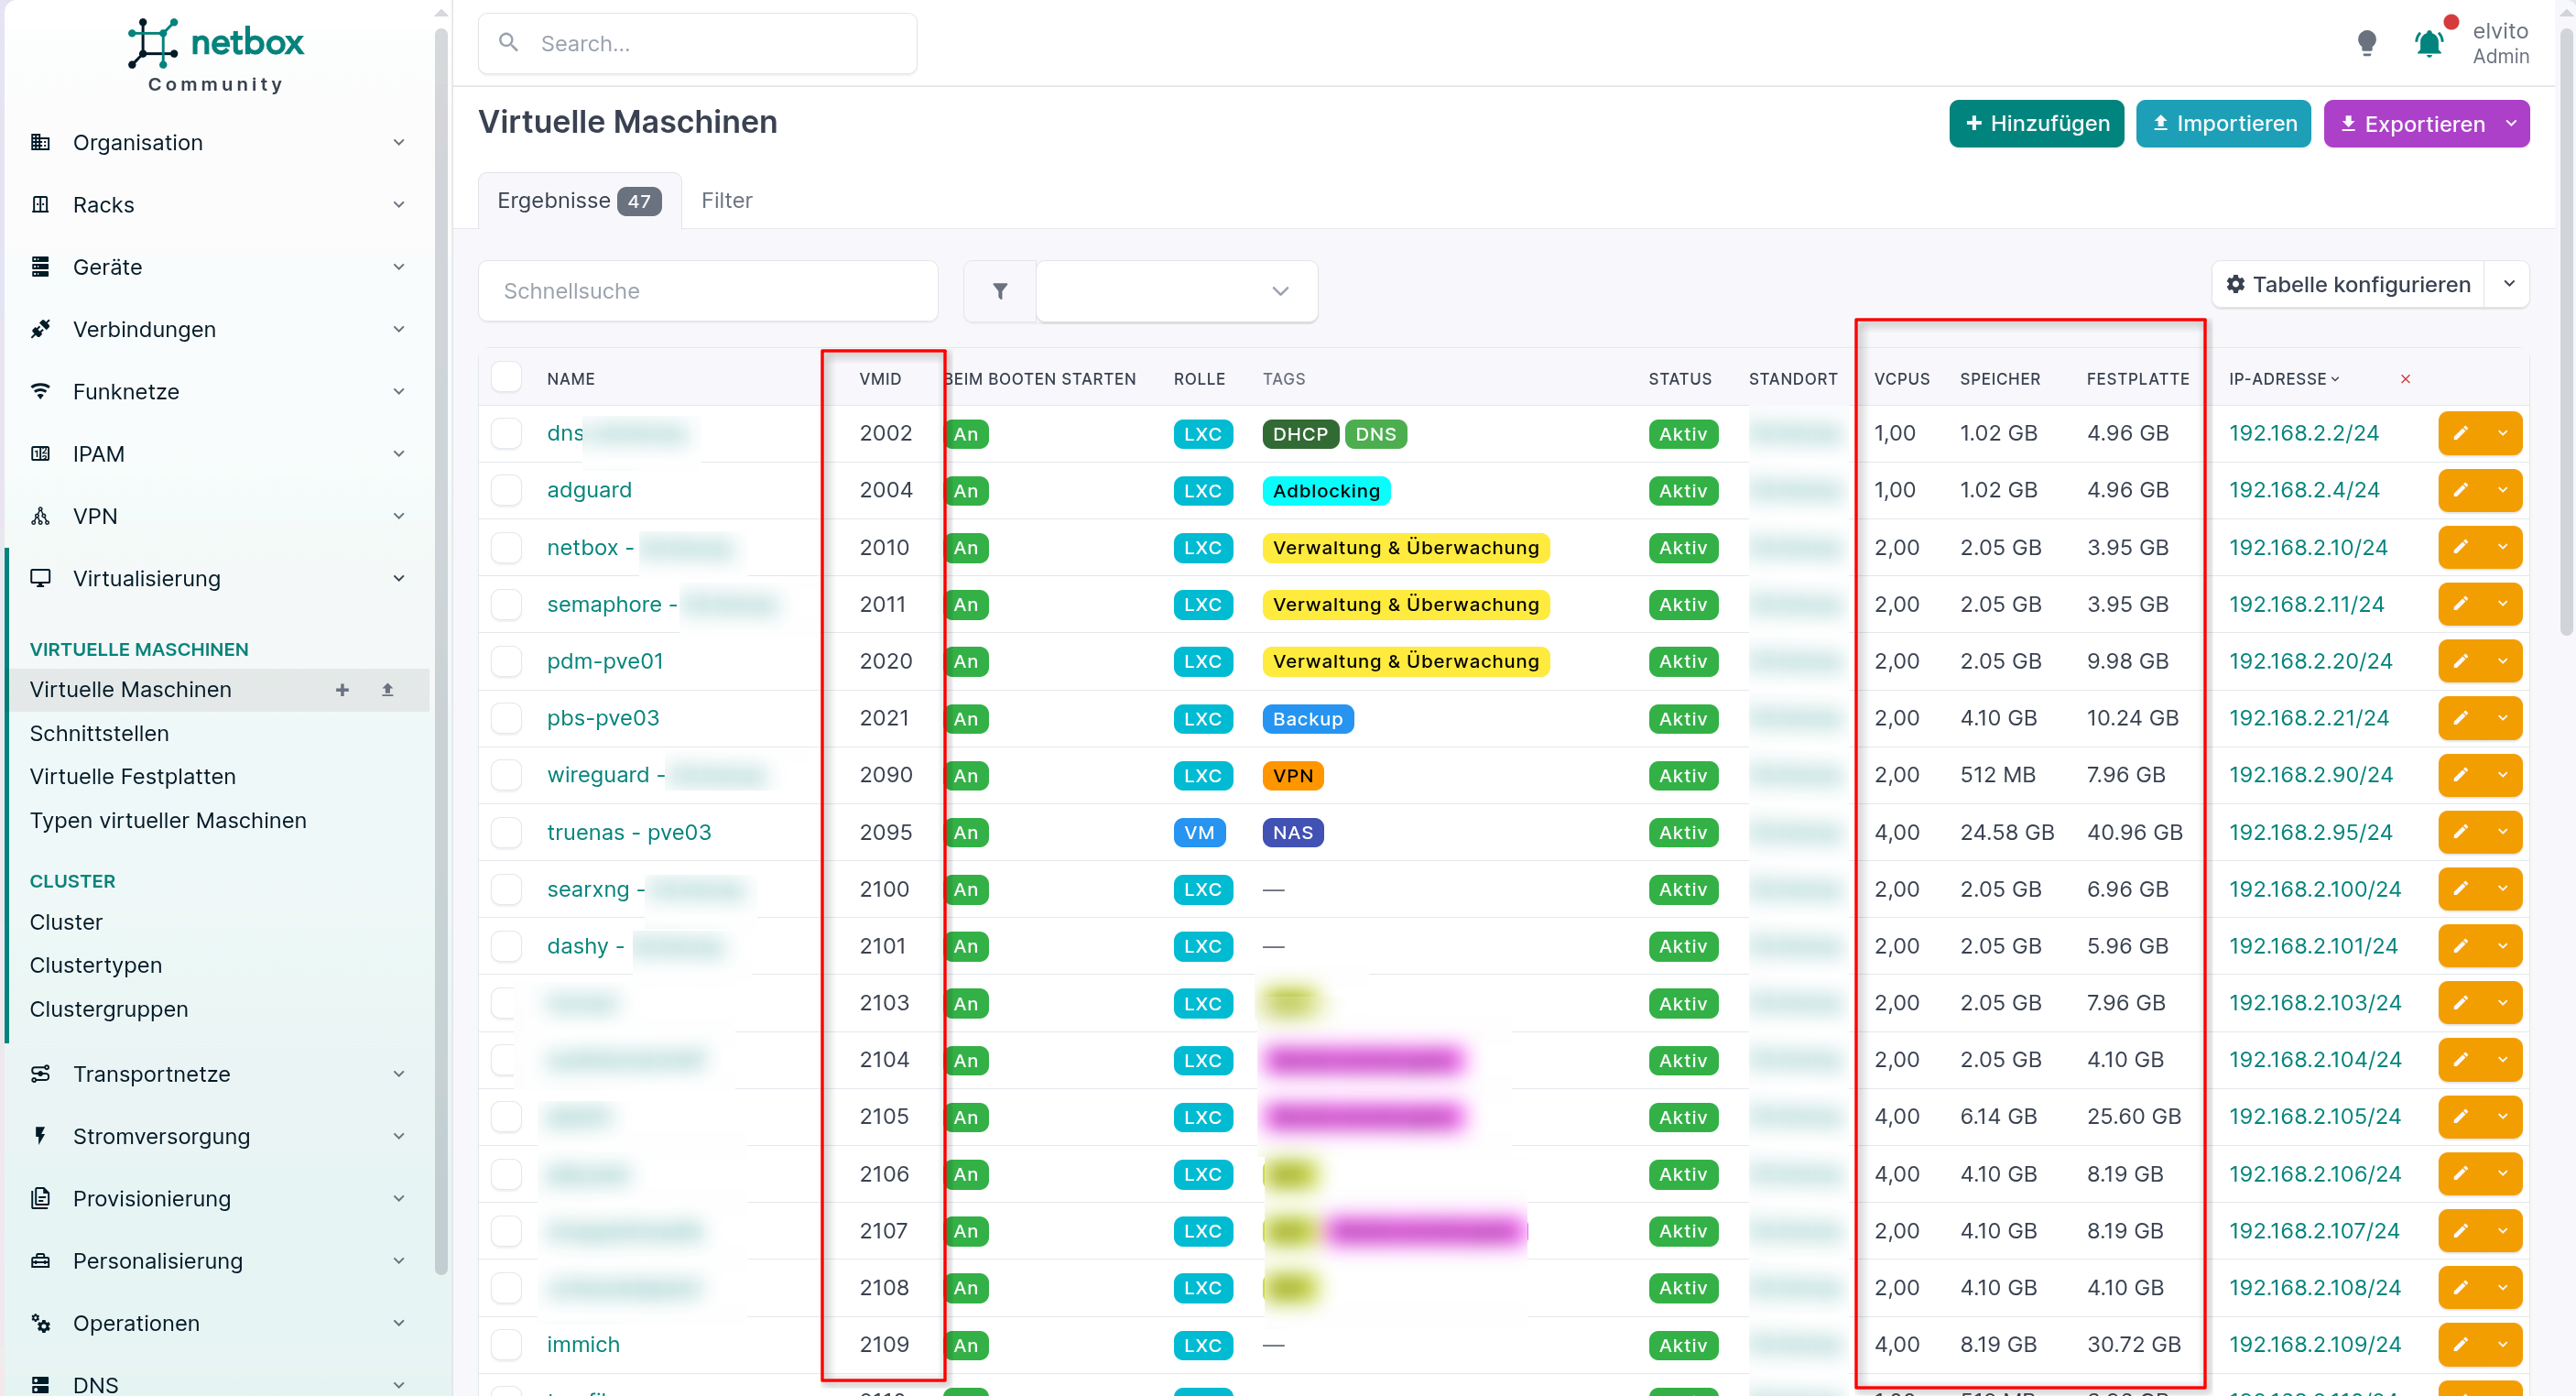
Nachdem ich das Skript ein paar mal getestet hatte, habe ich einen cronjob alle 10 Minuten dafür eingerichtet, das geht in Semaphore ja auch über die GUI. Ich kann jetzt zentral in Netbox das Verhalten aller virtuellen Instanzen nach einem Reboot des jeweiligen PVE Hosts steuern. Im gleichen Schritt werden die Werte für vCPU, RAM etc von den virtuellen Instanzen ausgelesen und in Netbox synchronisiert. Netbox tut sich etwas schwer mit der Umrechnung (Bei Netbox sind 1000MB ein GB und nicht 1024MB wie es richtig wäre), das stört mich aber nicht weiter. Der große Vorteil dabei ist nun, dass ich das Rebootverhalten nun auch massenhaft ändern kann und ich mich nicht mehr einzeln durchklicken muss.
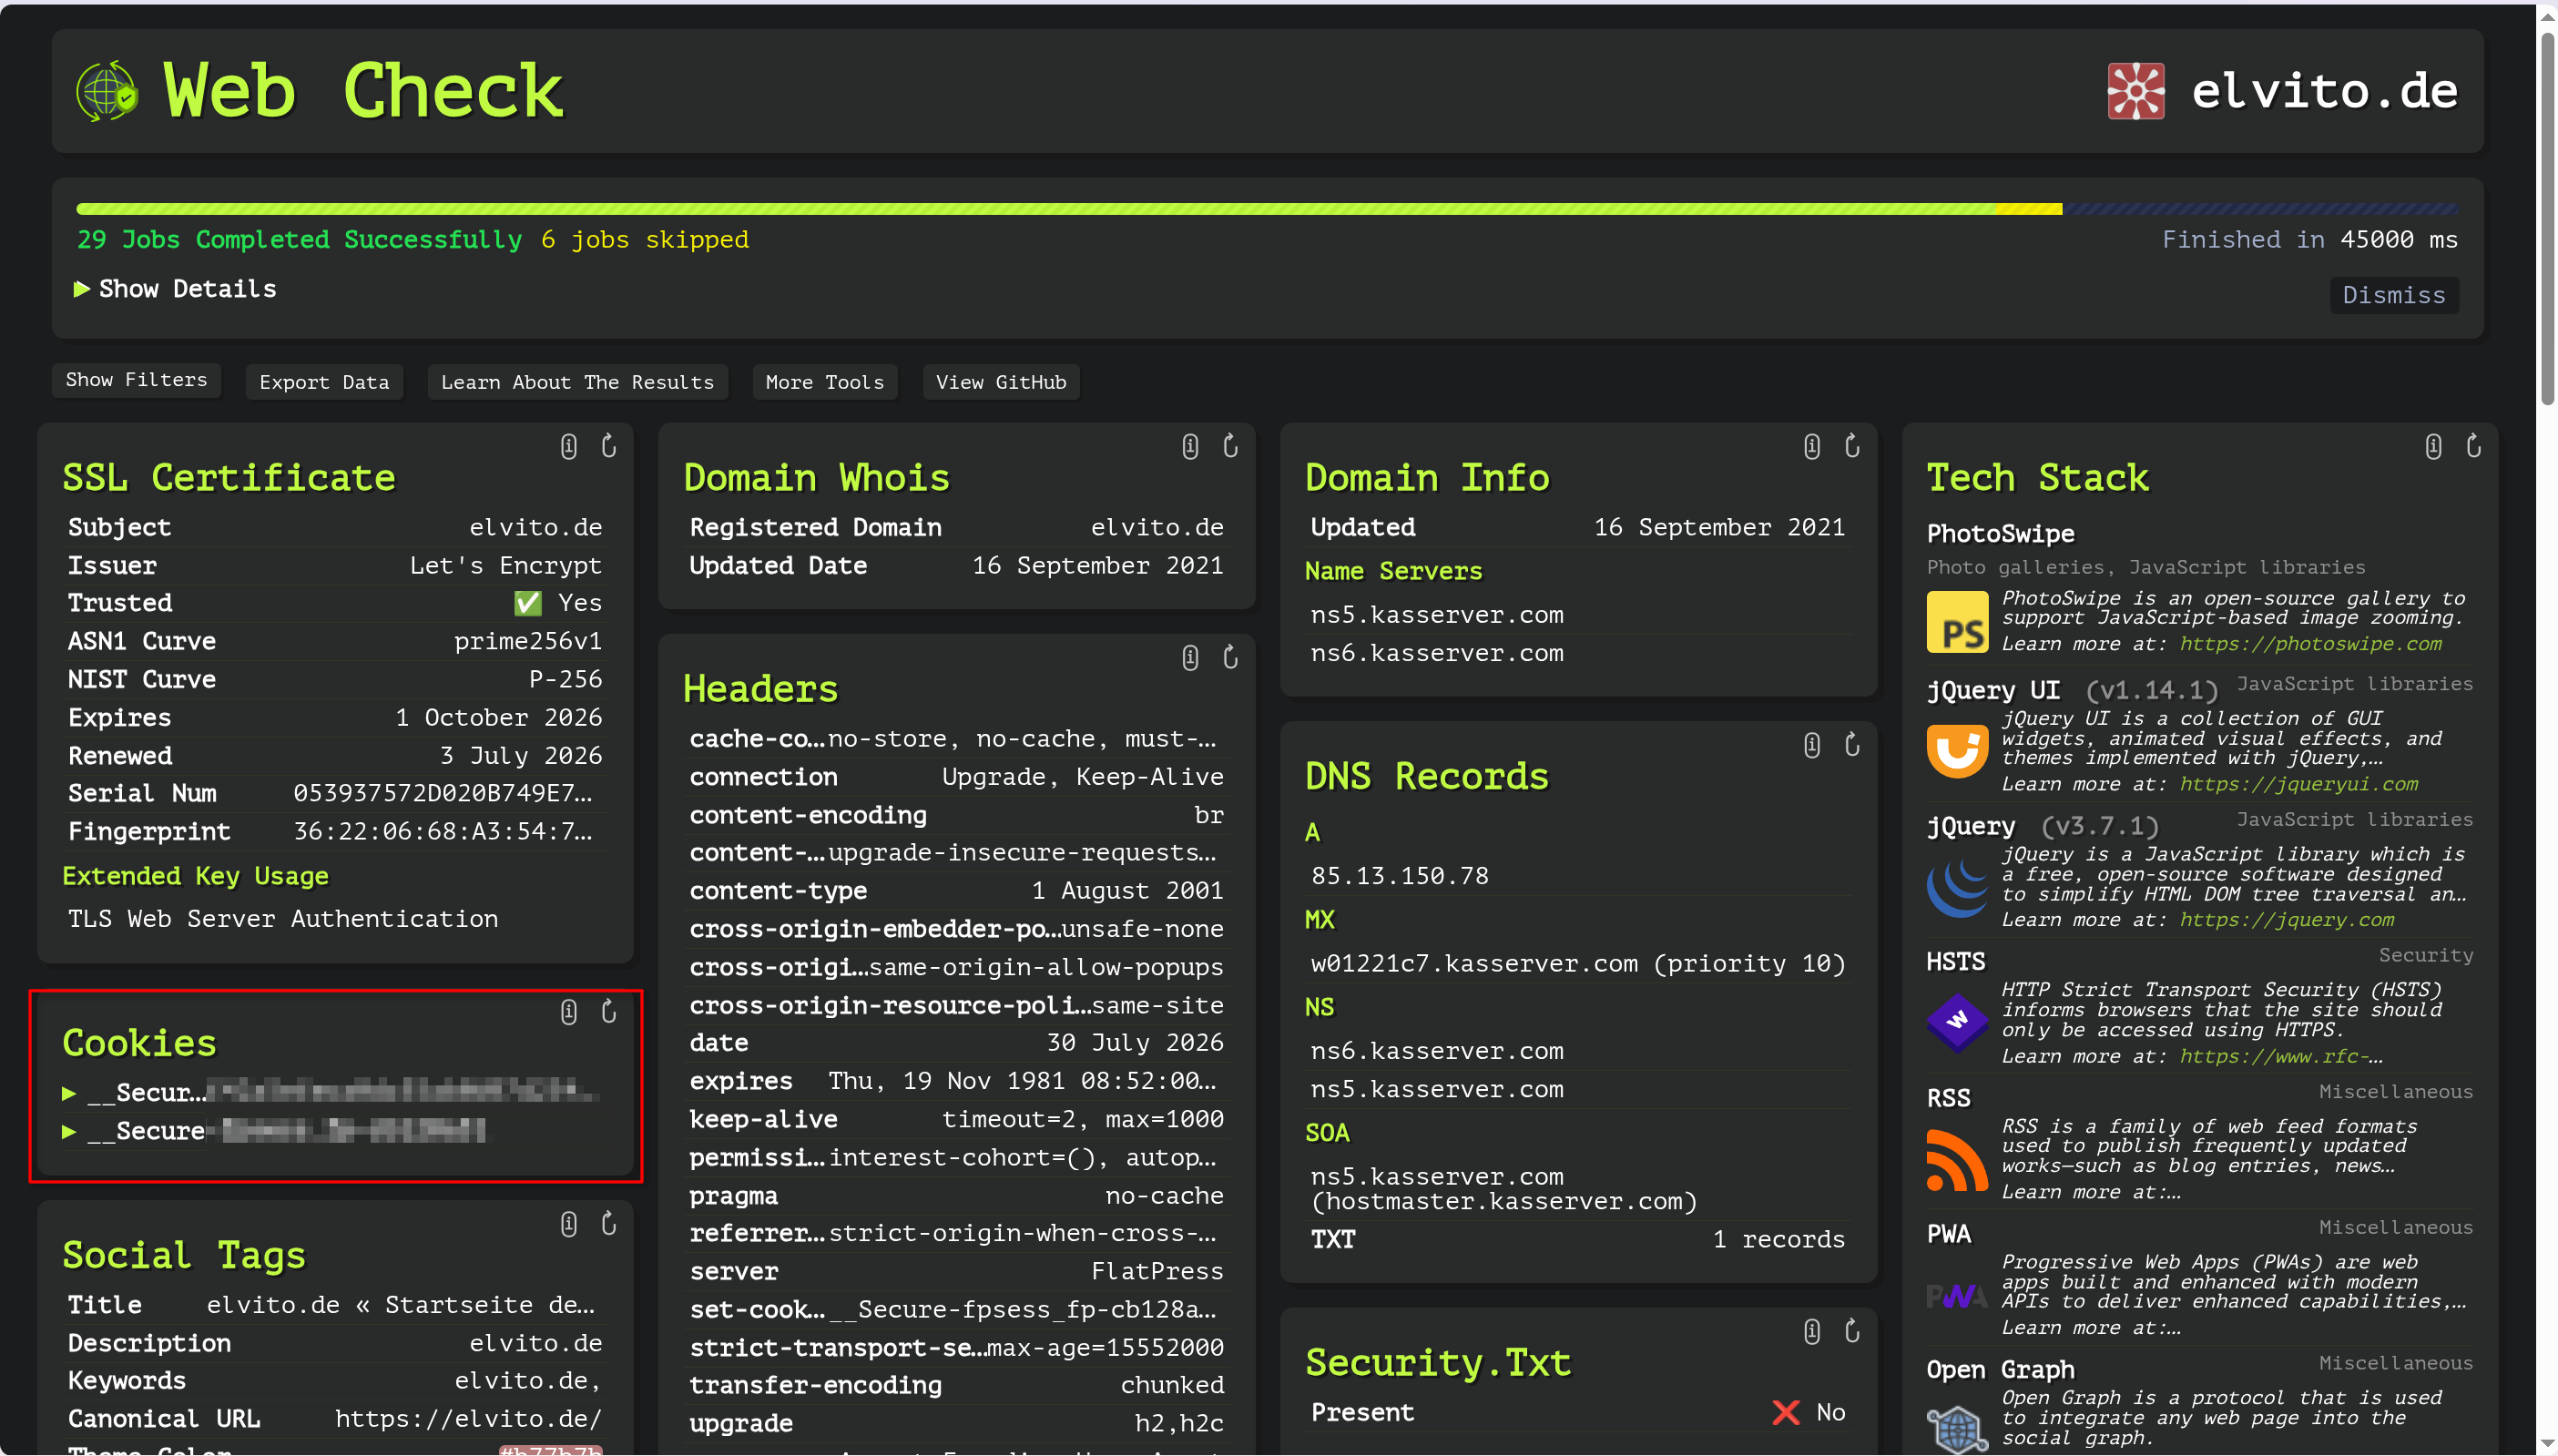
lissy93 hat bereits das fantastische Tool dashy geschrieben. Beim Stöbern in ihren GitHub-Repos hab ich noch ein weiteres überaus interessantes Tool namens web-check gefunden. Es gibt sogar ein Installskript bei den Community-Scripts dafür.
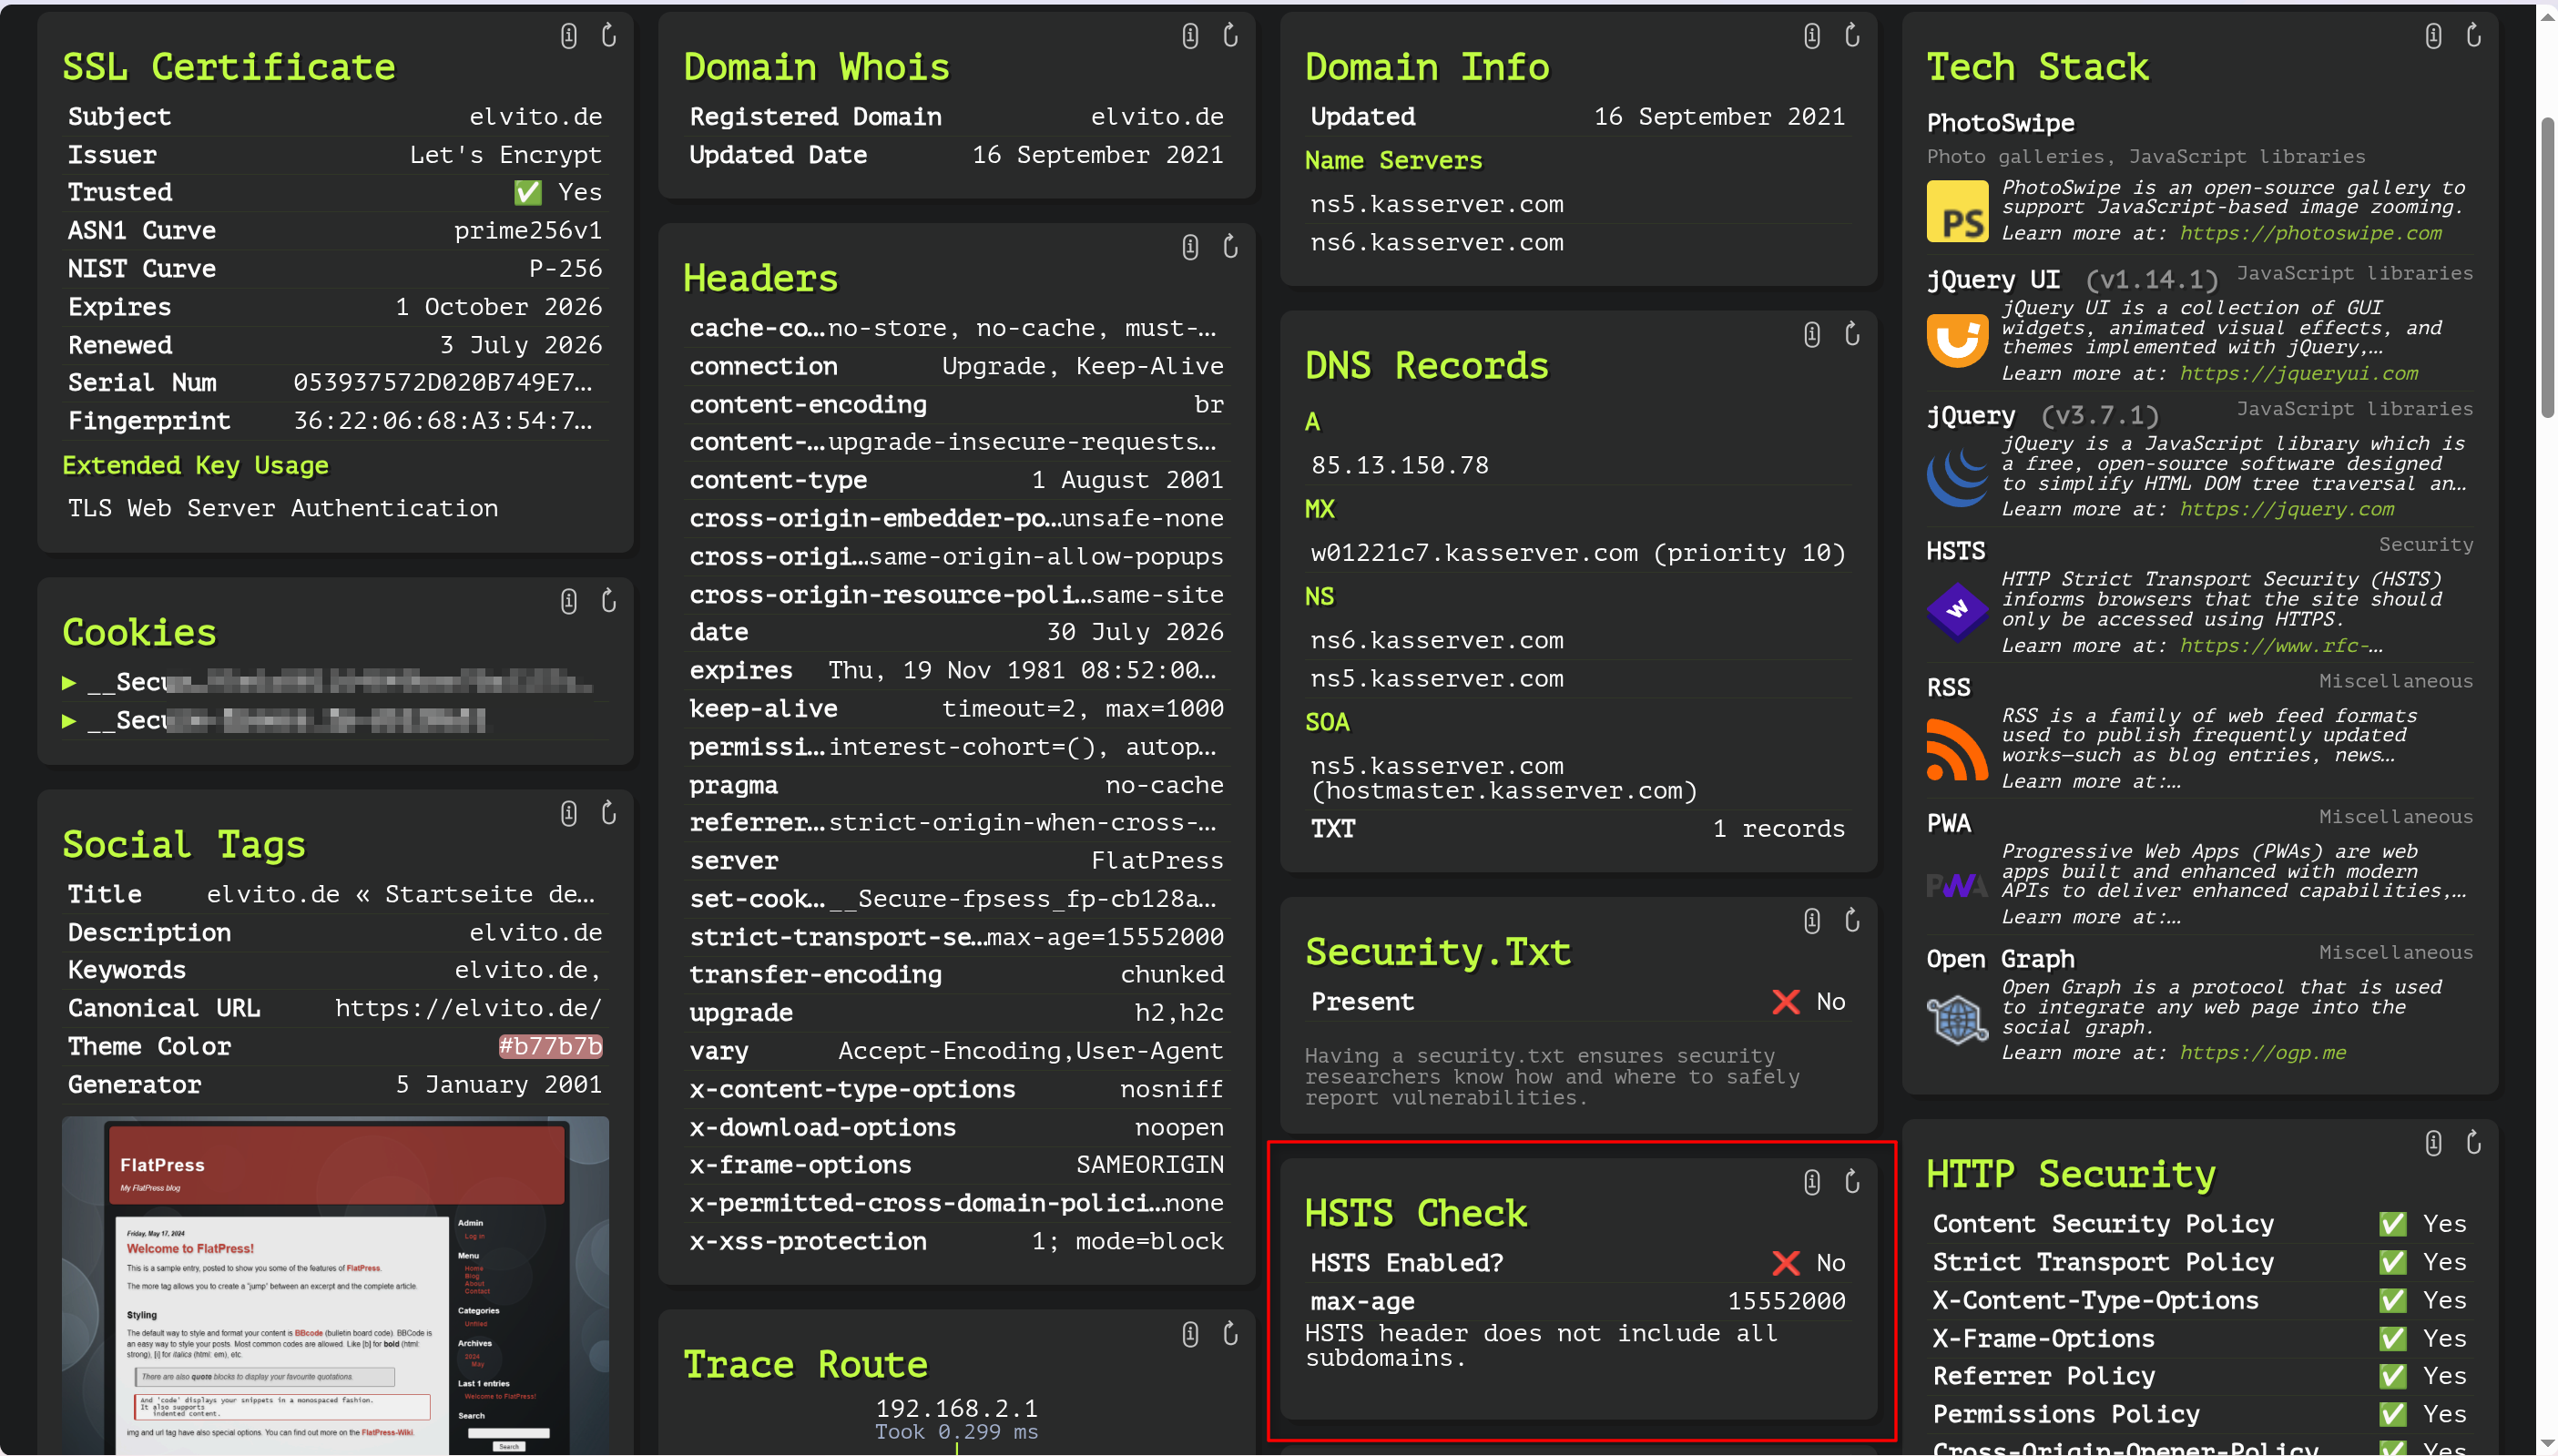
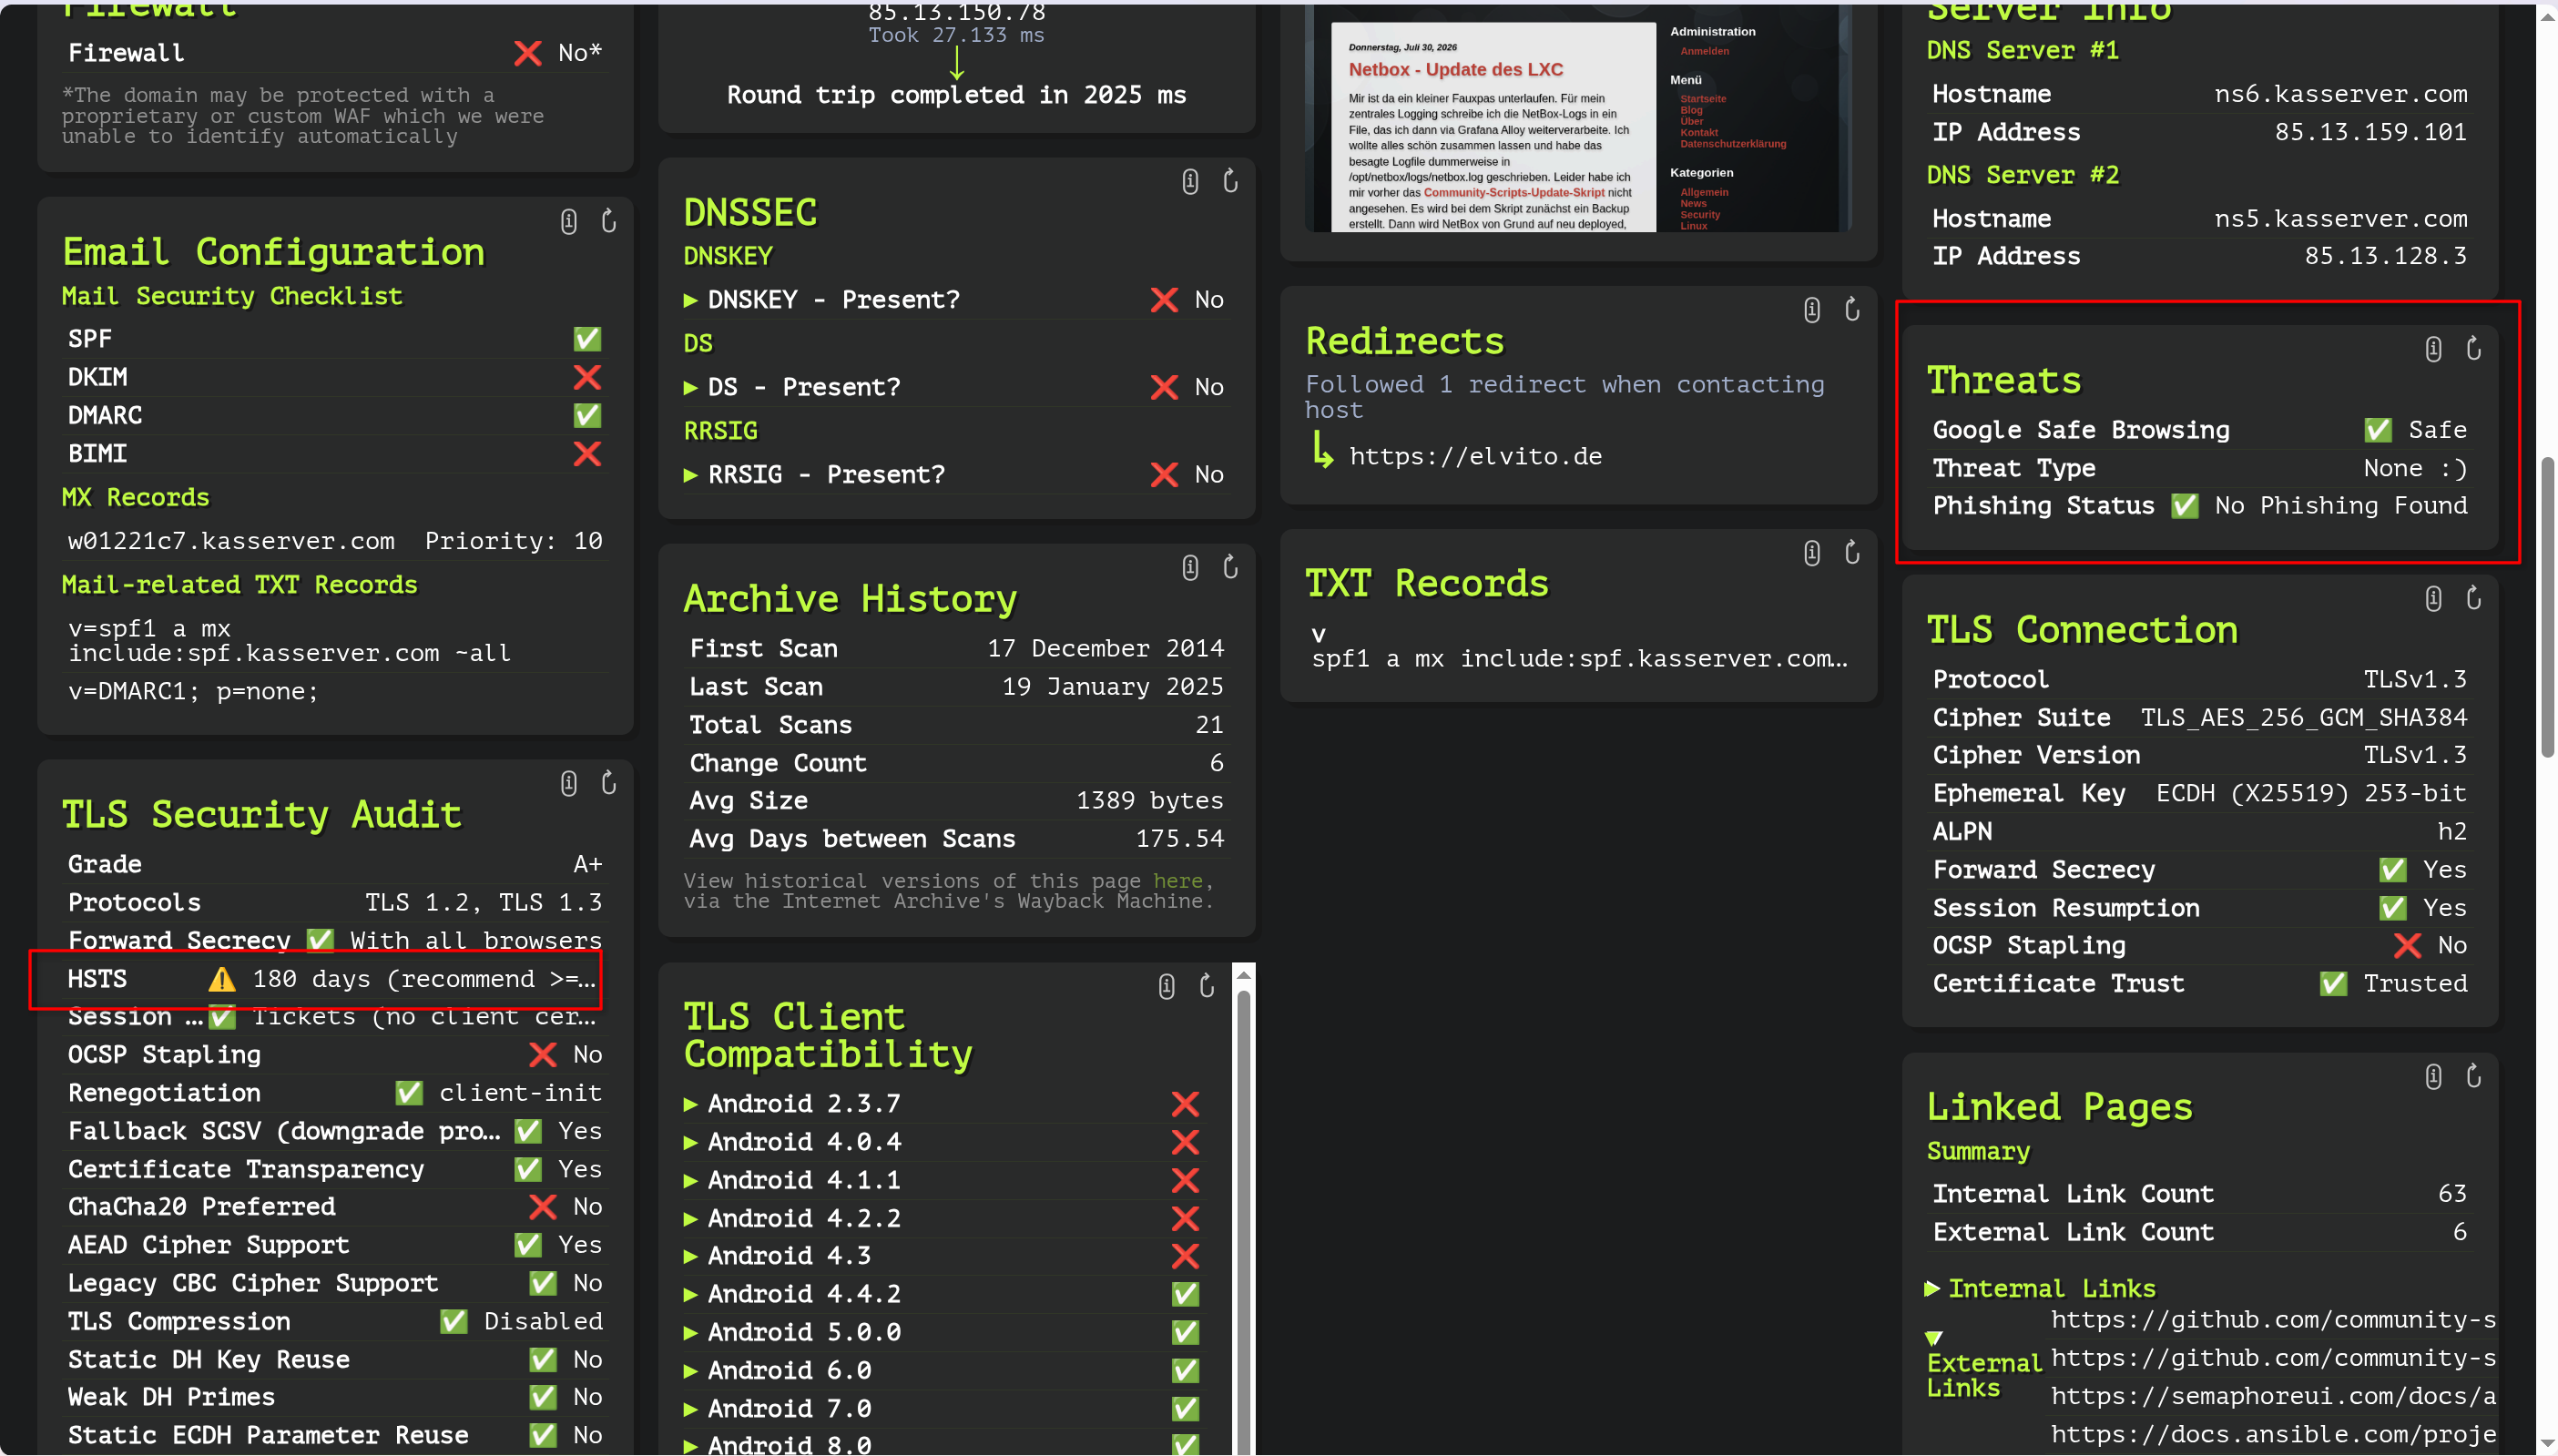
Man kann damit Webseiten analysieren. Ich finde das Tool jedenfalls überaus nützlich, wenn man mehr über eine obskure Webadresse in Erfahrung bringen will…
Hier sehe ich nur zwei technisch notwendige Cookies. Ich wollte überprüfen, ob mein Blog auch wirklich tut, was ich anfangs versprochen habe.
Man sieht auch den Eingriff aus dem zweiten(?) Artikel.
und sogar Google findet, dass meine Seite sicher ist. Da bin ich aber froh 😉 und gutes Stichwort. Sobald ich aus dem Urlaub zurück bin, werde ich mal festhalten, wie man Google-Dienste durch alternative (idealerweise selbstgehostete) Dienste ersetzen kann. Das ist nicht schwer, war sehr lehrreich für mich und hat mir große Freude bereitet, als ich bemerkt habe, wie gut/besser es auch ohne die “Werbung-Datensammel-Fans” geht.