Freitag, Juli 24, 2026

Netbox - Semaphore UI - lokales Playbook git Repo/Ansible Netbox Collection

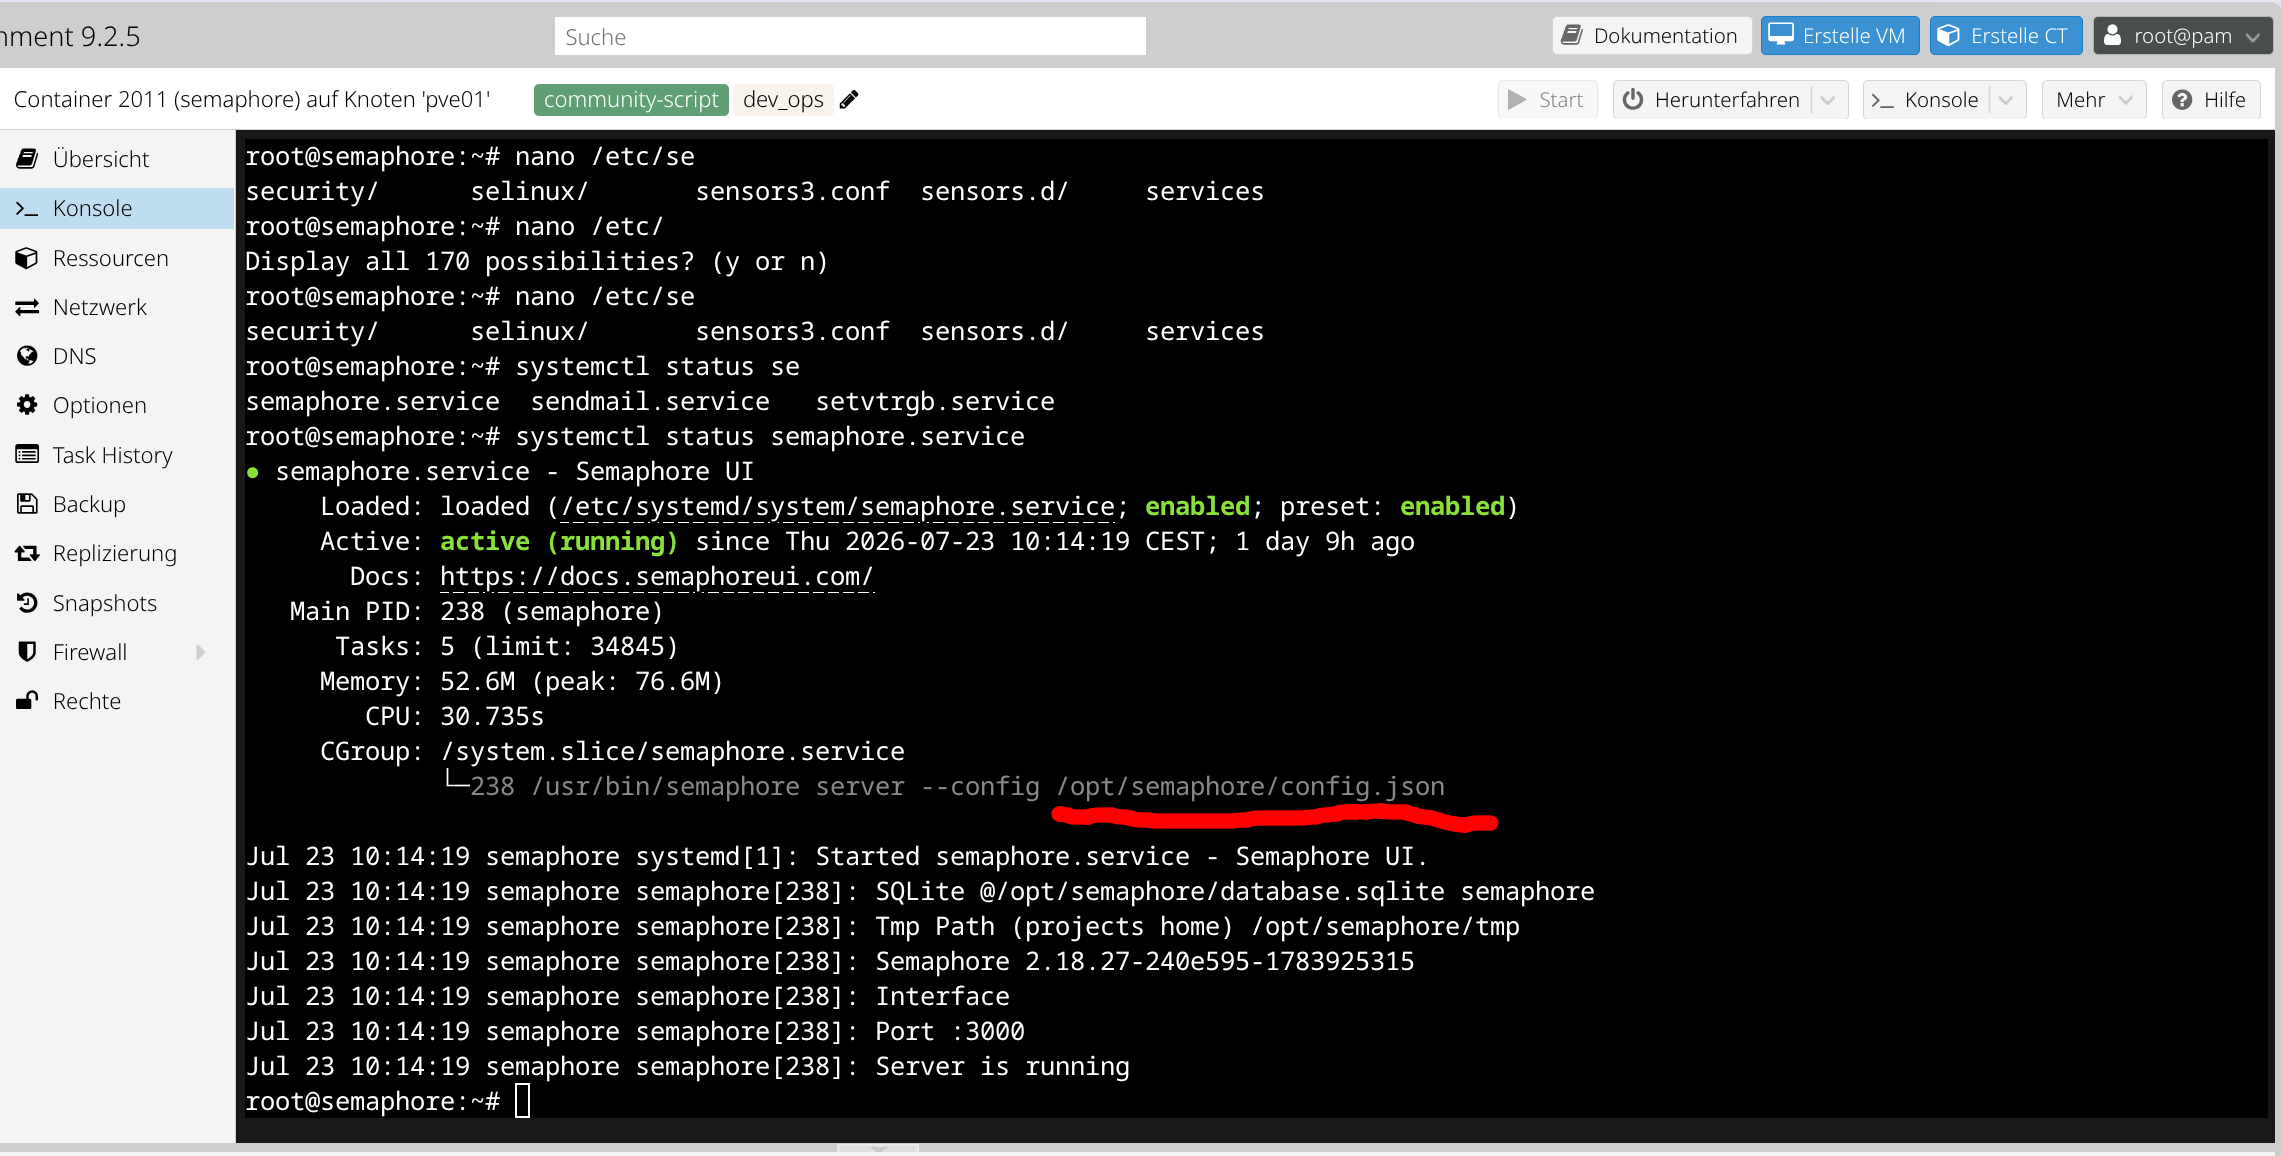
Nun sind endlich alle Vorbereitungen abgeschlossen und demnächst wird es sich zeigen, ob es den ganzen Aufwand wert war. Ich habe die Anleitung von Semaphore zumindest teilweise gelesen 😉, aber wie das nun mal mit Anleitungen ist… langweilig. Ich probiere es einfach mal aus. Die Playbooks (auch die eigenen) kann man in einem Git-Repository ablegen. Das ist durchaus klug, weil Git eine eigene Versionierung u. v. m. mitbringt. Gerade bei Scripten/Code verliert man ohne Versionierung sehr schnell den Überblick über den Änderungsverlauf. Die Installation von Semaphore UI über die Community-Scripts habe ich bereits im ersten NetBox-Beitrag erwähnt. Ich werfe kurz einen Blick in das Installationsscript von Semaphore UI. Es werden bei der Installation von Semaphore via apt die Pakete ansible und git mitinstalliert, aber nicht weiter konfiguriert. Der Pfad zum Config-File steht ebenfalls in dem Installscript oder man sieht es bei systemd.

Bildschirmfoto_20260724_195337.png

In /opt/semaphore/config.json steht momentan nur das Allernötigste. Hier wäre die Seite zum Nachschlagen der (zahlreichen) möglichen Parameter (Docker ENV und Config-File-Variablen).
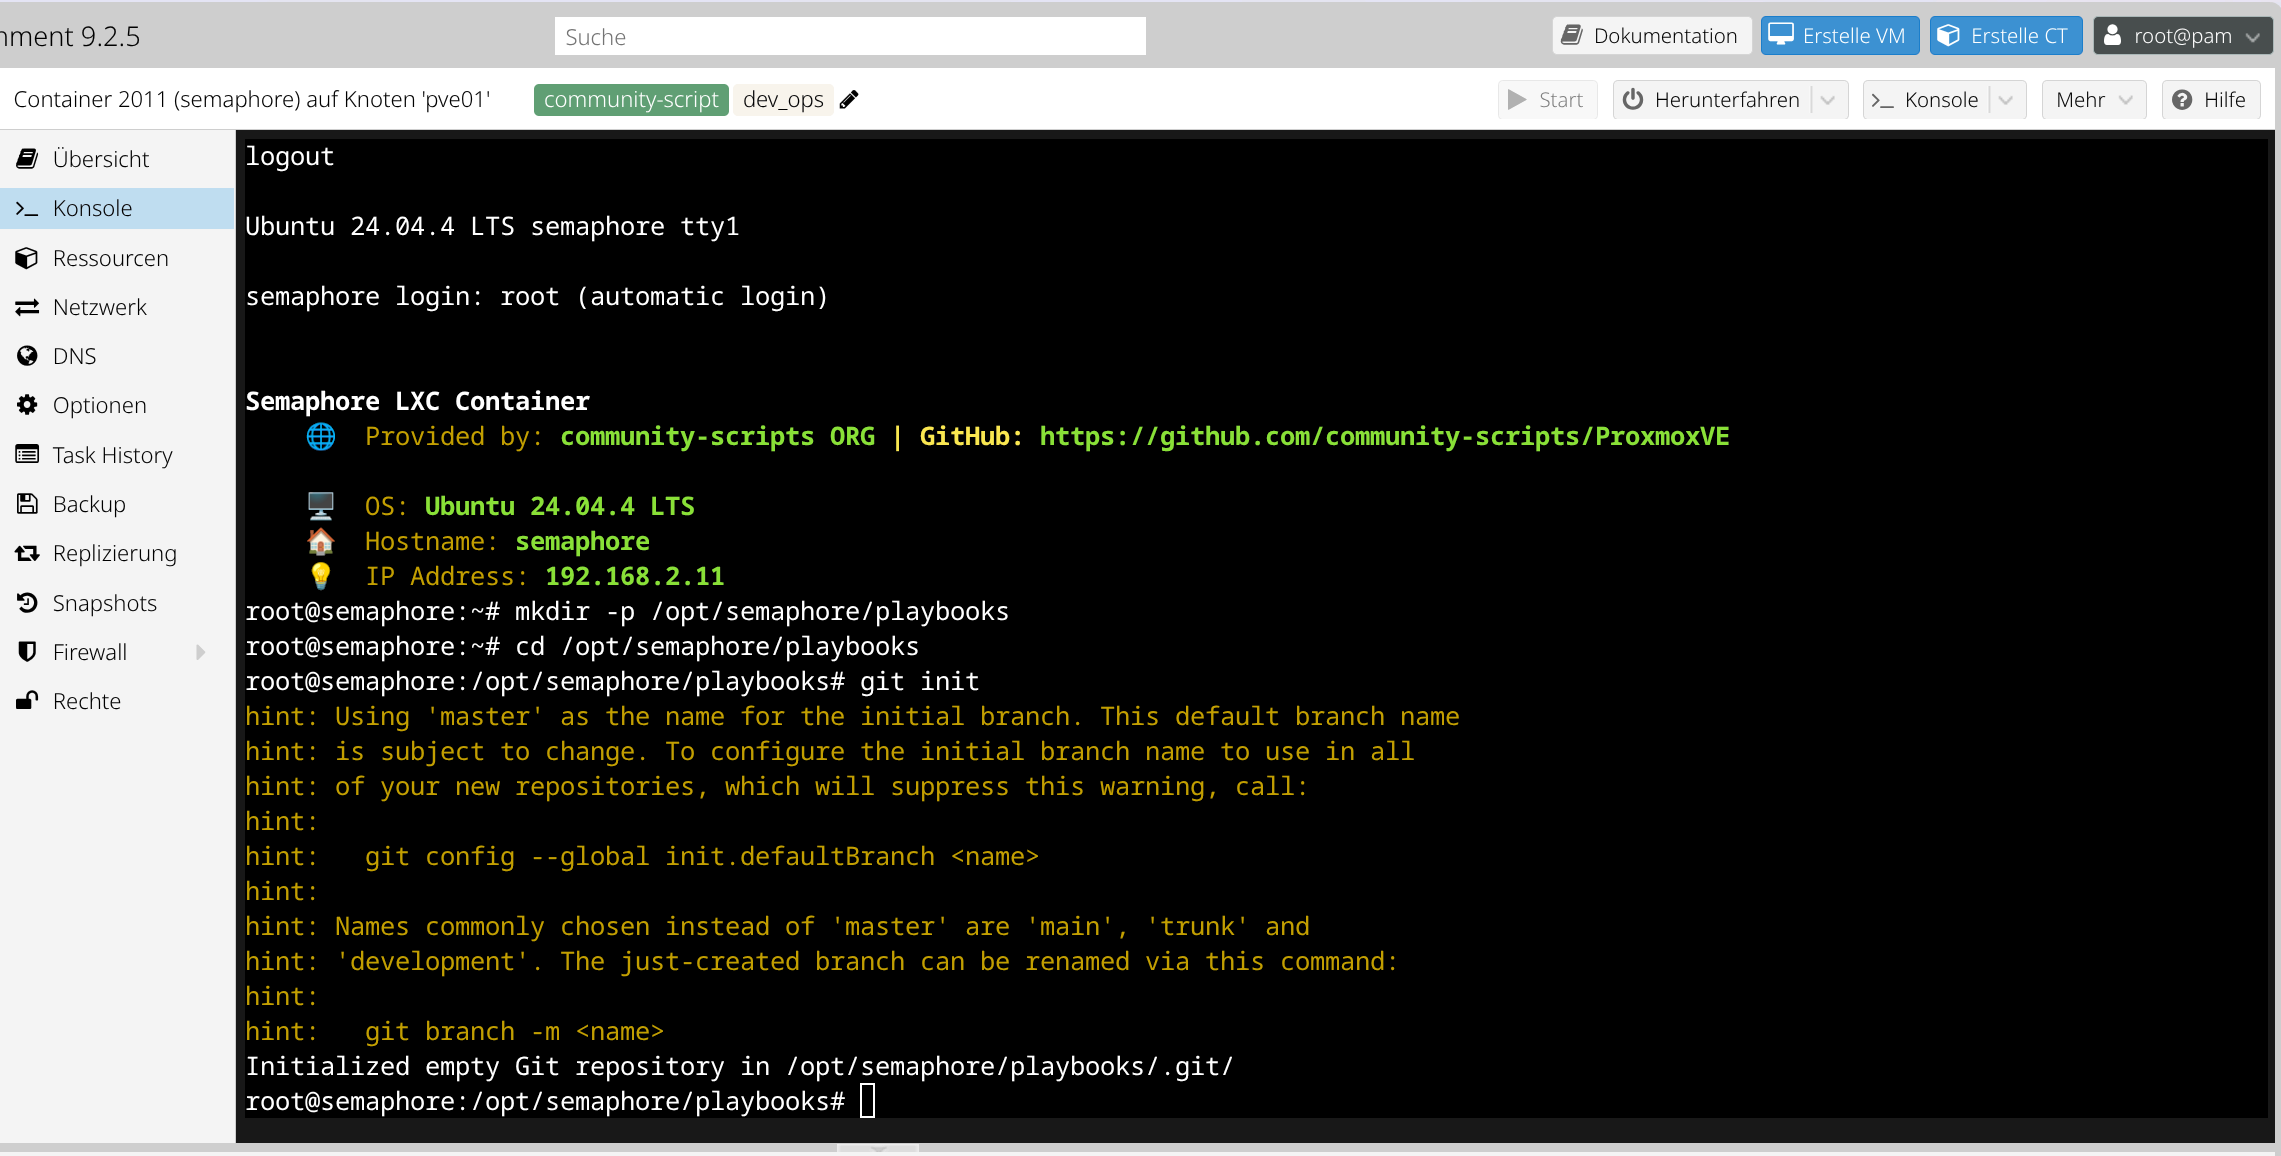
Für die Playbooks lege ich ein lokales Git-Repository an:

mkdir -p /opt/semaphore/playbooks
cd /opt/semaphore/playbooks
git init
Bildschirmfoto_20260724_202339.png

Für NetBox gibt es eine sogenannte Ansible-Collection, die die Kommunikation mit Ansible einfach möglich macht. Die lange Liste mit allen möglichen Befehlen, um NetBox zu beschreiben, ignoriere ich, interessant sind für mich momentan nur die Inventory- und Lookup-Plugins am Ende der Seite. In dem neuen Playbook-Verzeichnis jetzt ein neues Shellscript anlegen. Man muss python3-pip zuerst nachinstallieren, sonst funktioniert die Installation nicht.

apt update
apt install -y python3-pip
cd /opt/semaphore/playbooks
nano install-netbox-collection.sh

hier folgendes einfügen:

#!/bin/bash
set -e
ansible-galaxy collection install netbox.netbox --upgrade
pip3 install --upgrade pynetbox --break-system-packages

Durch –upgrade kann man das Script später erneut z. B. für Updates ausführen. Dann noch das Script ausführbar machen und in Git committen:

chmod +x install-netbox-collection.sh
git add install-netbox-collection.sh
git commit -m "Add netbox collection install script"

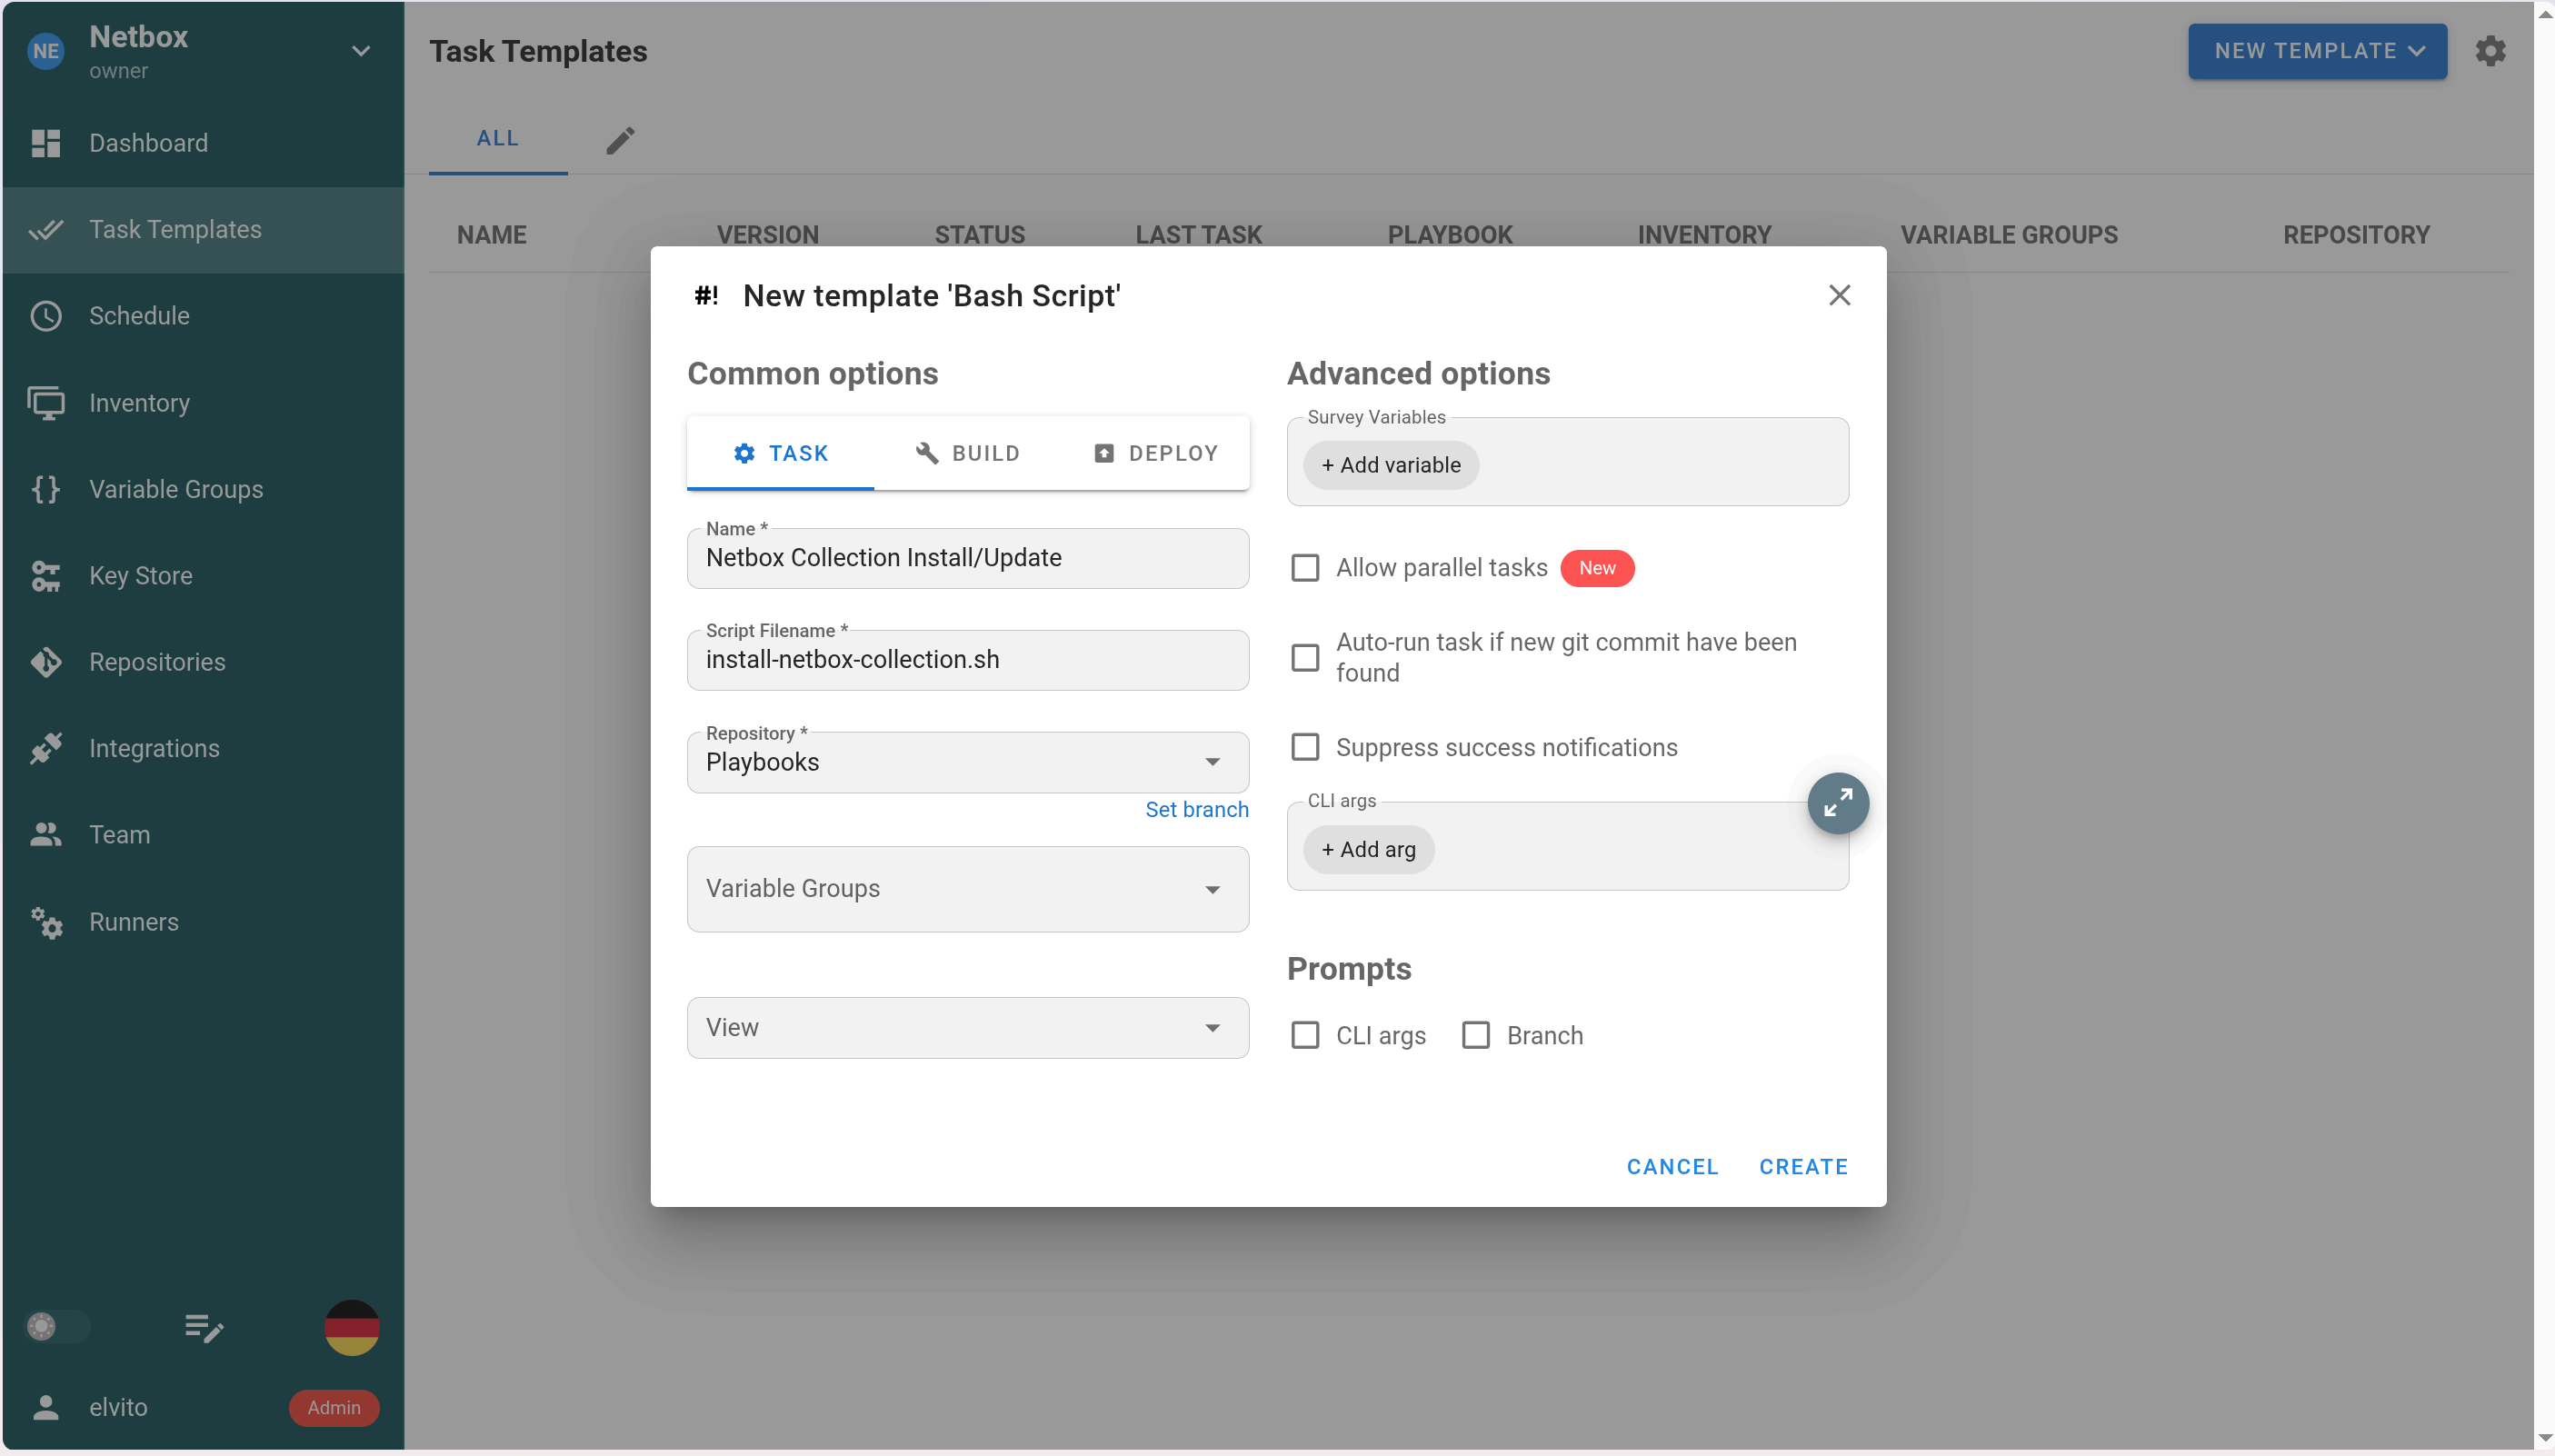
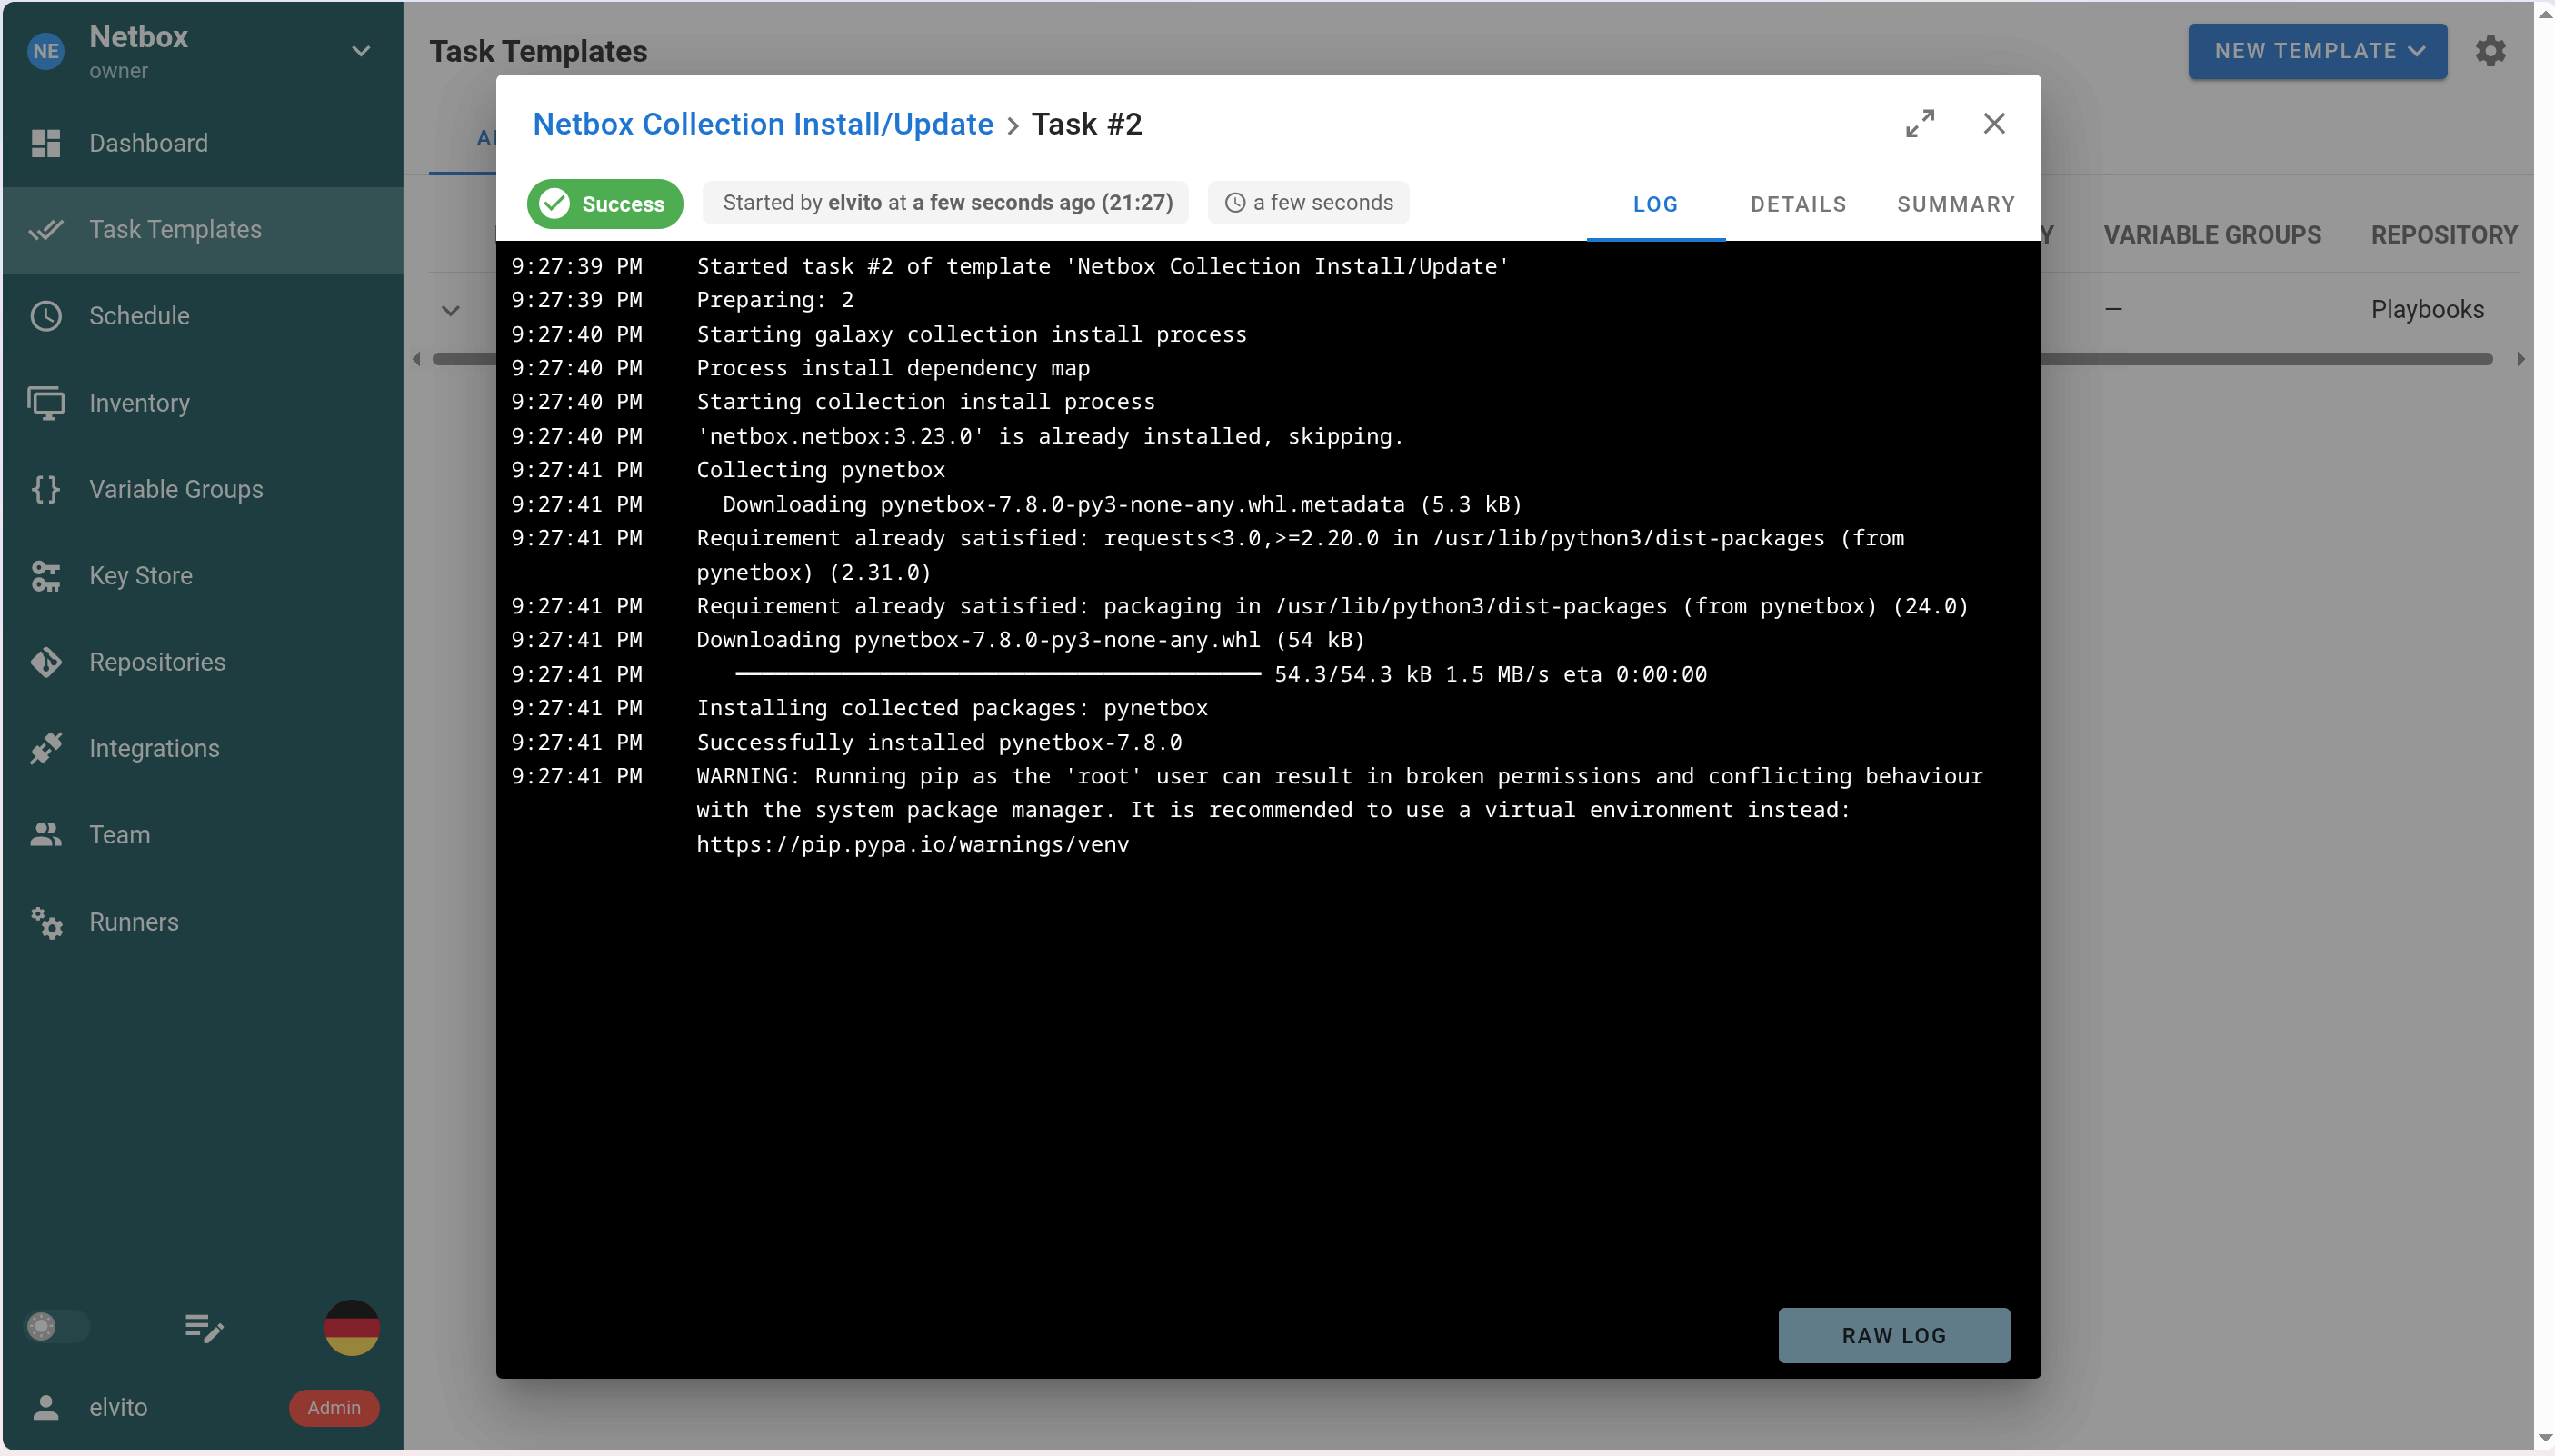
Jetzt kann man das Script in der GUI von Semaphore einbinden und gleich ausführen. Das Script installiert/aktualisiert die oben erwähnte Ansible-NetBox-Collection.

Bildschirmfoto_20260724_212048.png
Bildschirmfoto_20260724_212756.png

Sollten weitere Collections benötigt werden (vermutlich PVE), kann ich die später einfach in dem Script nachtragen.

Netbox - Erweiterung des Tailscale Tunnels für Loki/Alloy

Die Logs laufen nun von allen PVEs (an beiden Standorten), der lokalen Netbox-Instanz und dem lokalen Technitium-Server bei Loki zusammen. Der Technitium-Server am anderen Standort kann jedoch seine Logs aktuell noch nicht an Loki (läuft in meinem Heimnetz) schicken. Bei den anderen Instanzen war dies kein Problem, denn Tailscale ist auf allen PVEs installiert und fungiert mit den beiden TS-Subnet-Routern als Transportschicht ins entfernte Subnetz.

Auf meinen Technitium-Servern möchte ich kein Tailscale installieren, daher bleibt mir nur der Trick mit dem Tailscale-Tunnel, diesmal jedoch in die andere Richtung. Das ist eh nicht verkehrt, den Weg zusätzlich einzurichten, ich kann damit jederzeit weiteren Geräten/LXCs/VMs eine Verbindung ins jeweils andere Subnet geben, ohne extra Tailscale installieren zu müssen. Ich habe auch bereits einen Weg gefunden, solche Routen in Netbox abzubilden, das werde ich aber erst angehen, sobald die Fernsteuerung per Ansible funktioniert.

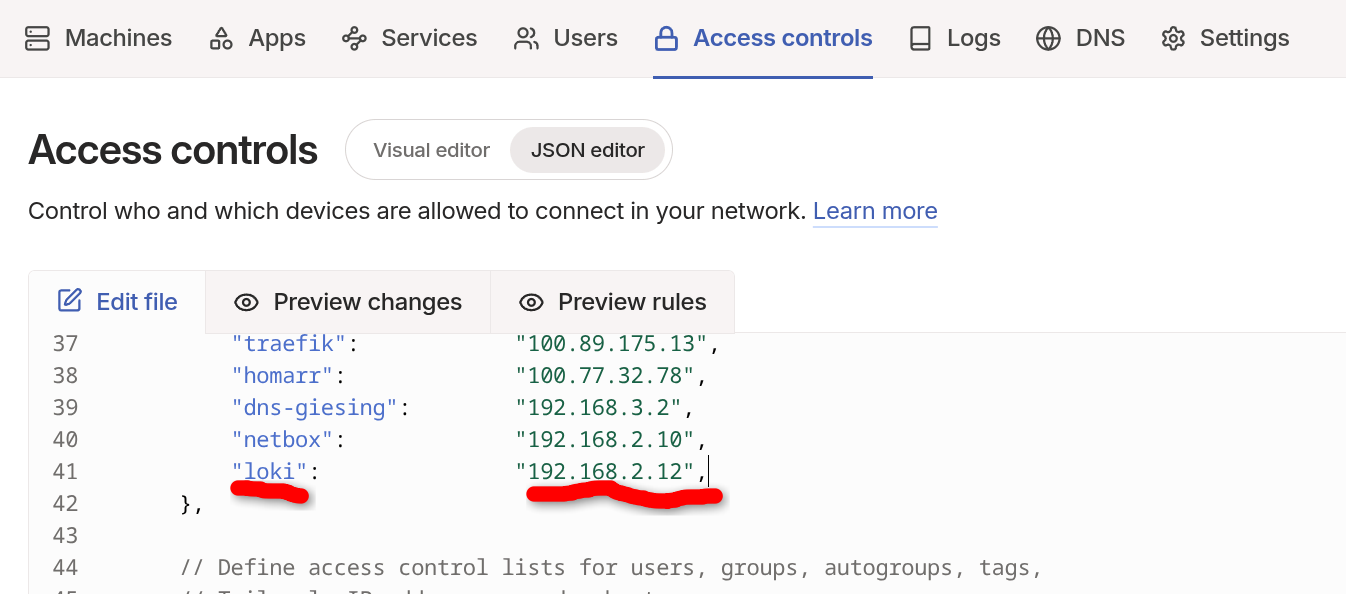
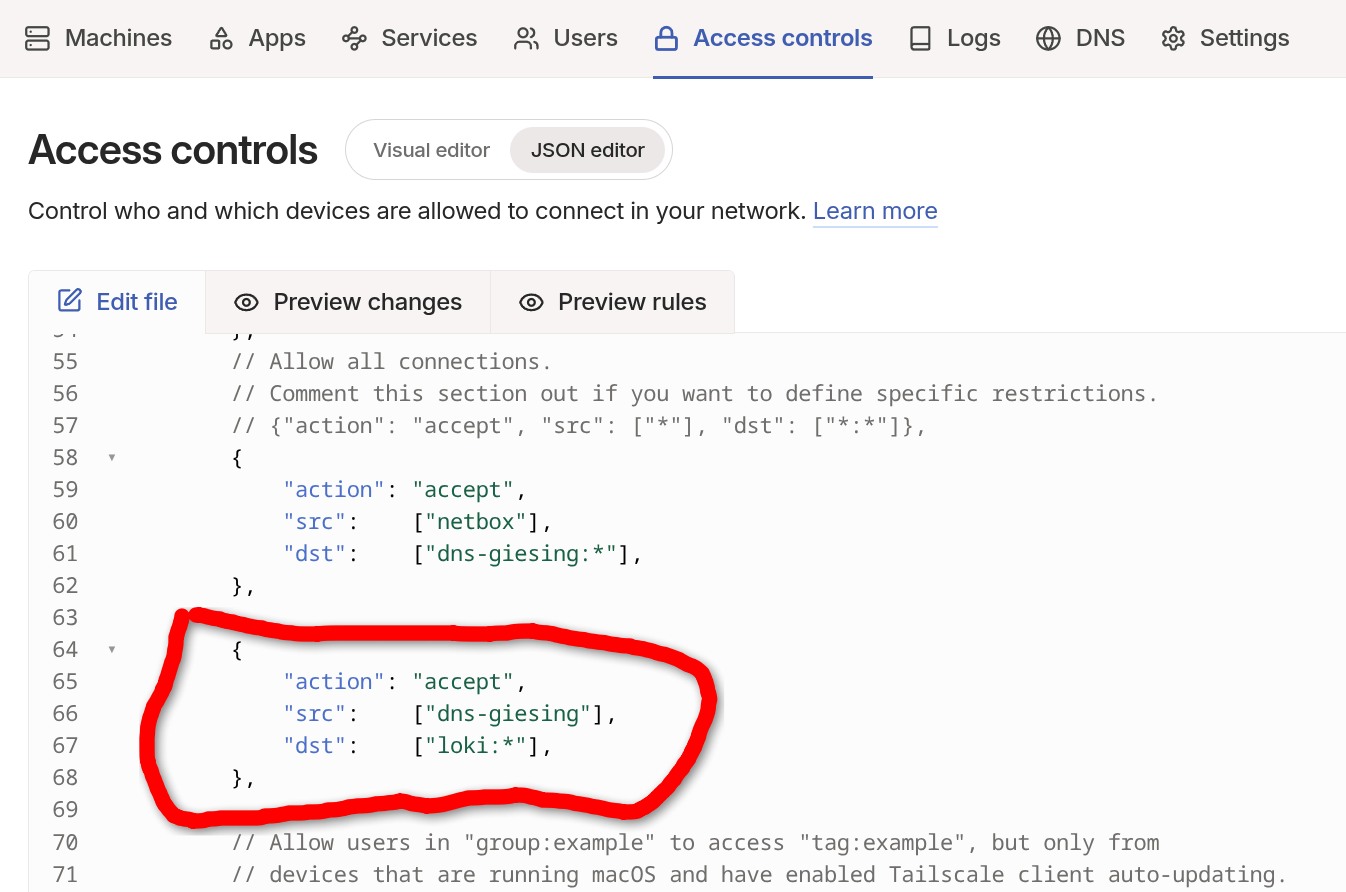
Zunächst lege ich in den Tailscale-ACLs einen neuen Host namens loki an und weise ihm die tatsächliche LAN-IP-Adresse zu. Ich muss zusätzlich eine neue Action in den ACLs definieren. Die Änderungen in den ACLs sollten anhand der Screenshots selbsterklärend sein.

Bildschirmfoto_20260724_162249.png
Bildschirmfoto_20260724_162535.png

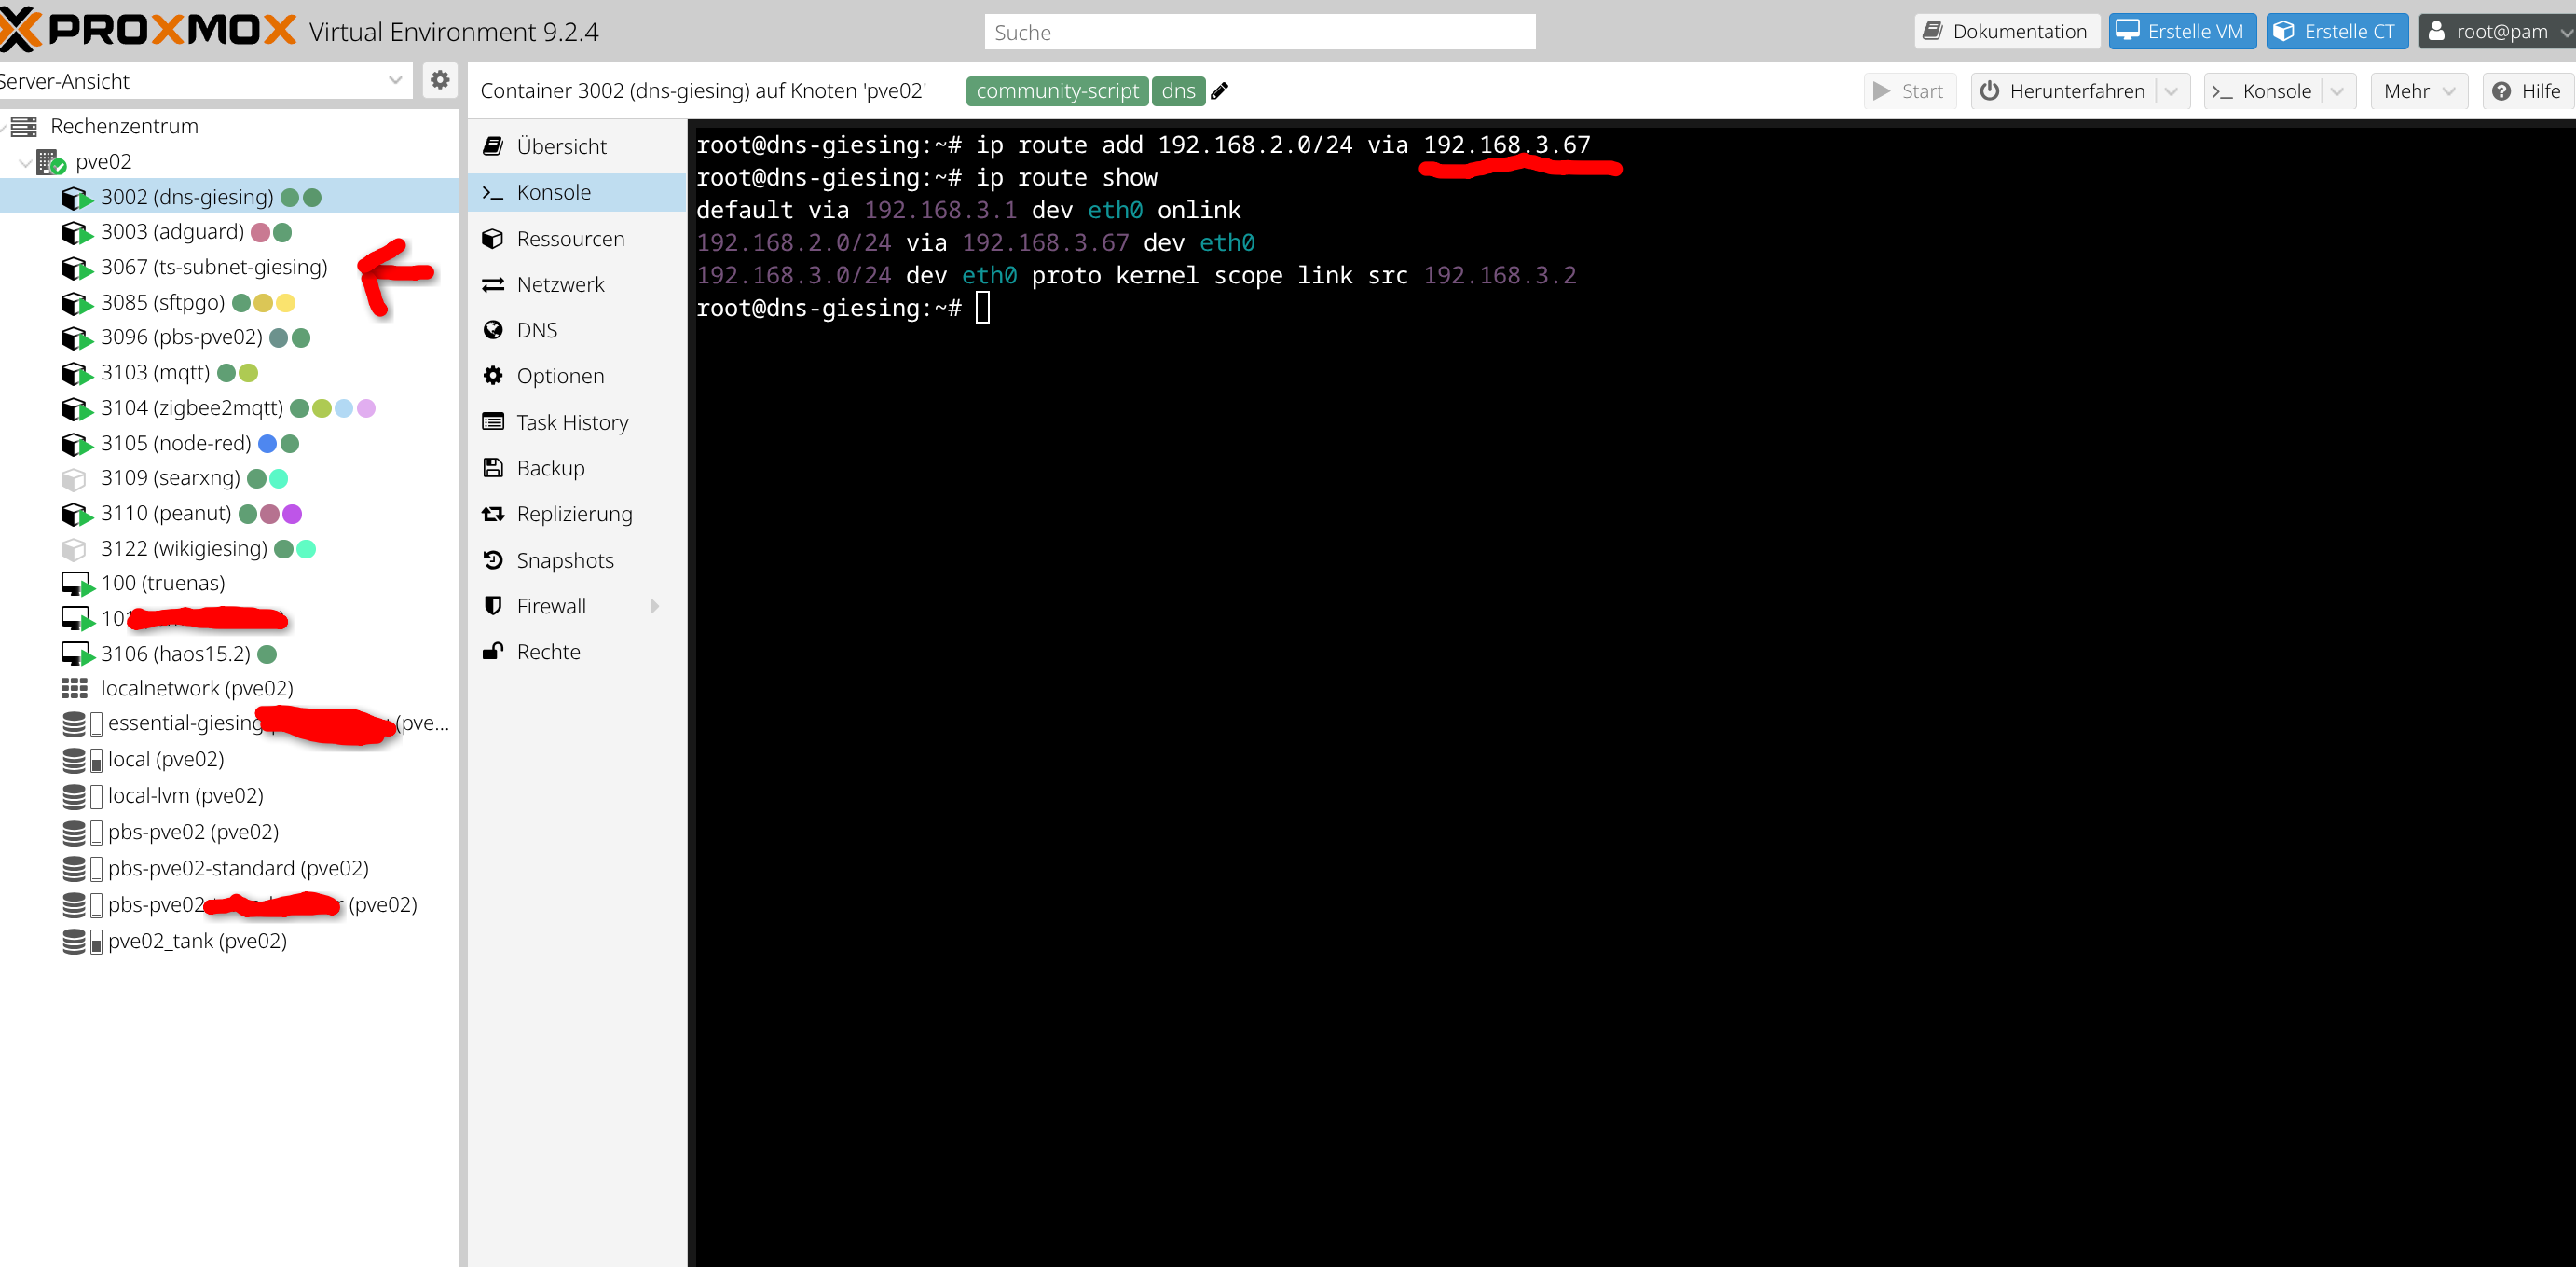
Nun trage ich die Route vom externen Technitium-Server (dns-giesing) in mein Heimnetz ein. Ich wechsele dazu in die Shell von dns-giesing und setze zunächst eine temporäre Route. Wenn es funktioniert, mache ich die Route persistent.

ip route add 192.168.2.0/24 via 192.168.3.67

Die IP-Adresse 192.168.3.67 gehört dem LXC mit Tailscale, das als Tailscale-Subnet-Router und Exit-Node im entfernten Subnetz fungiert. Mit

ip route show

kann man die aktuell gesetzte Route kontrollieren.

Bildschirmfoto_20260724_163737-1.png

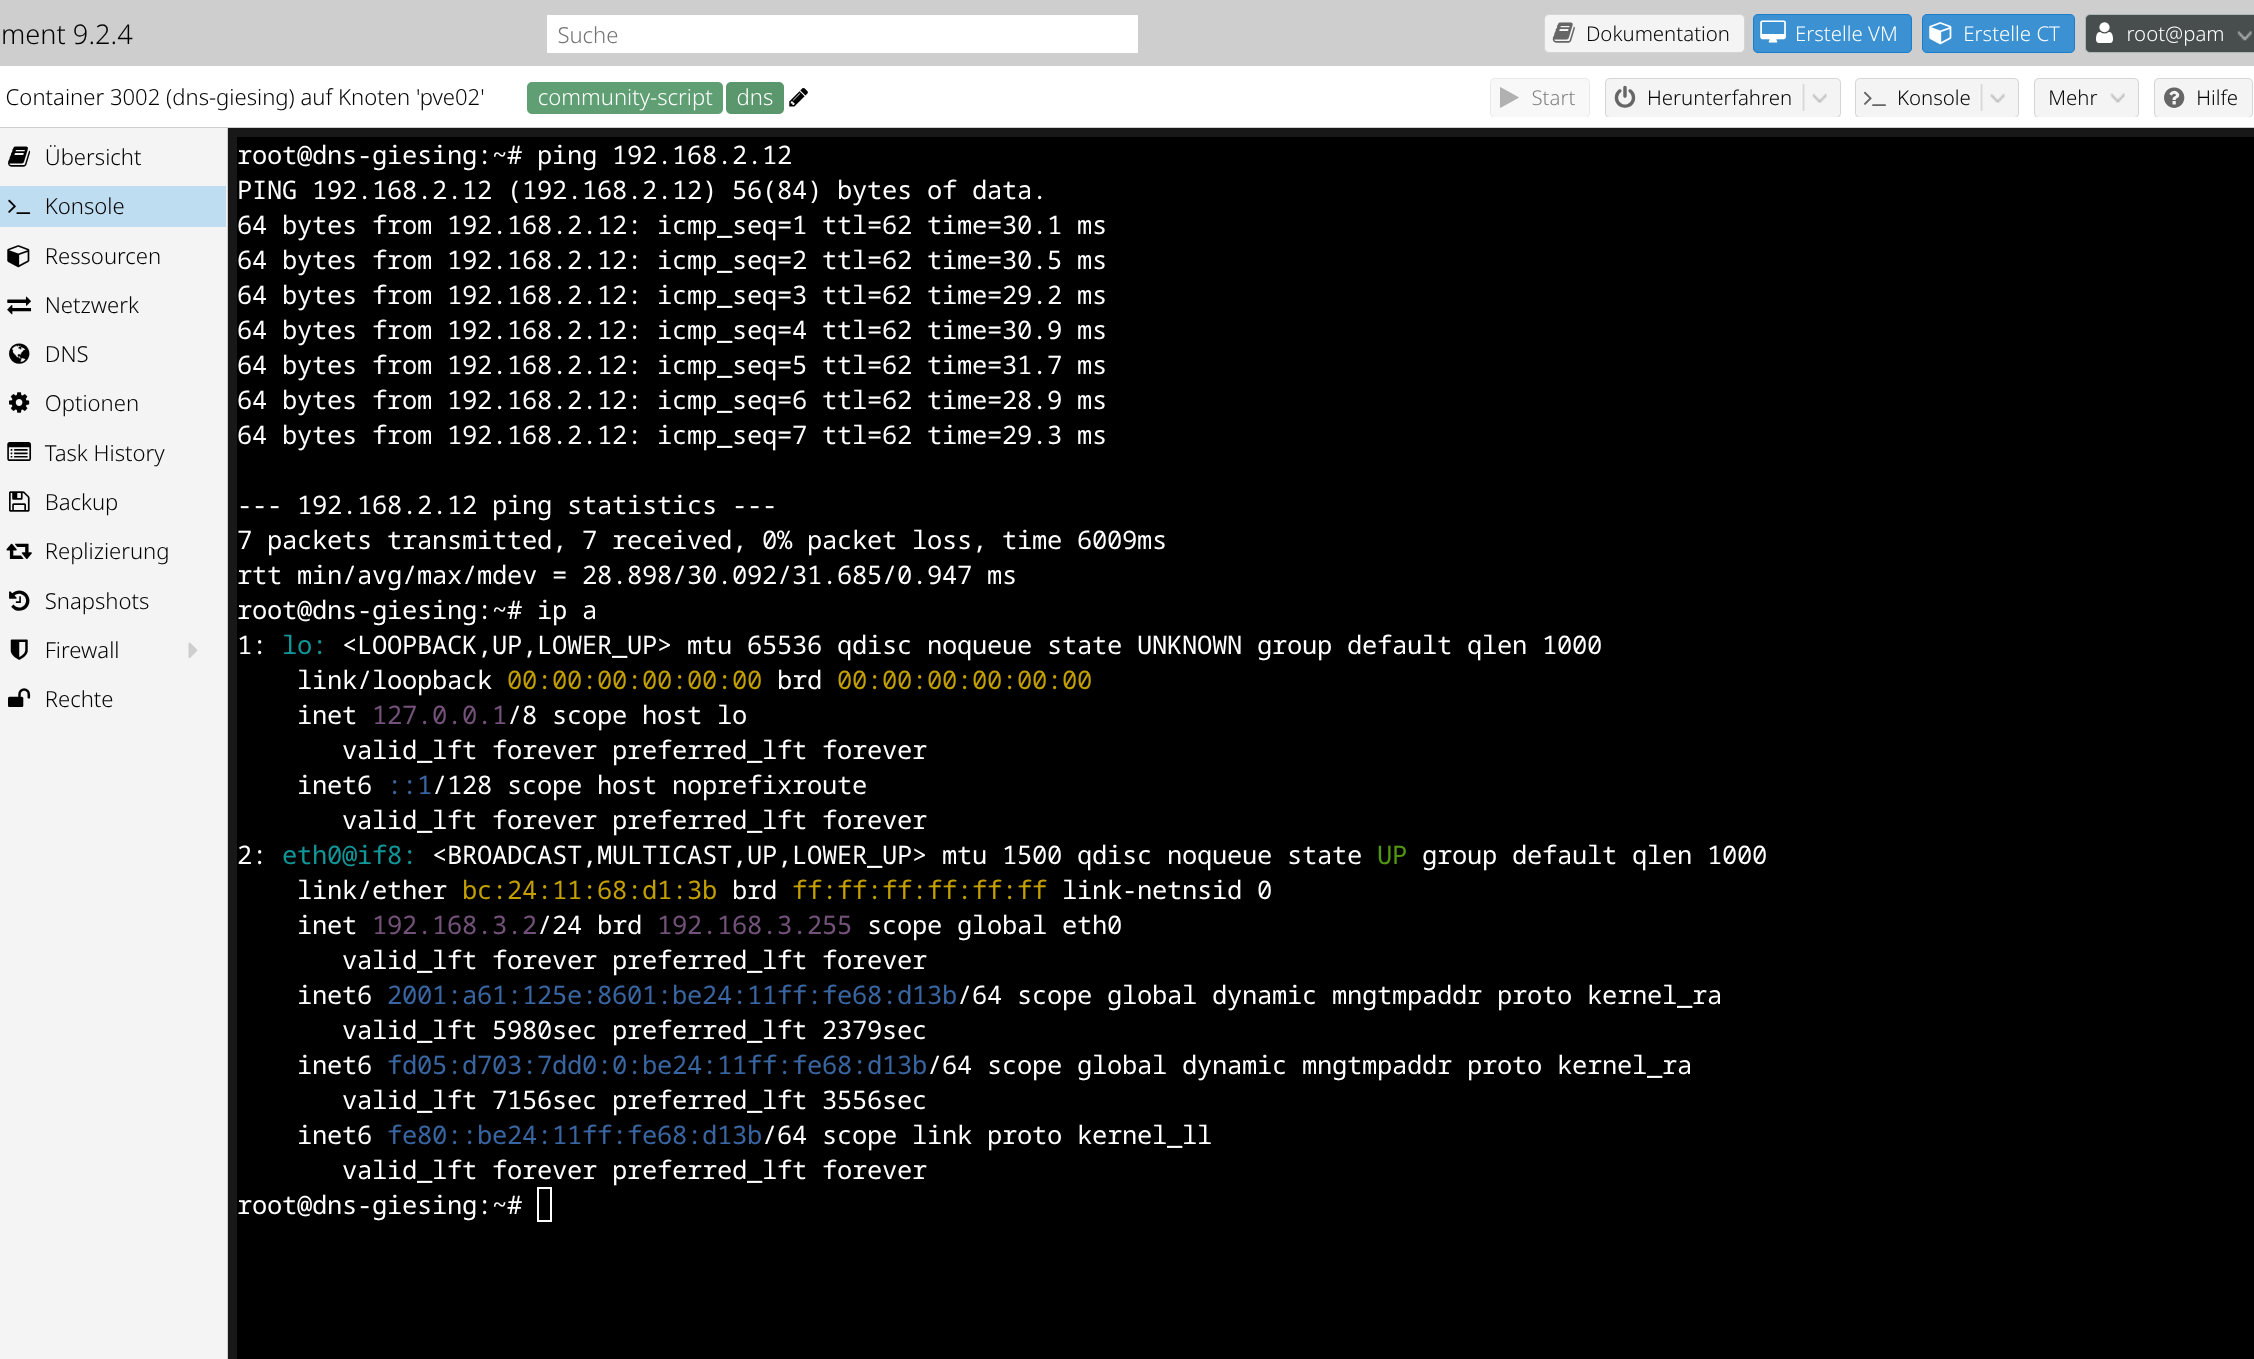
Nur zum Spaß teste ich einen Ping bereits vor der iptables-Regel auf dem TS-Subnet-Router hier im Heimnetz und stelle entsetzt fest, dass der Ping bereits jetzt durchgegangen ist… Ich vermute, das liegt an den TS-eigenen Masquerading-, SNAT- und sonstigen Geschichten, die da im Hintergrund laufen. (Hier steht die Erklärung, SNAT war die richtige Vermutung) Ich setze auf dem TS-Subnet-Router in meinem Heimnetz die iptables-Regel mit Masquerading trotzdem. Die Verbindung sollte dann auch noch funktionieren, wenn ich irgendwann mal etwas an der globalen Tailscale-SNAT-Einstellung ändere.

iptables -t nat -A POSTROUTING -o eth0 -s 192.168.3.0/24 -j MASQUERADE

Der Ping geht nun vom entfernten Technitium-LXC zu meinem lokalen Loki-LXC.

Bildschirmfoto_20260724_171050.png

Optimal! Nun mache ich noch die Änderungen persistent, auf dem LXC im Heimnetz mit dem TS-Subnet-Router.

apt install iptables-persistent -y
netfilter-persistent save

und auf dns-giesing (Technitium) noch die Route fest in die /etc/network/interfaces eintragen:

auto lo
iface lo inet loopback
auto eth0
iface eth0 inet static
address 192.168.3.2/24
gateway 192.168.3.1
post-up ip route add 192.168.2.0/24 via 192.168.3.67

Donnerstag, Juli 23, 2026

Netbox - Loki - Housekeeping - Abschluss des zentralen Loggings

Nachtrag 30.07.26: Man sollte einen anderen Pfad für das Logfile wählen, da sonst spätere Updates des LXCs fehlschlagen werden.

Damit die Logs nicht das LXC mit Loki vollschreiben und so zum Absturz bringen, muss ich eine Logrotation konfigurieren. Das ist per default nicht aktiviert. Man kann das bei Loki sehr fein einstellen. Manche Logs sollten evtl. länger als andere aufbewahrt werden und ich sollte mir möglichst vorher darüber Gedanken machen, wie ich das am besten strukturiere.
Grundsätzlich möchte ich zentrale Logs von

  1. NetBox (1x Einrichtung bekannt)
  2. Technitium (2x Einrichtung bekannt)
  3. PVE (4x Einrichtung bekannt)
  4. PBS (3x)
  5. TrueNAS (3x)
  6. einige LXCs (z.B. zigbee2mqtt, evtl. auch noch Home Assistant)

Punkt 4-6 wären nur ein Nice-to-have. Das zentrale Logging für die drei wichtigsten Dienste (Technitium, PVE und NetBox) funktioniert bereits bzw. die Einrichtung ist bekannt. Nun zur Vorhaltedauer der jeweiligen Logs. Ich lasse zwei KIs den voraussichtlichen Platzbedarf im Loki-LXC schätzen. Dafür werden 4–12 GB/Jahr geschätzt. Loki scheint die Logs effizient komprimieren zu können. Ich habe das LXC bereits vorher auf 10 GB resized, aktuell werden ca. 1,5 GB verbraucht, das sollte also vorerst locker reichen und ich werde mich jetzt hier nicht verkünsteln. Ich werde einfach eine globale Retention von 180 Tagen einstellen. Ich hoffe nicht, dass ich jemals in den Logs etwas nachsehen muss, das länger als 180 Tage in der Vergangenheit liegt.

cp /etc/loki/config.yml /etc/loki/config.yml.bak
nano /etc/loki/config.yml

Ich mache ein Backup der Original-Config-Datei und trage in der Config eine globale Vorhaltezeit ein:

limits_config:
  metric_aggregation_enabled: true
  retention_period: 4320h

4320h entsprechen den 180 Tagen. Das reicht aber noch nicht, die eingestellte Vorhaltezeit muss noch von dem sogenannten Compactor umgesetzt werden. Bei Loki ist der Compactor quasi der Buchhalter. Der Compactor braucht für die Komprimier-/Lese-/Schreib-/Löschvorgänge ein Arbeitsverzeichnis. Das Verzeichnis gibt es bereits unter /var/lib/loki/compactor. In der Config setze ich den neuen Codeblock mit dem Compactor zwischen die Blöcke limits_config und ruler:

compactor:
  working_directory: /var/lib/loki/compactor
  retention_enabled: true
  retention_delete_delay: 2h
  delete_request_store: filesystem

Wie oft der Compactor läuft, kann man in der gleichen Config unter dem Punkt compaction_interval eintragen, Default sind 10 Minuten, das passt für mich bereits. Abschließend Loki neu starten mit

systemctl restart loki

Ich hab’s eine Zeit lang laufen lassen. Man kann nach einiger Zeit mit

journalctl -u loki -f

Zeilen wie diese sehen:

Jul 23 13:10:12 loki loki[560]: level=info ts=2026-07-23T11:10:12.534471137Z caller=tables_manager.go:289 msg="finished compacting table" table-name=index_20654

Der Compactor scheint zu “kompaktieren” 😃
Bei der Gelegenheit räume ich auch gleich mein dämliches Konstrukt mit rsyslog in dem NetBox-LXC auf. Ich editiere dazu die /opt/netbox/netbox/netbox/configuration.py und ersetze dort den gesamten Part mit LOGGING durch:

LOGGING = {
    'version': 1,
    'disable_existing_loggers': False,
    'formatters': {
        'normal': {'format': '%(asctime)s %(name)s %(levelname)s: %(message)s'},
    },
    'handlers': {
        'console': {
            'level': 'INFO',
            'class': 'logging.StreamHandler',
        },
        'file': {
            'level': 'INFO',
            'class': 'logging.handlers.WatchedFileHandler',
            'filename': '/opt/netbox/logs/netbox.log',
            'formatter': 'normal',
        },
    },
    'loggers': {
        'netbox': {'handlers': ['console', 'file'], 'level': 'INFO'},
        'django': {'handlers': ['console', 'file'], 'level': 'WARNING'},
    },
}

Damit möchte ich die Logs zusätzlich in der Datei /opt/netbox/logs/netbox.log speichern. Das Verzeichnis gibt es noch nicht, also lege ich es an und übertrage die Ownership auf den User netbox.

mkdir -p /opt/netbox/logs
chown netbox:netbox /opt/netbox/logs

Jetzt NetBox neu starten

systemctl restart netbox netbox-rq

und ein Fantasiegerät in NetBox anlegen und wieder löschen.

cat /opt/netbox/logs/netbox.log

zeigt nun bei mir

2026-07-23 11:23:55,221 netbox.views.ObjectEditView INFO: Created Gerät jhghjvbhj (PK: 83)
2026-07-23 11:24:33,928 netbox.views.ObjectDeleteView INFO: Deleted Gerät jhghjvbhj

In UTC-Zeit, sehr schön, so soll das sein. Jetzt muss Alloy installiert werden, der dann das Ganze an das Loki-LXC schickt. Mein Denkfehler war, dass ich zuerst gedacht habe, dass EINE Alloy-Instanz alle Daten “einsammelt”, Alloy ist allerdings ein Agent, der auf dem sendenden Service mitlaufen muss.

apt update && apt install -y gpg wget
mkdir -p /etc/apt/keyrings
wget -q -O /etc/apt/keyrings/grafana.asc https://apt.grafana.com/gpg-full.key
chmod 644 /etc/apt/keyrings/grafana.asc
echo "deb [signed-by=/etc/apt/keyrings/grafana.asc] https://apt.grafana.com stable main" | tee /etc/apt/sources.list.d/grafana.list
apt update
apt install -y alloy

sollte Alloy auf alle Debian-basierten Geräte/Services packen können. Das wäre evtl. auch gleich ein Alloy-Deploy-Script für Ansible. Sobald Alloy in dem NetBox-LXC installiert ist, die /etc/alloy/config.alloy editieren, ich schmeiß dort alles raus und setze für das NetBox-LXC stattdessen folgendes ein:

loki.source.file "netbox" {
  targets = [
    {__path__ = "/opt/netbox/logs/netbox.log", job = "netbox", host = "netbox01"},
  ]
  forward_to = [loki.write.central.receiver]
}
loki.write "central" {
  endpoint {
    url = "http://192.168.2.12:3100/loki/api/v1/push"
  }
}

Alloy auf NetBox starten und enablen mit

systemctl enable --now alloy

Jetzt rsyslog wieder zurückbauen

systemctl disable --now rsyslog
rm -f /etc/rsyslog.d/99-loki-forward.conf
apt purge -y rsyslog
apt autoremove

und schon ist rsyslog wieder weg.

Als Nächstes Technitium reparieren. Dazu in das Technitium-LXC wechseln und Alloy genauso wie im NetBox-LXC installieren. Bei Technitium wird bereits das Log in ein File geschrieben, ich muss hier also kein extra Verzeichnis anlegen. Die /etc/alloy/config.alloy sieht für Technitium so bei mir aus:

local.file_match "technitium" {
  path_targets = [
    {__path__ = "/etc/dns/logs/*.log", job = "technitium", host = "technitium01"},
  ]
}
loki.source.file "technitium" {
  targets    = local.file_match.technitium.targets
  forward_to = [loki.write.central.receiver]
}
loki.write "central" {
  endpoint {
    url = "http://192.168.2.12:3100/loki/api/v1/push"
  }
}

Die einzelnen Werte muss man bei allen Configs natürlich entsprechend an sein Setup anpassen. Nun Alloy starten und enablen. rsyslog lässt sich genau so wie im NetBox-LXC entfernen

systemctl enable --now alloy
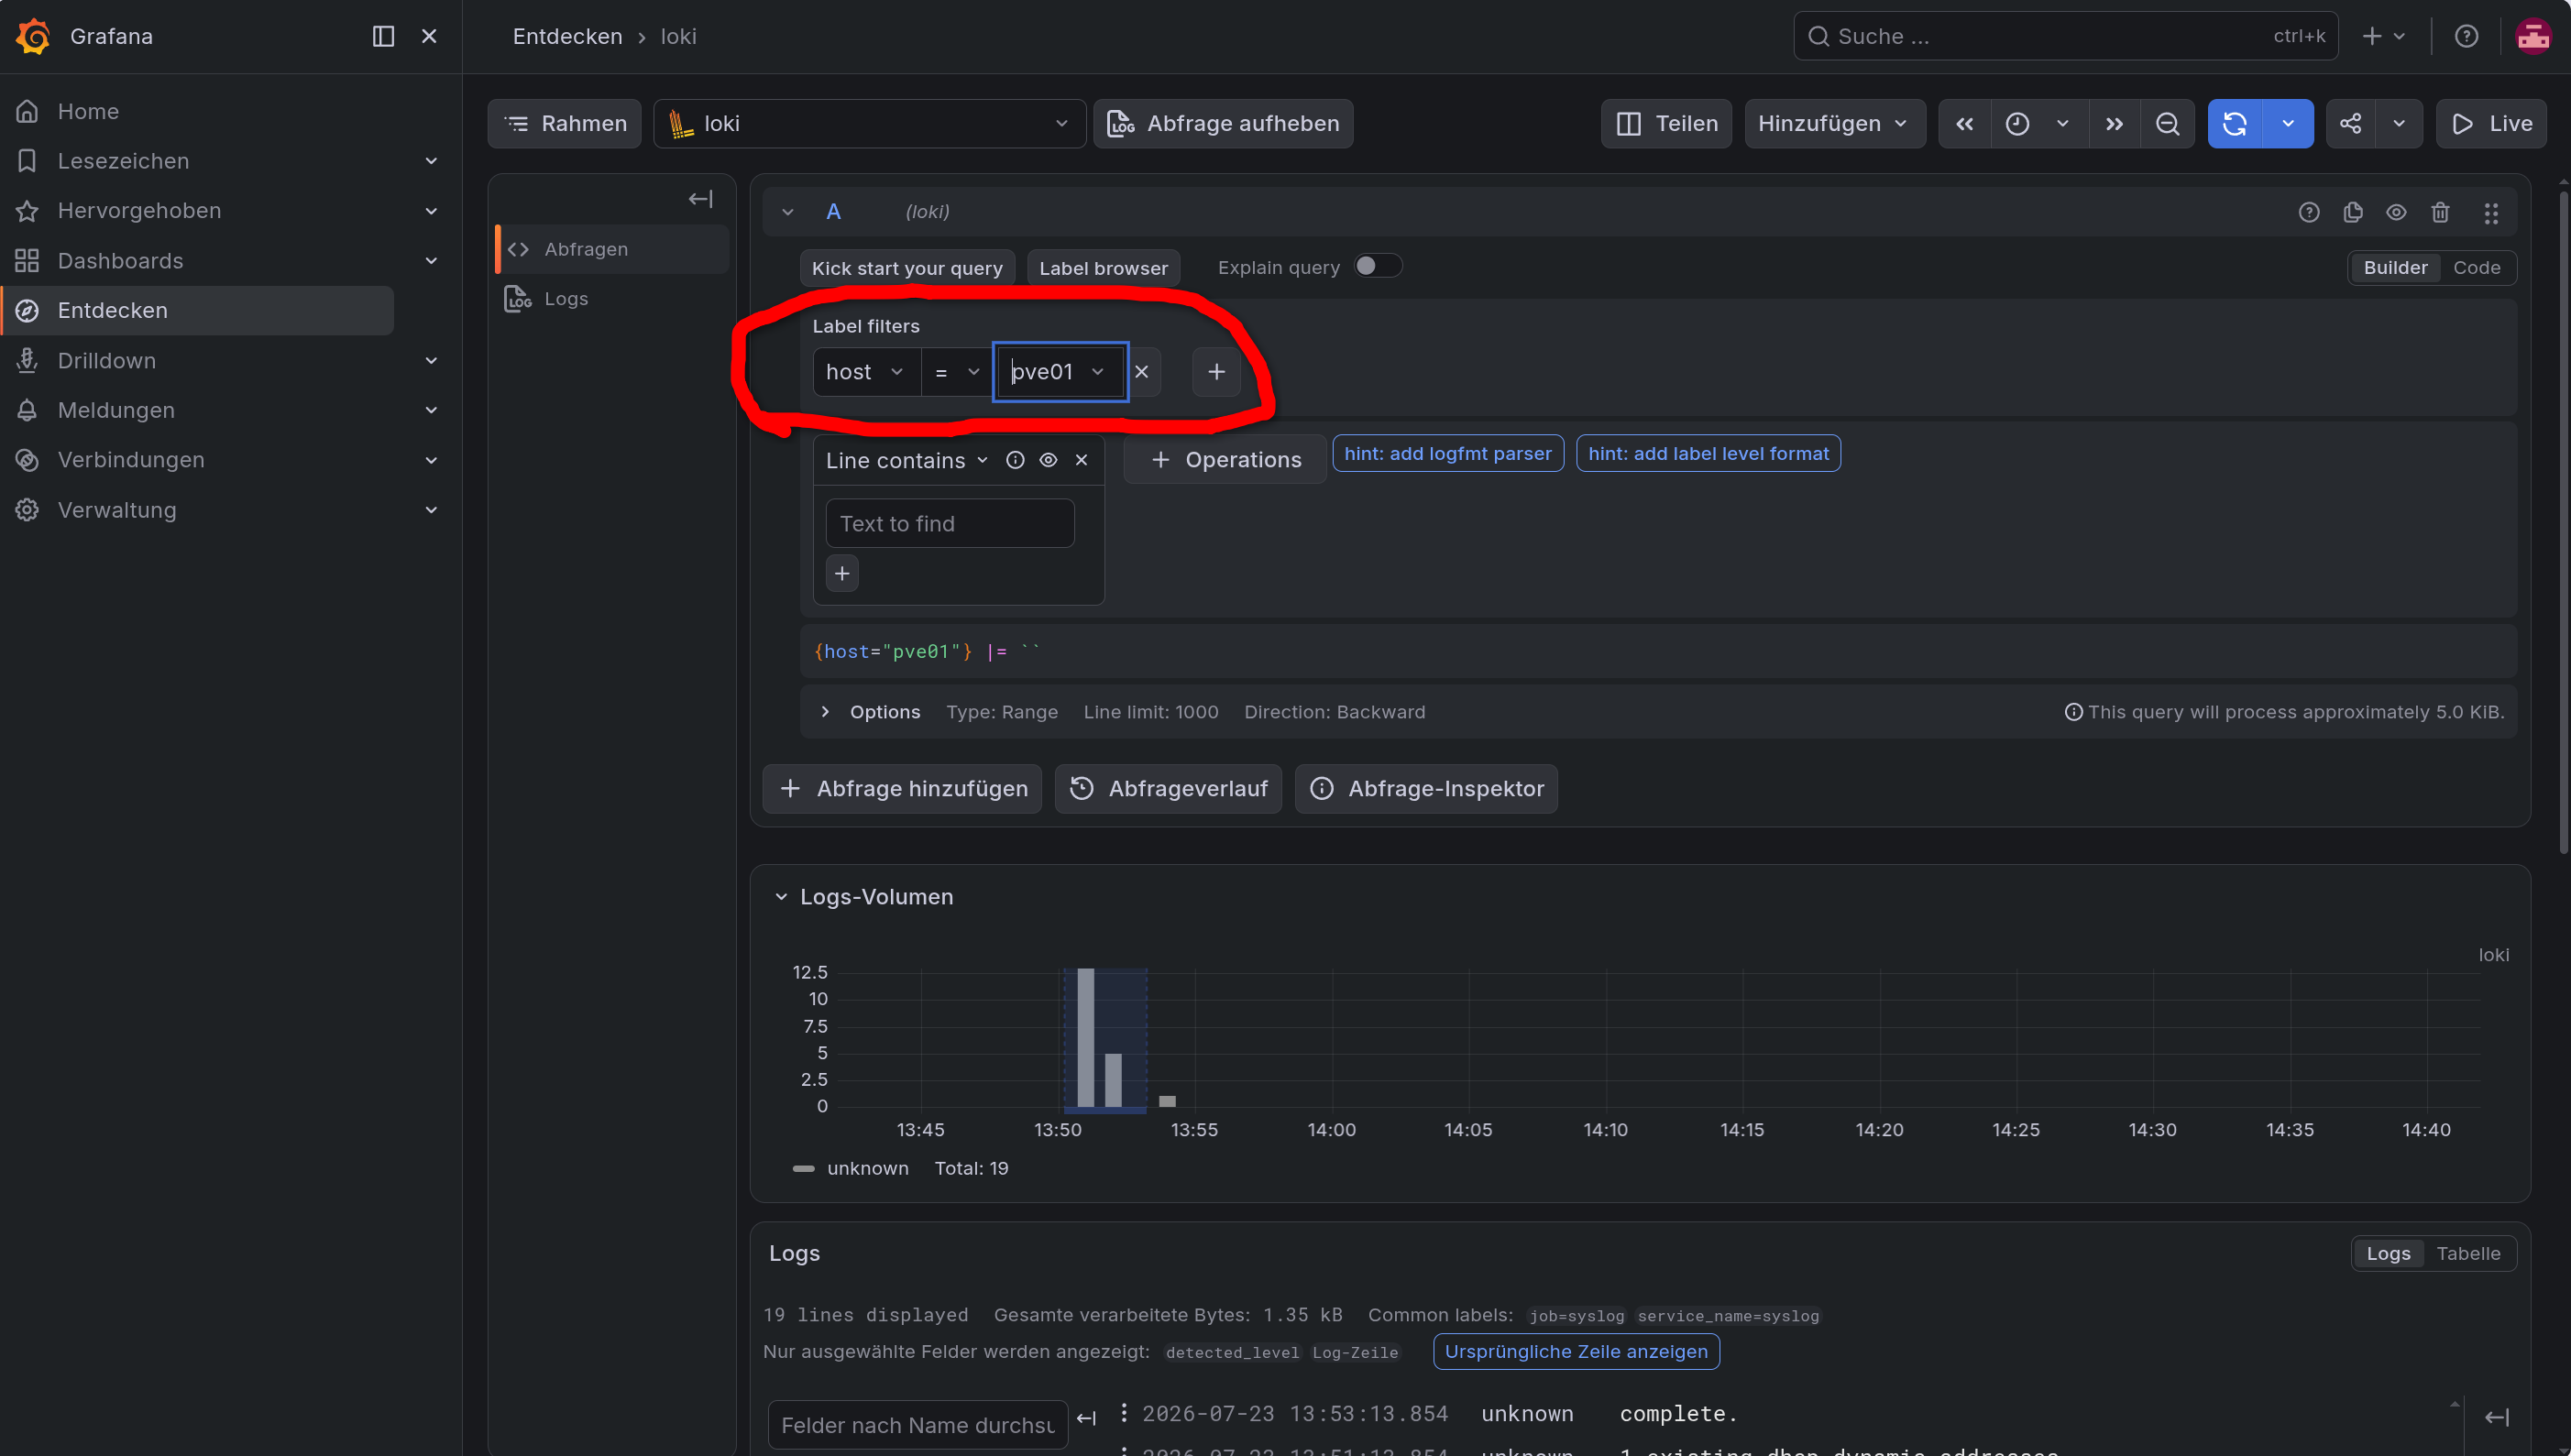
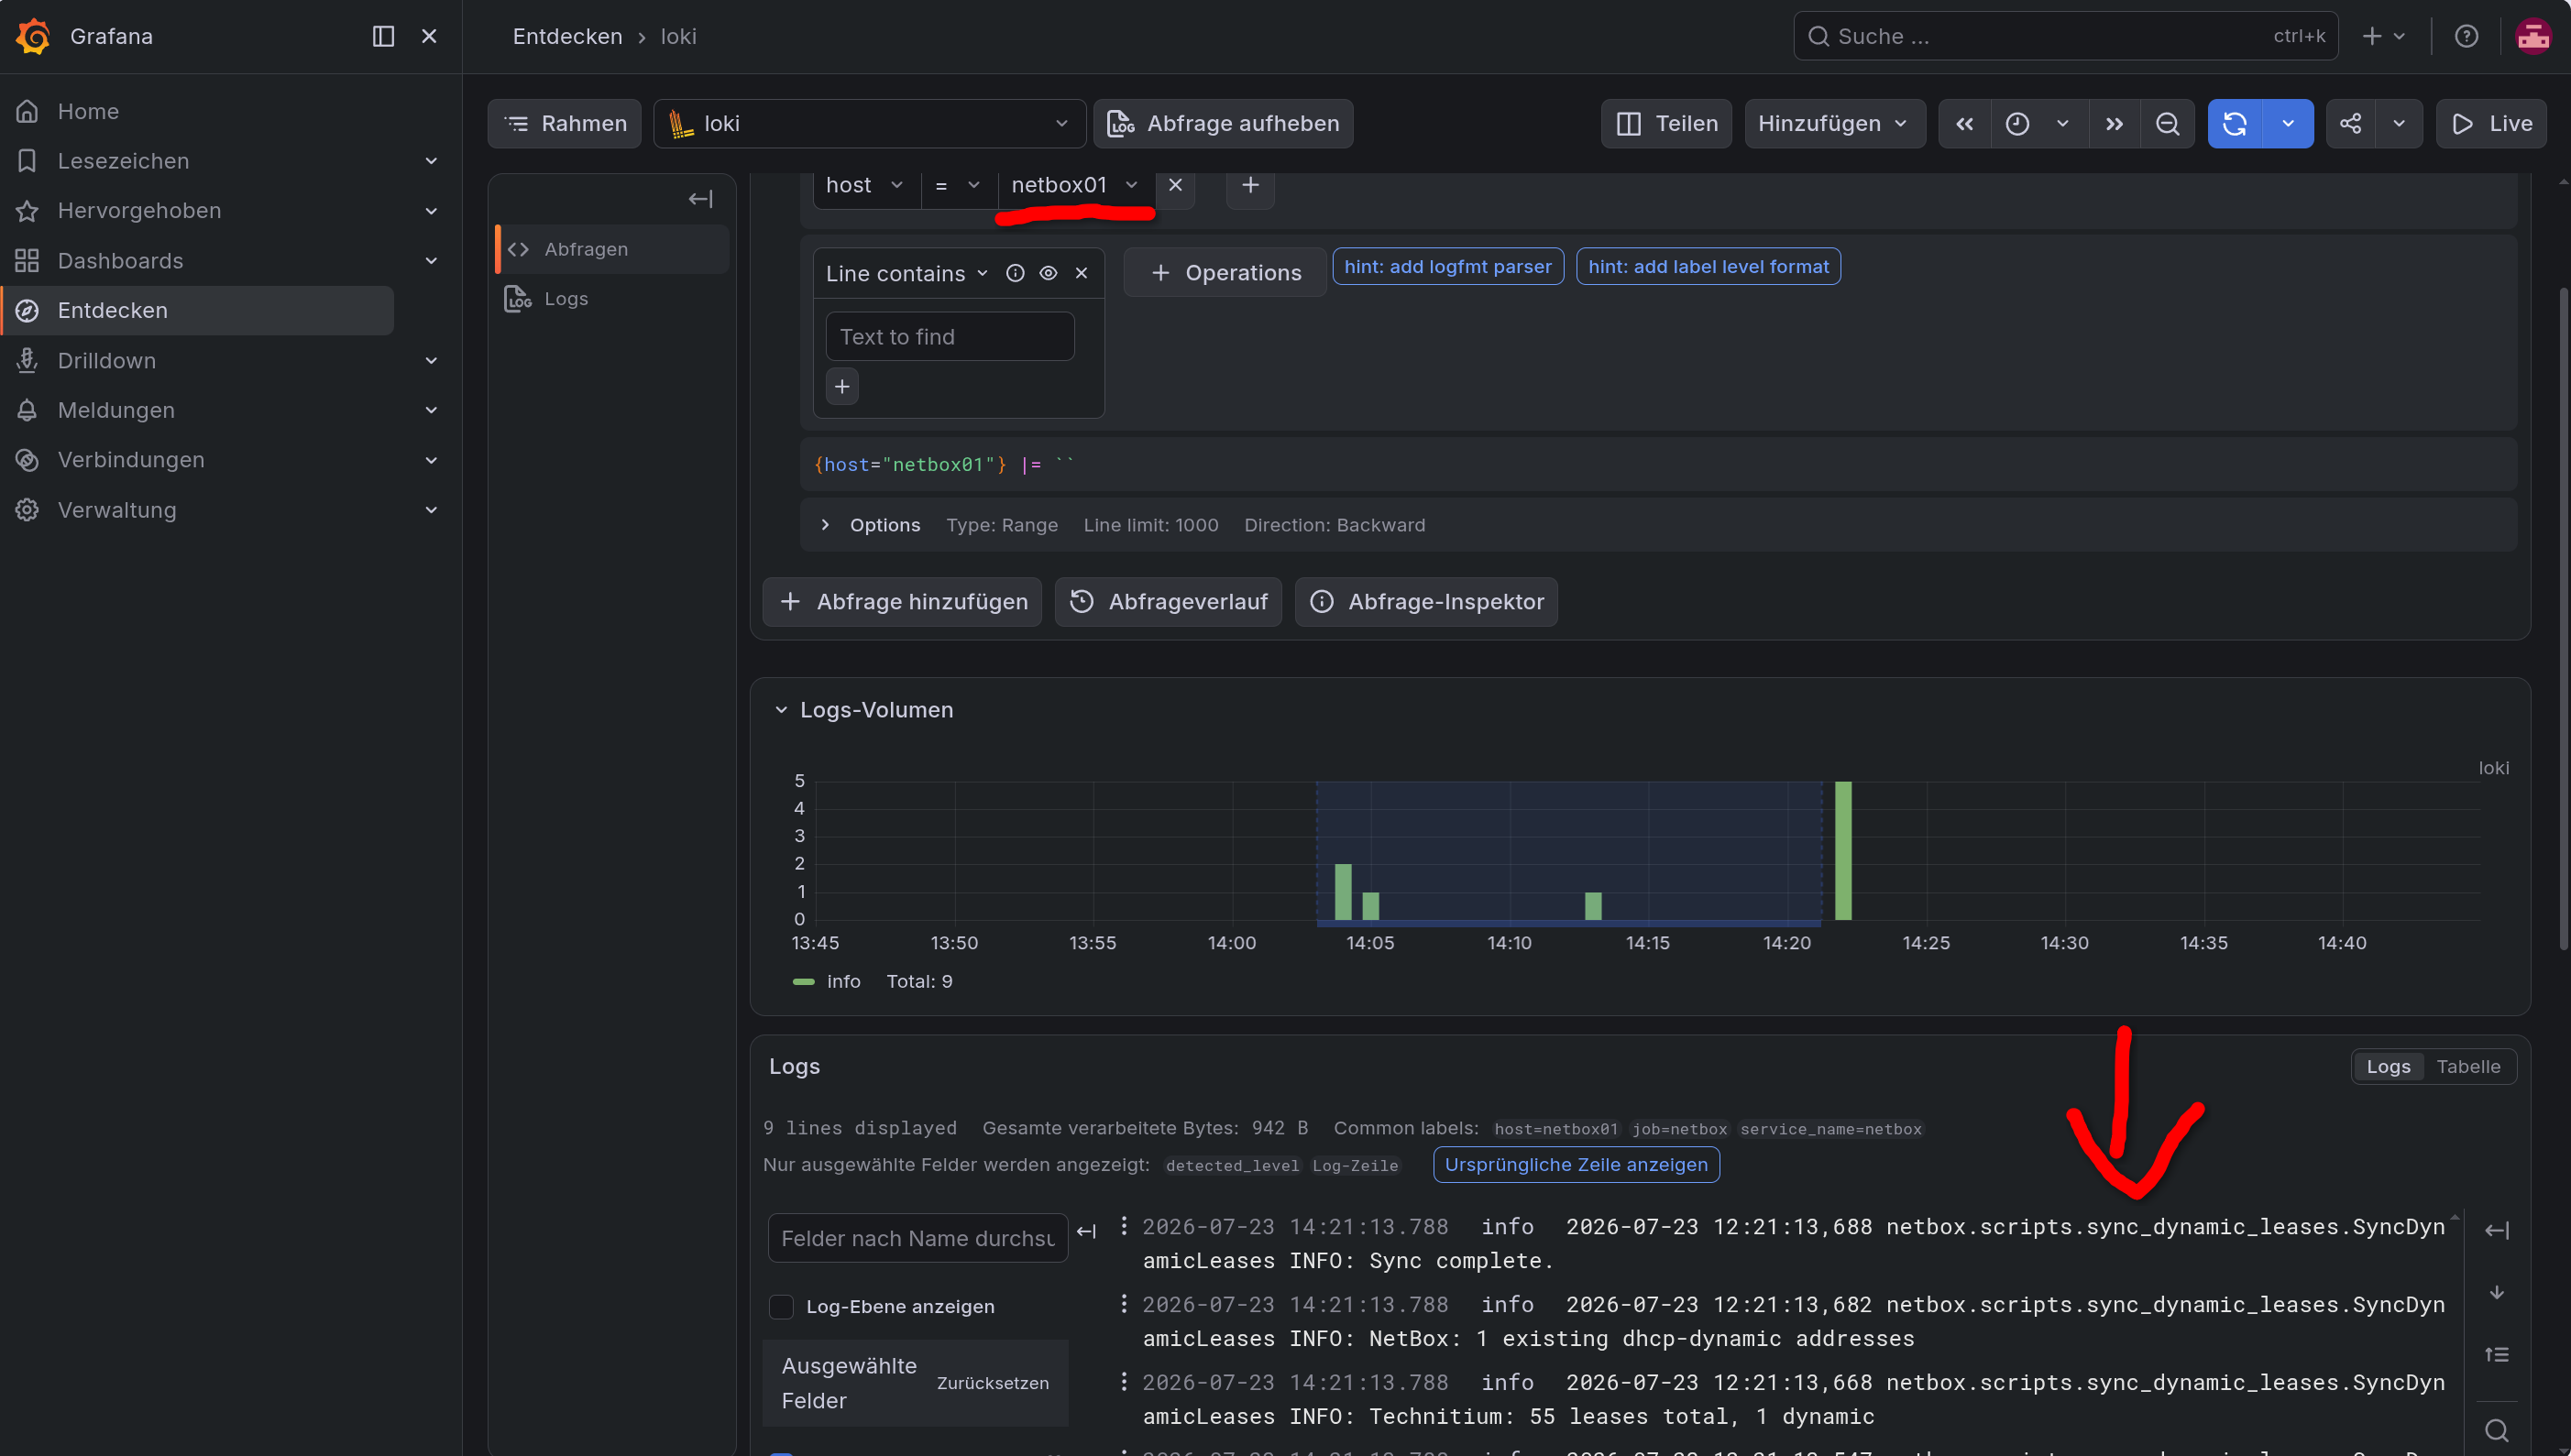
Bildschirmfoto_20260723_144248.png
Bildschirmfoto_20260723_144514.png

In Grafana kann ich jetzt mit einem Klick zwischen den Logs der einzelnen Services/Geräte hin- und herschalten. Man kann so auch die Logs mehrerer Geräte im gleichen Zeitraum nebeneinanderlegen, die Logs bequem durchsuchen oder sich anhand von Mustern oder Schlüsselwörtern alarmieren lassen. Wie cool ist das denn bitte! 😃 Der Aufwand hat sich definitiv gelohnt. Das Einbinden der restlichen Geräte werde ich nun der Reihe nach durchführen, dann geht’s weiter mit Ansible.
NUT - Stromausfall 2. Teil

Heute morgen haben wir im Betrieb festgestellt, dass der Server nicht läuft und das Telefon (100% Sip) nicht funktioniert. Der ganze Serverschrank war ohne Strom. Eine Meldung habe ich nicht bekommen, ein Blick auf Tailscale zeigte, dass alle Geräte im Betrieb bereits seit gestern 😳 15:36 nicht mehr online waren (Mittwoch Nachmittag haben wir geschlossen). Eine kurze Analyse der Logfiles auf pve02 (Proxmox PVE auf einem DXP4400) zeigte, dass der Server sich hart und ohne Vorankündigung verabschiedet hat. Eine Warnung über NUT hat nicht statt gefunden. Die USB Verbindung zwischen NUT und der USV hat aber dank meines Scripts bis zur letzten Sekunden bestanden. Eine Abfrage von NUT zeigte dann

Jul 16 01:04:12 pve02 nut-monitor[1611]: UPS usv-giesing@localhost battery needs to be replaced

Der Akku scheint kaputt zu sein und die USV ist grade mal 2 Jahre alt. (Memo: Diesen Fall muss man zukünftig ebenfalls für eine Emailbenachrichtigung abbilden) Ich hatte bereits eine Ersatz USV bestellt und konnte mit der neuen USV mein System relativ zügig wieder hochfahren. Downtime zur Betriebszeit waren also insgesamt nur ca. 15 Minuten. Ich sende erst seit gestern die Logs meines privaten PVEs an Loki, den PVE im Betrieb habe ich noch nicht eingebunden. Das hole ich heute gleich nach, in Zukunft kann ich mich dann (hoffentlich) warnen lassen. Der Exkurs zu Alloy/Loki/Grafana macht also durchaus Sinn.

Mittwoch, Juli 22, 2026

Netbox - Einbinden weiterer Geräte in Alloy/Loki/Grafana - PVE

Nach meinem kleinen ungeplanten Exkurs bezüglich “Codedarstellung in Flatpress” kann ich mich wieder dem ursprünglichen Exkurs “zentrales Logging”, vom eigentlichen Hauptthema “Zentrale Steuerung via NetBox”, widmen. Man kommt schnell vom 100sten ins 1000ste, wenn man nicht aufpasst. Nun binde ich mal einen PVE ein. Hoffentlich geht das etwas simpler als die beiden vorherigen Dienste (NetBox & Technitium). Danach muss ich unbedingt noch die Aufräumfunktion für Logs in Alloy/Loki ansehen, sonst läuft mir das LXC ruckzuck mit Logfiles voll. Log-Housekeeping bekommt danach auch einen eigenen Artikel, doch zunächst zurück zu PVE/Loki.

Zuerst kläre ich mal, welche Uhrzeit überhaupt in PVE läuft

Bildschirmfoto_20260722_173156.png

irgendwie sehen die rohen Logs von PVE aber auch so aus, als ob sie Loki vom Format her nicht schmecken würden. Ich lese also doch mal lieber die Alloy/Loki-Doku, was ich von Anfang an hätte tun sollen, und stelle fest, dass ich die anderen beiden Geräte mit einer meiner irrsinnigen Overengineering-Frickellösungen “falsch” eingerichtet habe. 😂 Es funktioniert zwar, geht aber über einen Alloy-Agent VIEL einfacher. Das probieren wir doch gleich mal in PVE aus und revertieren danach die anderen beiden Dienste wieder.

Ich bin natürlich nicht der Erste, der Alloy mit PVE verheiraten will. Wie man Alloy am besten in PVE einbindet, wurde im Proxmox-Forum bereits diskutiert. Der Kommentar #8 klingt jedenfalls interessant. Der Kollege hat via Ansible nicht nur remote auf allen Zielgeräten den Alloy-Agent deployed, sondern er hält ihn über Ansible auch aktuell. Sehr clever 😃

Ich wollte auf den PVE-Hosts eigentlich so wenig wie möglich installieren, bei NUT habe ich bereits eine Ausnahme gemacht, eigentlich gefällt es mir nicht so gut, zusätzliche Software auf den PVE-Hosts selbst zu installieren. Ein eigenes LXC nur für Alloy klingt aber auch nicht viel besser. Ich habe mal im deutschen Discord-Channel der Community-Scripts nachgefragt, wie die Profis das so machen, aber MickLesk hat mich scheinbar missverstanden: Er dachte wohl, ich will zentral Metriken sammeln, was bei PVE wenig Sinn machen würde.

Ich gehe mal den direkten Weg und installiere Alloy direkt auf PVE:

apt update && apt install -y gpg wget
mkdir -p /etc/apt/keyrings #kann entfallen, falls es das Verzeichnis schon gibt
wget -q -O /etc/apt/keyrings/grafana.asc https://apt.grafana.com/gpg-full.key
chmod 644 /etc/apt/keyrings/grafana.asc
echo "deb [signed-by=/etc/apt/keyrings/grafana.asc] https://apt.grafana.com stable main" 
  | tee /etc/apt/sources.list.d/grafana.list
apt update
apt install -y alloy

Danach muss ich dem Alloy-Agent auf dem PVE noch eine passende Config verpassen. Den Inhalt von /etc/alloy/config.alloy auf dem PVE habe ich ersetzt durch:

loki.source.journal "pve_journal" {
  forward_to    = [loki.write.central.receiver]
  relabel_rules = loki.relabel.journal.rules
  labels        = {
    job  = "systemd-journal",
    host = "pve01",
  }
}
loki.relabel "journal" {
  forward_to = []
  rule {
    source_labels = ["__journal__systemd_unit"]
    target_label  = "unit"
  }
}
loki.write "central" {
  endpoint {
    url = "http://192.168.2.12:3100/loki/api/v1/push"
  }
}

und starten/enablen mit:

systemctl enable --now alloy
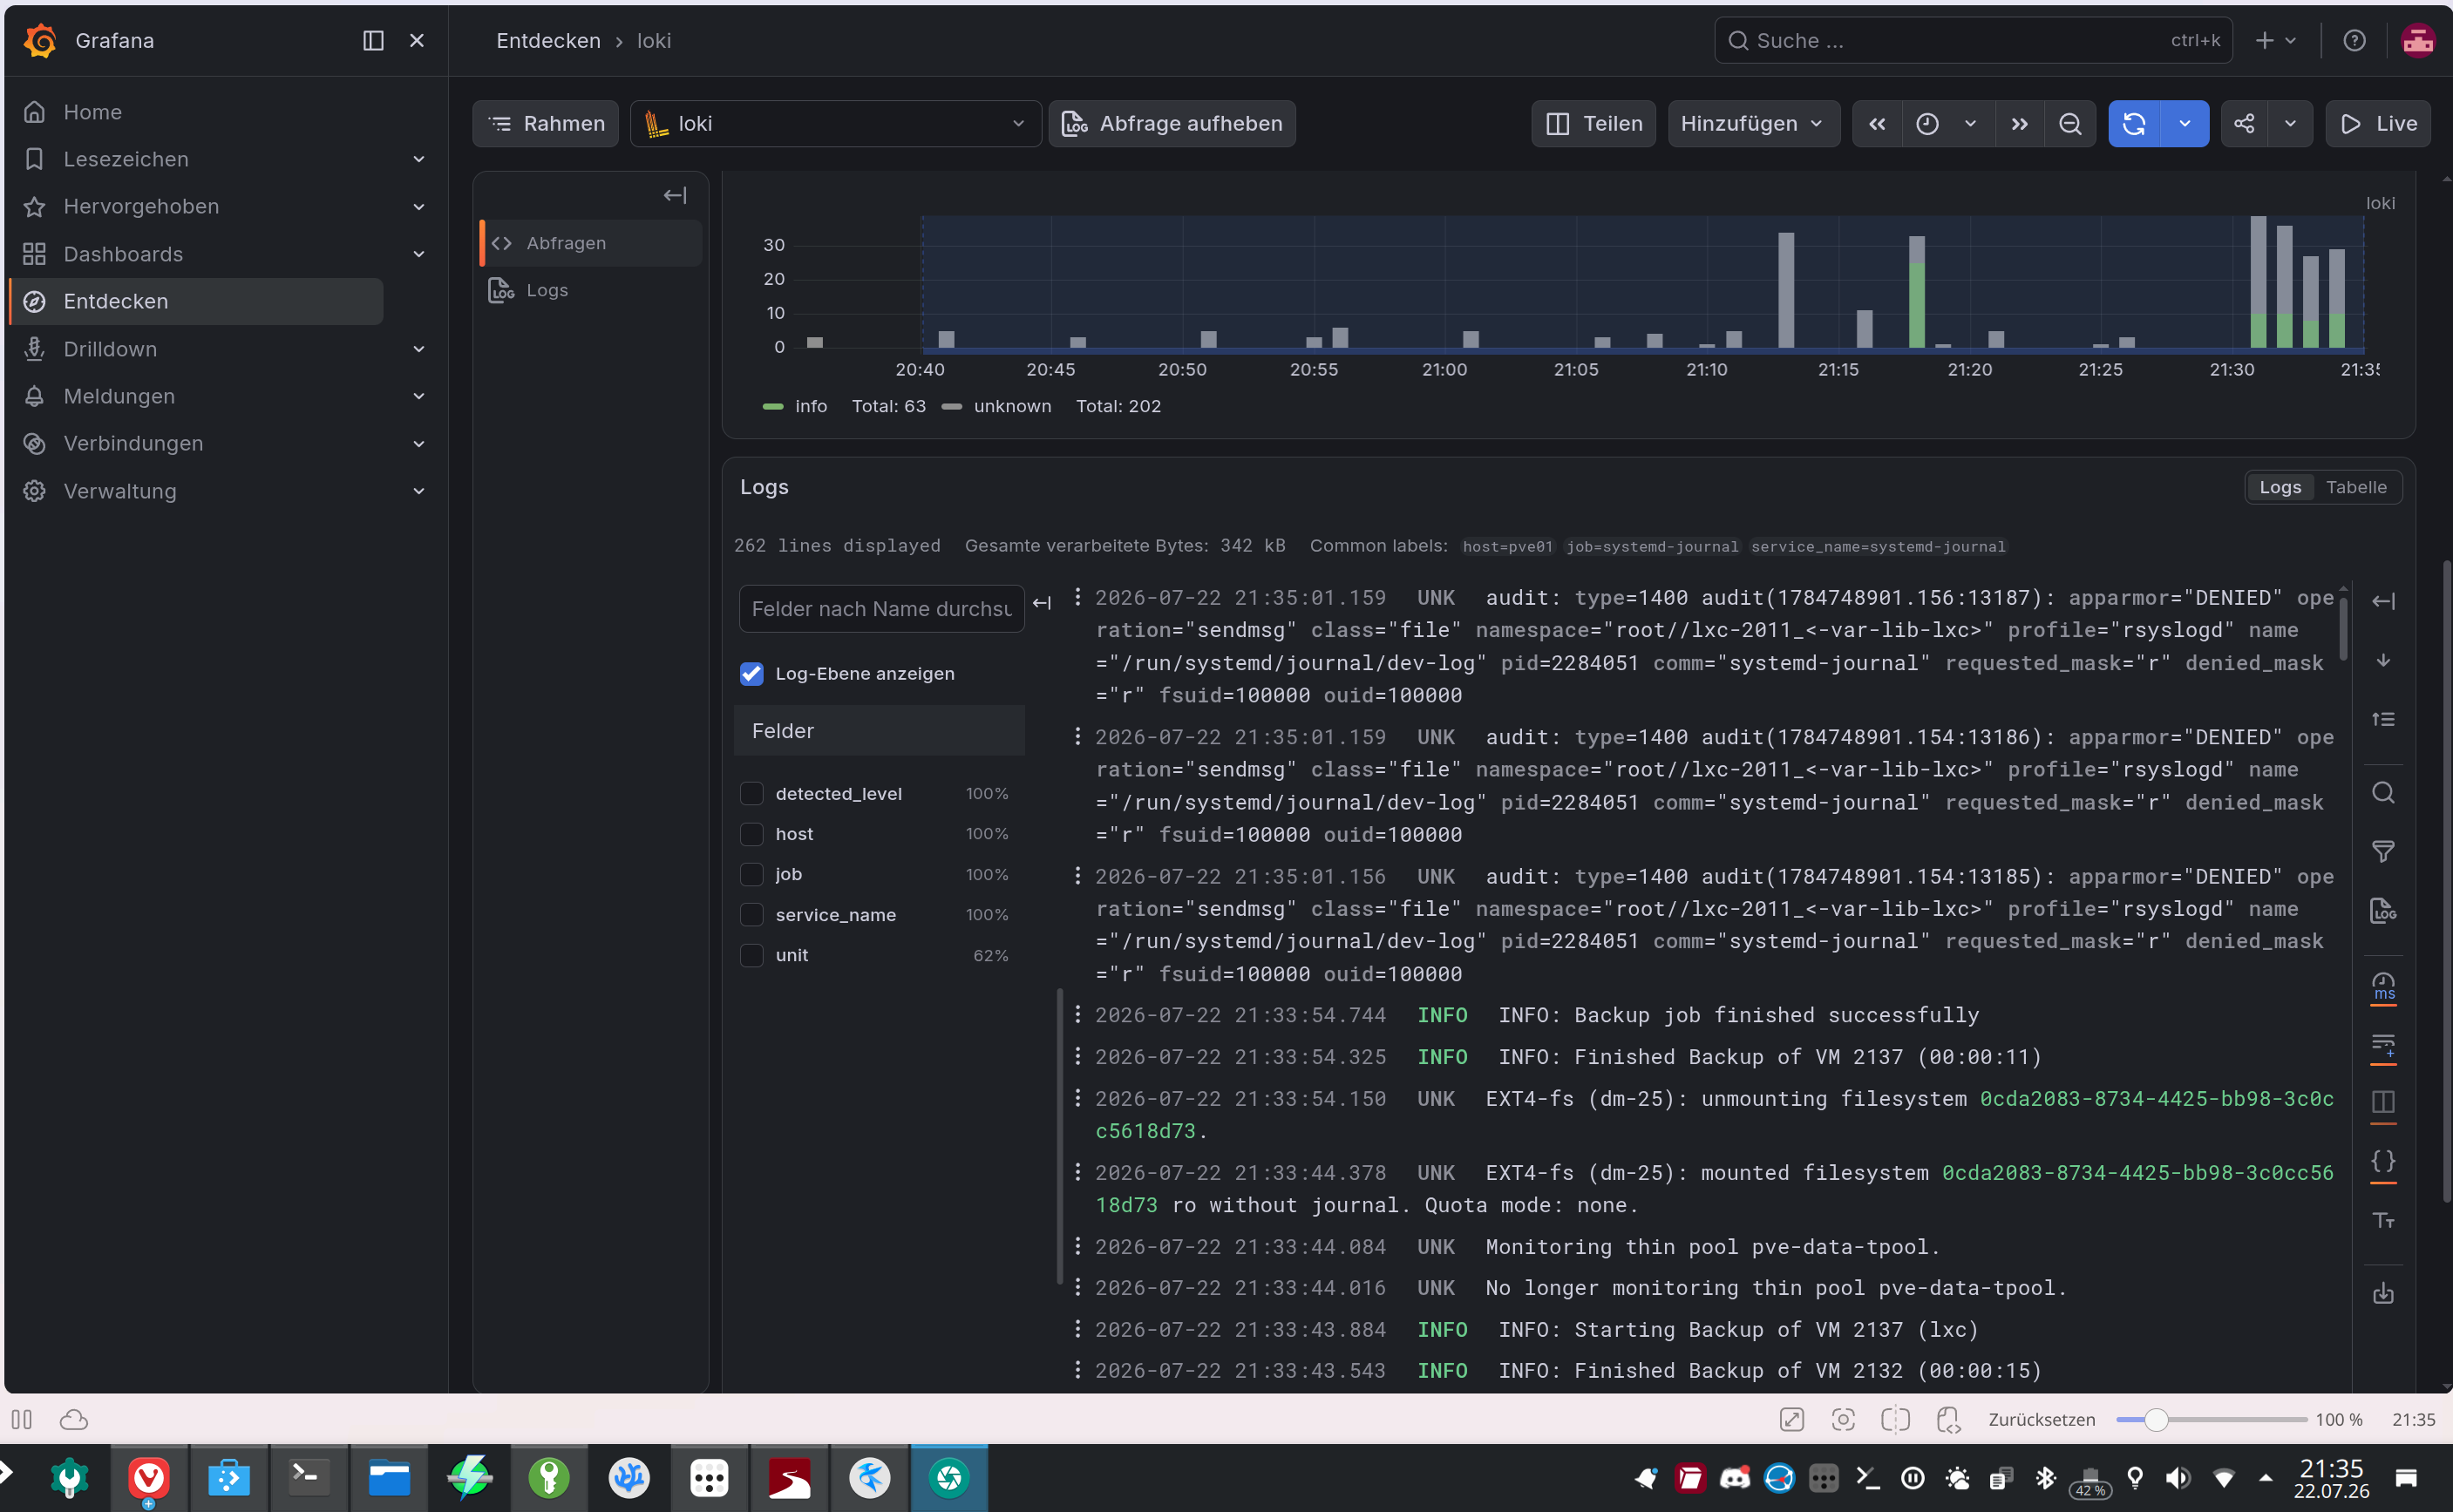
Bildschirmfoto_20260722_213550.png

Da sind die PVE Logs in Grafana. Das war wesentlich einfacher als meine Verrenkungen davor.