Montag, September 14, 2026

Netbox - Anpassung der Semaphore Playbooks nach Update von Netbox auf 4.7.0

Netbox/Semaphore usw. läuft bisher nur bei mir zuhause und wie sich aktuell zeigt, aus gutem Grund. Das letzte Netbox Update, genauer gesagt ein Update des DHCP Plugins hat beim Sprung auf Netbox 4.7.0 diverse Änderungen mit sich gebracht, die eines meiner Playbooks leider in die Knie gezwungen haben. Das DHCP Plugin von Peter Eckel ist weiterhin beta, weswegen ich das Setup mit Netbox/Semaphore auch weiterhin (noch) nicht in einem produktiven Umfeld einsetzen werde. Ich vermute die Änderungen vom 04.08.26 im Netbox DHCP Plugin sind der konkrete Grund.

Die Fehlermeldung bei Semaphore lautet (exemplarisch für das dashy LXC):

7:35:10 PM
ok: [dns-redacted] => (item=dashy) => {
7:35:10 PM
    "msg": "WARNUNG: dashy hat hw_address_id={'id': 7, 'url': 'https://192.168.2.10/api/dcim/mac-addresses/7/', 'display': 'BC:24:11:xx:xx:xx', 'mac_address': 'BC:24:11:xx:xx:xx', 'description': ''}, keine passende MAC in mac_lookup gefunden - wird uebersprungen"
7:35:10 PM
}

ich habe jedenfalls das dhcp-push skript an die neuen Gegebenheiten angepasst. –>

---
# push-dhcp-standort-a.yml
#
# Discovery-Phase: schreibt noch NICHTS in Technitium, liest nur
# Host-Reservations aus netbox-plugin-dhcp + Scope-Config aus Technitium.
#
# Aufruf:
#   ansible-playbook -i inventory/netbox.yml push-dhcp-standort-a.yml --limit dns-standort-a
- name: DHCP-Reservierungen NetBox <-> Technitium - Discovery
  hosts: dns-standort-a
  gather_facts: false
  vars:
    netbox_api: "https://192.168.2.10"
    netbox_token: "{{ lookup('env', 'NETBOX_TOKEN') }}"
    technitium_url: "https://{{ ansible_host }}:53443"
    technitium_token: "{{ lookup('env', 'TECHNITIUM_TOKEN') }}"
    target_vrf_name: "VRF Standort A"
    technitium_scope_name: "StandortA"
    dry_run: true  # true = nur anzeigen, kein Schreibzugriff
  tasks:
    - name: Alle VRFs holen (ungefiltert, wegen Leerzeichen im Namen)
      ansible.builtin.set_fact:
        all_vrfs: >-
          {{ query('netbox.netbox.nb_lookup', 'vrfs',
                    api_endpoint=netbox_api, token=netbox_token,
                    validate_certs=false)
             | map(attribute='value') | list }}
    - name: Ziel-VRF lokal per Namen herausfiltern
      ansible.builtin.set_fact:
        target_vrf: "{{ all_vrfs | selectattr('name', 'equalto', target_vrf_name) | first }}"
    - name: Prefixe der Ziel-VRF holen
      ansible.builtin.set_fact:
        target_prefixes: >-
          {{ query('netbox.netbox.nb_lookup', 'prefixes',
                    api_endpoint=netbox_api, token=netbox_token,
                    api_filter='vrf_id=' ~ target_vrf.id, validate_certs=false)
             | map(attribute='value') | map(attribute='prefix') | list }}
    - name: Alle Host Reservations holen
      ansible.builtin.set_fact:
        all_dhcp_reservations: >-
          {{ query('netbox.netbox.nb_lookup', 'hostreservations',
                    api_endpoint=netbox_api, token=netbox_token,
                    plugin='netbox-dhcp', validate_certs=false)
             | map(attribute='value') | list }}
    - name: Anzahl gefundener Reservations
      ansible.builtin.debug:
        msg: "{{ all_dhcp_reservations | length }} Host Reservations gesamt gefunden"
    # Fallback-Lookup fuer den Fall, dass hw_address wieder nur eine ID liefert
    # (Plugin < 0.1.10). Seit 0.1.10 ("Fixed nested serializers") liefert
    # hw_address bereits ein verschachteltes Objekt inkl. mac_address.
    - name: MAC-Address-Objekte holen (limit=0, fuer Lookup-Fallback)
      ansible.builtin.uri:
        url: "{{ netbox_api }}/api/dcim/mac-addresses/?limit=0"
        method: GET
        headers:
          Authorization: "Token {{ netbox_token }}"
        validate_certs: false
        status_code: [200]
      register: mac_addresses_raw
      ignore_errors: true
    - name: MAC-Adressen-Lookup-Tabelle bauen (id -> mac_address, Fallback)
      ansible.builtin.set_fact:
        mac_lookup: "{{ dict(mac_addresses_raw.json.results | map(attribute='id') | map('string')
                         | zip(mac_addresses_raw.json.results | map(attribute='mac_address'))) }}"
      when: mac_addresses_raw.json is defined and mac_addresses_raw.json.results is defined
    - name: Aktuelle Technitium-Scope-Konfiguration holen (inkl. reservedLeases)
      ansible.builtin.uri:
        url: "{{ technitium_url }}/api/dhcp/scopes/get"
        method: GET
        body_format: form-urlencoded
        body:
          token: "{{ technitium_token }}"
          name: "{{ technitium_scope_name }}"
        validate_certs: false
        status_code: [200]
      register: technitium_scope_raw
      no_log: true
    # -----------------------------------------------------------------
    # Push-Vorbereitung (noch kein Schreibzugriff)
    # -----------------------------------------------------------------
    - name: Ziel-Reservierungen filtern (IP innerhalb Ziel-VRF-Prefixe)
      ansible.builtin.set_fact:
        site_reservations: "{{ site_reservations | default([]) + [item] }}"
      loop: "{{ all_dhcp_reservations }}"
      loop_control:
        label: "{{ item.hostname }}"
      vars:
        record_ip: "{{ item.ipv4_address.address | ansible.utils.ipaddr('address') }}"
      when:
        - item.ipv4_address is defined
        - item.ipv4_address.address is defined
        - record_ip is ansible.utils.in_one_network target_prefixes
    # hw_address ist seit Plugin 0.1.10 ein verschachteltes Objekt mit
    # mac_address inline; nutze das direkt, mit Fallback auf mac_lookup.
    - name: Ziel-Reservierungen im Technitium-Format aufbauen
      ansible.builtin.set_fact:
        target_reserved_leases: "{{ target_reserved_leases | default([]) + [{
          'hostName': item.hostname,
          'address': item.ipv4_address.address | ansible.utils.ipaddr('address'),
          'hardwareAddress': (
            (item.hw_address.mac_address if (item.hw_address is mapping and item.hw_address.mac_address is defined)
             else mac_lookup[item.hw_address | string] | default('UNBEKANNT'))
            | replace(':', '-') | upper
          ),
          'comments': item.comments | default(None)
        }] }}"
      loop: "{{ site_reservations | default([]) }}"
      loop_control:
        label: "{{ item.hostname }}"
      when: >-
        item.hw_address is defined and
        ((item.hw_address is mapping and item.hw_address.mac_address is defined)
         or (item.hw_address is not mapping and (item.hw_address | string) in mac_lookup))
    - name: Reservierungen ohne aufgeloeste MAC warnen (werden NICHT gepusht)
      ansible.builtin.debug:
        msg: "WARNUNG: {{ item.hostname }} hat hw_address={{ item.hw_address | default('NULL') }}, keine MAC aufloesbar - wird uebersprungen"
      loop: "{{ site_reservations | default([]) }}"
      loop_control:
        label: "{{ item.hostname }}"
      when: >-
        not (item.hw_address is defined and
             ((item.hw_address is mapping and item.hw_address.mac_address is defined)
              or (item.hw_address is not mapping and (item.hw_address | string) in mac_lookup)))
    - name: Anzahl push-bereiter Reservierungen
      ansible.builtin.debug:
        msg: "{{ target_reserved_leases | default([]) | length }} von {{ site_reservations | default([]) | length }} push-bereit"
    - name: "DRY RUN - geplante reservedLeases-Liste anzeigen"
      ansible.builtin.debug:
        var: target_reserved_leases
      when: dry_run | bool
    - name: Bestehende Technitium-Reservierungen nach hardwareAddress indexieren
      ansible.builtin.set_fact:
        existing_leases_by_mac: "{{ dict(technitium_scope_raw.json.response.reservedLeases | map(attribute='hardwareAddress')
                                     | zip(technitium_scope_raw.json.response.reservedLeases)) }}"
    - name: Aktionsplan bauen (neu / aendern / unveraendert)
      ansible.builtin.set_fact:
        lease_actions: "{{ lease_actions | default([]) + [{
          'mac': item.hardwareAddress,
          'target': item,
          'existing': existing_leases_by_mac.get(item.hardwareAddress),
          'action': ('unveraendert'
                     if (existing_leases_by_mac.get(item.hardwareAddress) is not none and
                         existing_leases_by_mac[item.hardwareAddress].address == item.address and
                         existing_leases_by_mac[item.hardwareAddress].hostName == item.hostName)
                     else ('aendern' if existing_leases_by_mac.get(item.hardwareAddress) is not none else 'neu'))
        }] }}"
      loop: "{{ target_reserved_leases | default([]) }}"
      loop_control:
        label: "{{ item.hostName }}"
        loop_var: item
    - name: Zusammenfassung des Aktionsplans
      ansible.builtin.debug:
        msg: >-
          {{ lease_actions | selectattr('action', 'equalto', 'neu') | list | length }} neu,
          {{ lease_actions | selectattr('action', 'equalto', 'aendern') | list | length }} aendern,
          {{ lease_actions | selectattr('action', 'equalto', 'unveraendert') | list | length }} unveraendert
    - name: "DRY RUN - Details je geplanter Aktion"
      ansible.builtin.debug:
        msg: >-
          [{{ item.action | upper }}] {{ item.target.hostName }}
          ({{ item.mac }}) -> {{ item.target.address }}
          {{ '(vorher: ' ~ item.existing.hostName ~ ' -> ' ~ item.existing.address ~ ')' if item.action == 'aendern' else '' }}
      loop: "{{ lease_actions | rejectattr('action', 'equalto', 'unveraendert') | list }}"
      loop_control:
        label: "{{ item.target.hostName }}"
      when: dry_run | bool
    - name: Bestehende Reservierung entfernen vor Aenderung (Remove-vor-Add)
      ansible.builtin.uri:
        url: "{{ technitium_url }}/api/dhcp/scopes/removeReservedLease"
        method: POST
        body_format: form-urlencoded
        body:
          token: "{{ technitium_token }}"
          name: "{{ technitium_scope_name }}"
          hardwareAddress: "{{ item.mac }}"
        validate_certs: false
        status_code: [200]
      loop: "{{ lease_actions | selectattr('action', 'equalto', 'aendern') | list }}"
      loop_control:
        label: "{{ item.target.hostName }}"
      no_log: true
      register: remove_result
      when: not (dry_run | bool)
    - name: Reservierung anlegen (neu oder nach Remove bei Aenderung)
      ansible.builtin.uri:
        url: "{{ technitium_url }}/api/dhcp/scopes/addReservedLease"
        method: POST
        body_format: form-urlencoded
        body:
          token: "{{ technitium_token }}"
          name: "{{ technitium_scope_name }}"
          hardwareAddress: "{{ item.mac }}"
          ipAddress: "{{ item.target.address }}"
          hostName: "{{ item.target.hostName }}"
          comments: "{{ item.target.comments | default('') }}"
        validate_certs: false
        status_code: [200]
      loop: "{{ lease_actions | rejectattr('action', 'equalto', 'unveraendert') | list }}"
      loop_control:
        label: "{{ item.target.hostName }}"
      no_log: true
      register: add_result
      ignore_errors: true
      when: not (dry_run | bool)
    - name: Fehlgeschlagene Add-Aktionen auflisten
      ansible.builtin.debug:
        msg: "FEHLER bei {{ item.item.target.hostName }}: {{ item.msg | default('unbekannt') }}"
      loop: "{{ add_result.results | default([]) }}"
      loop_control:
        label: "{{ item.item.target.hostName }}"
      when:
        - not (dry_run | bool)
        - item.failed | default(false)

und kommentartechnisch ein bisschen gestrafft. Ich bin wegen der Fragilität meines aktuellen Setups etwas unglücklich. Ich werde die nächsten Tage ein paar alternative Ansätze bei dem Skript testen, die hoffentlich etwas robuster sind. Bei Netbox sind beim letzten Update diverse neue Felder hinzugekommen, das muss ich mir aber zunächst in Ruhe ansehen.

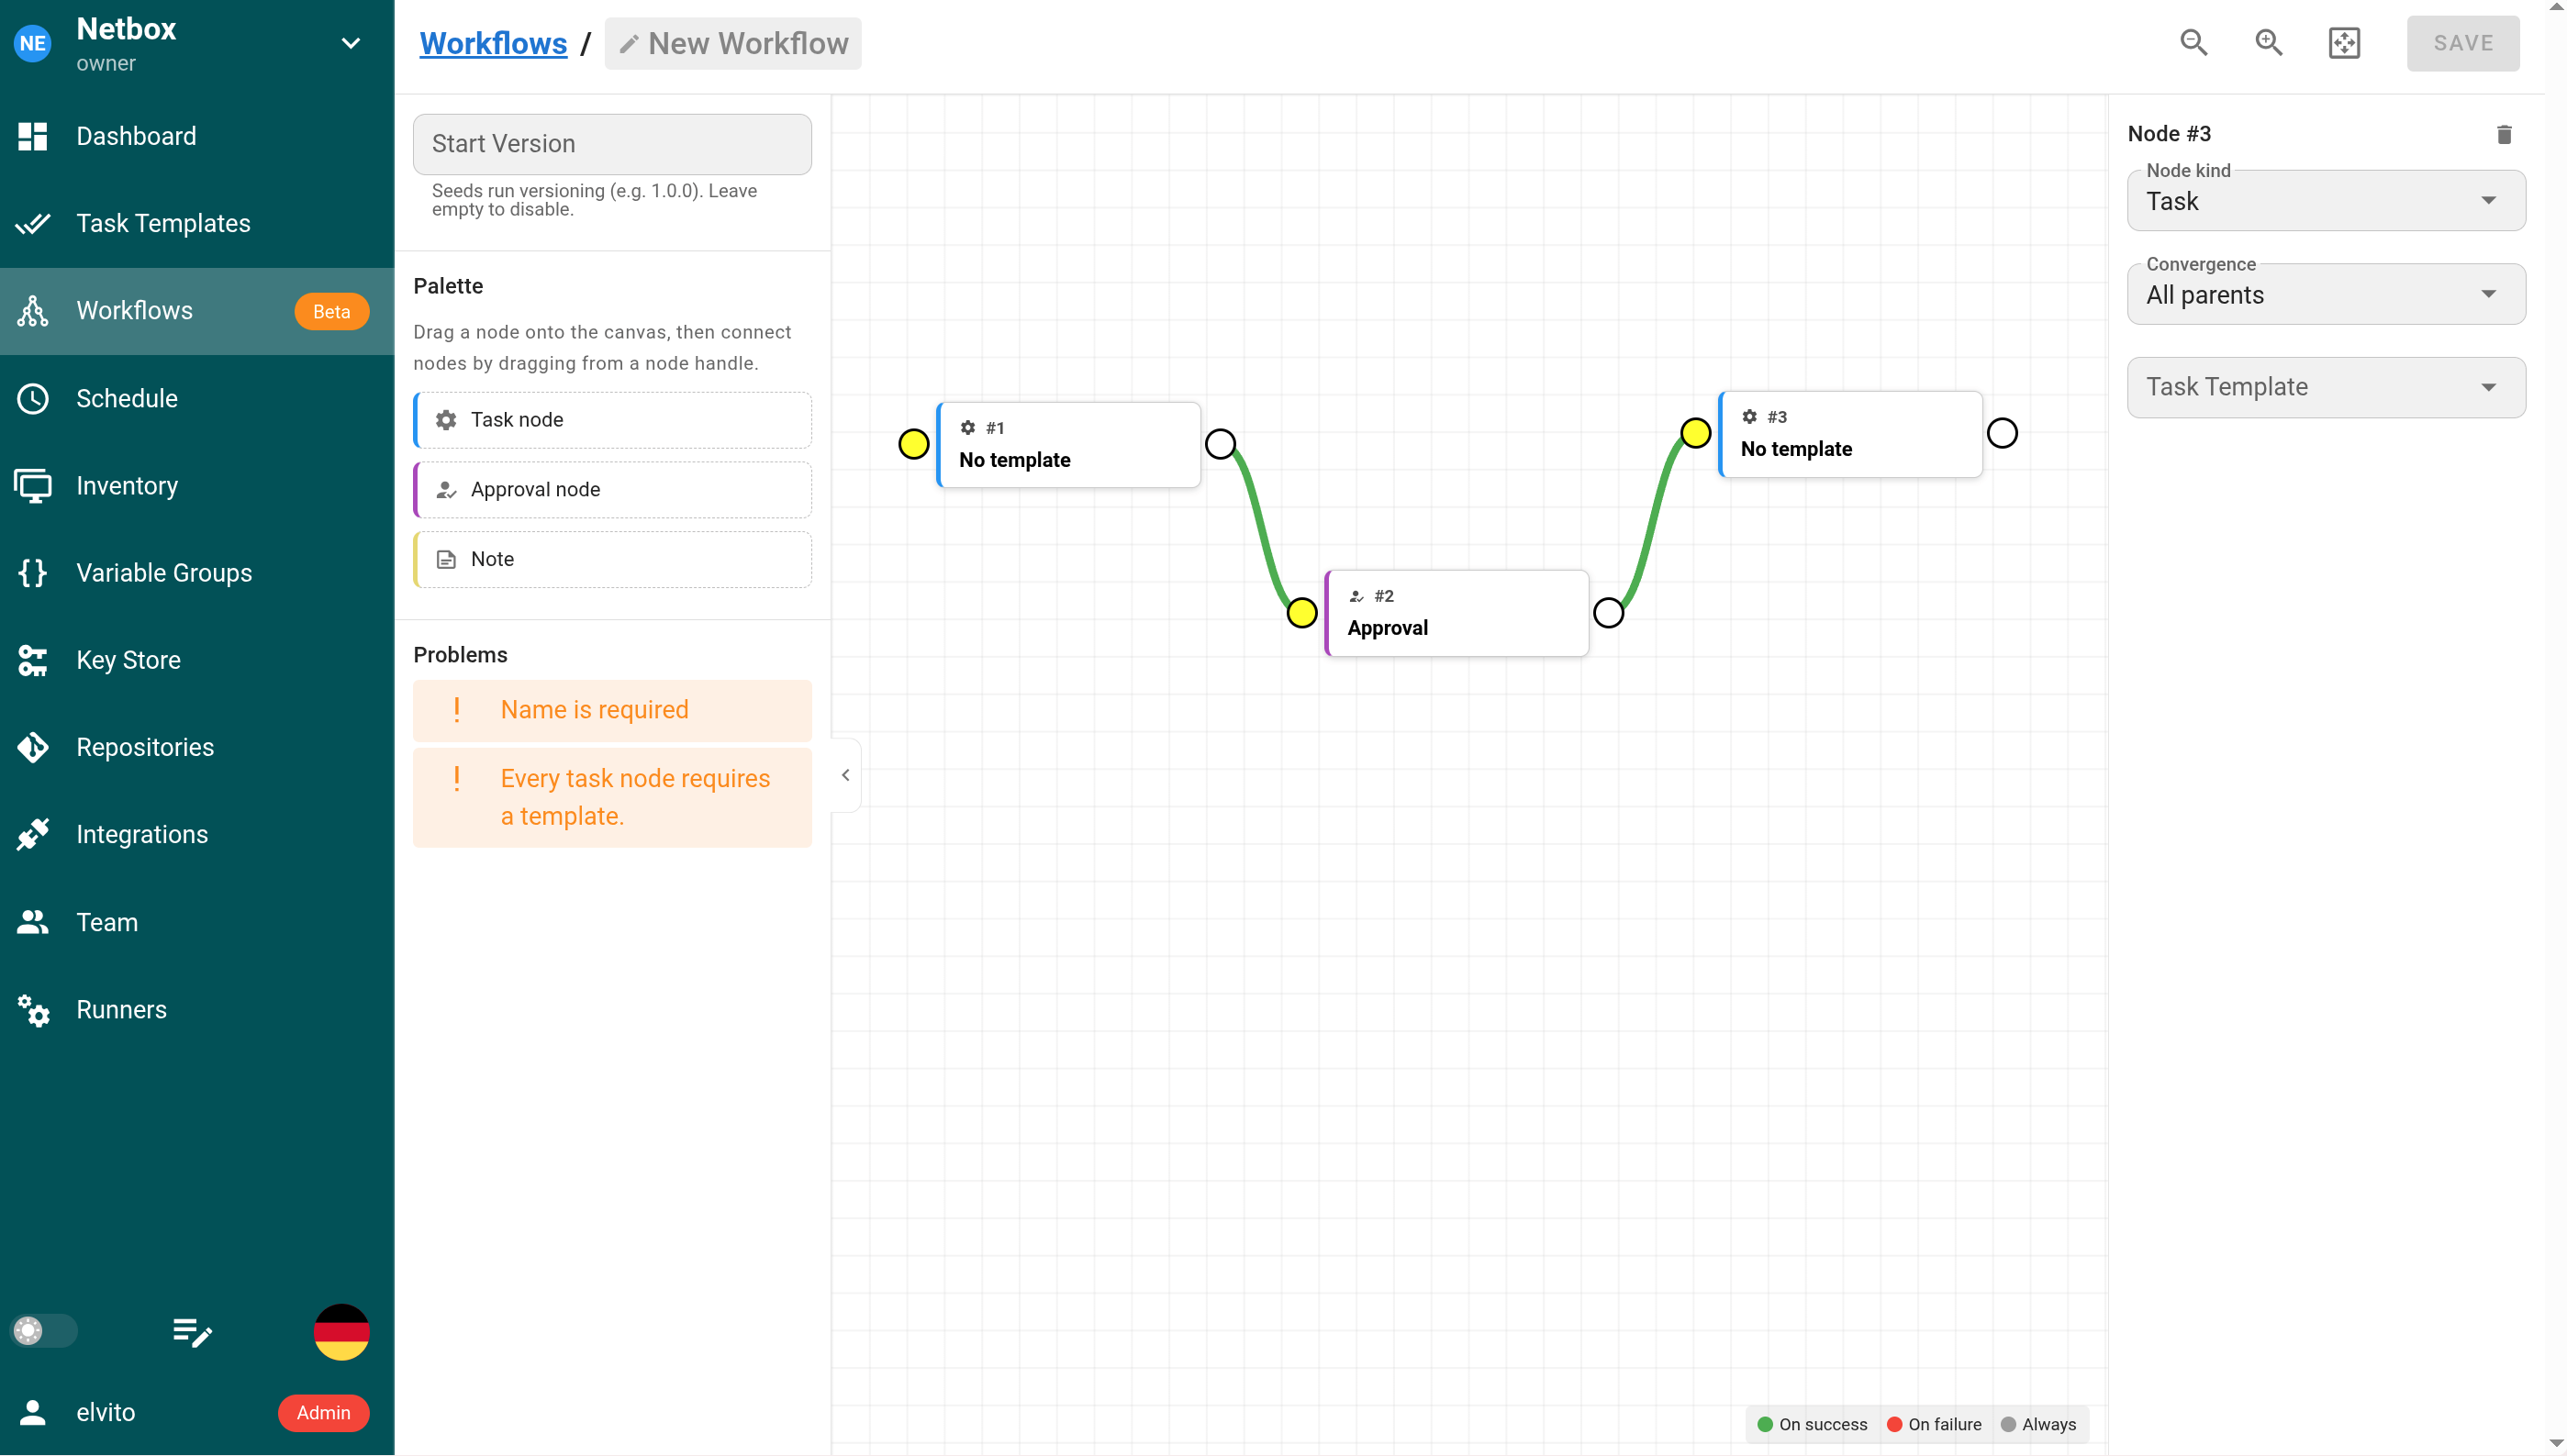
Nachtrag: Dafür wollte ich keinen eigenen neuen Blogpost erstellen, aber ich habe grade gesehen, dass es in Semaphore UI scheinbar als neues Feature sogenannte Workflows gibt –>
Bildschirmfoto_20260914_215305.png

Das sieht einem Blatt bei NodeRed verdächtig ähnlich. Damit ließen sich anschaulich verschiedene Playbooks miteinander verknüpfen bzw. aneinanderreihen, ggf sogar verschiedene Wege je nach Ausgabe wählen. Das sieht jedenfalls äußerst spannend aus und könnte meinen bisherigen Ansatz ganz erheblich vereinfachen. Man könnte die einzelnen Arbeitsschritte in einzelne Skripte modularisieren und durch Aneinanderreihung miteinander verknüpfen. Das wäre wesentlich einfacher zu warten, als ein monolithisches Skript das mit der Zeit immer größer und fehleranfälliger wird.
Dienstag, September 1, 2026

Netbox - PVE Manipulation/Auslesen von Settings via Semaphore/Netbox

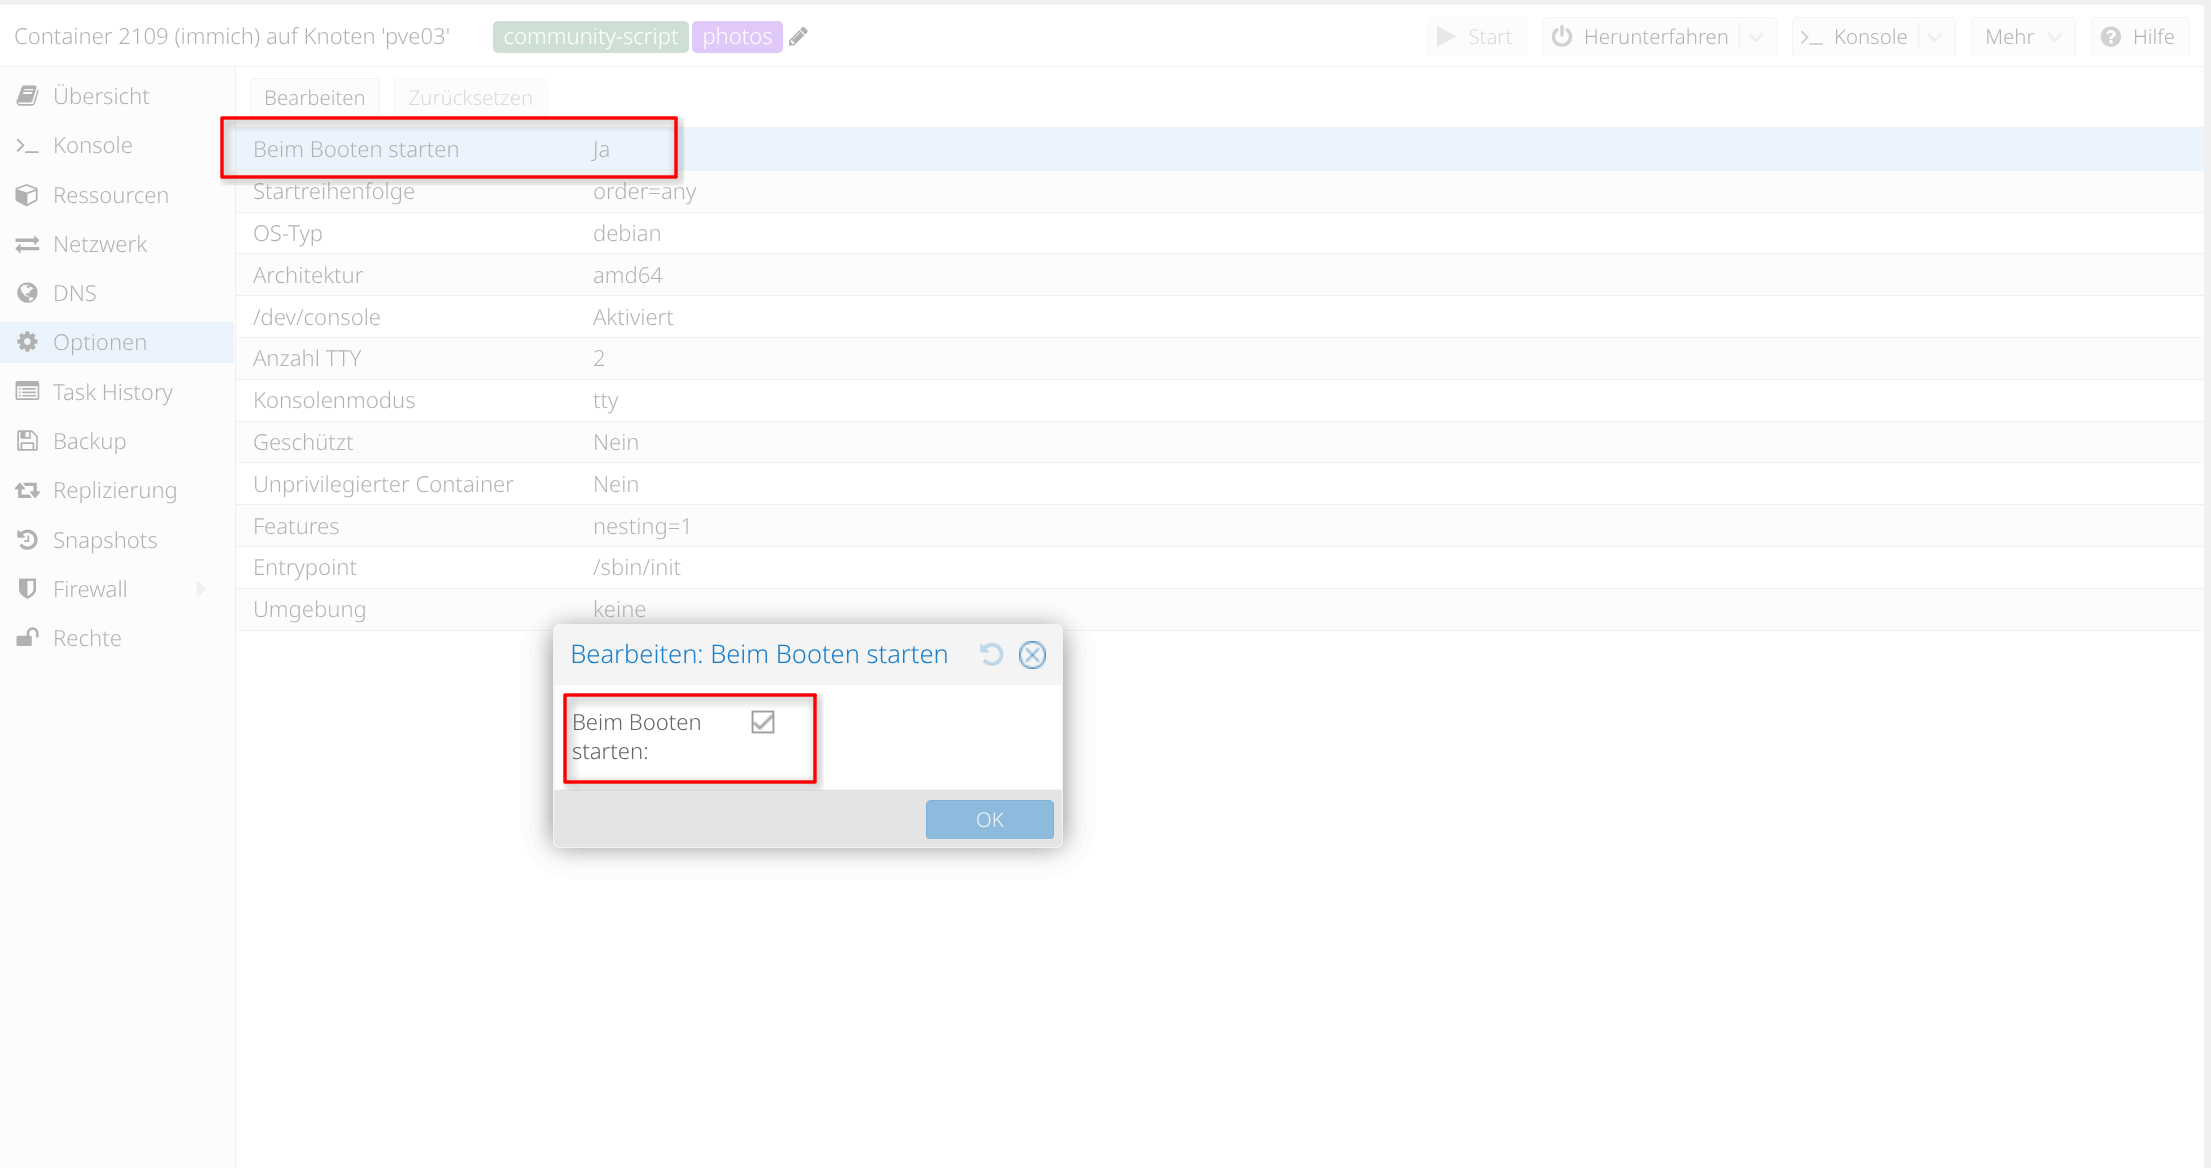
Manchmal möchte ich nach einem Reboot eines PVE Hosts nicht, dass die VMs und LXCs automatisch hochgefahren werden. Ich habe bisher vor so einem Reboot immer den Autostart Haken bei jedem einzelnen LXC und VM entfernen und später wieder setzen müssen.

Bildschirmfoto_20260902_131246.png

Das wollte ich unbedingt vereinfachen und gleichzeitig die jeweils aktuellen Settings der einzelnen VMs und LXCs nach Netbox synchronisieren. In diesem Fall dienen tatsächlich die jeweiligen PVE Hosts als “source of truth” für Netbox. Ich habe mir ausserdem das Leben etwas leichter gemacht, indem ich VSCodium (Opensource Alternative zu VSCode von M$) mit zwei praktischen Plugins nachgerüstet habe –> 1. Open Remote - SSH und 2. YAML. Open Remote - SSH macht entfernte Dateisysteme auf dem lokalen Rechner via ssh in VSCodium zugänglich und YAML hilft dabei keine Fehler z.B. bei den Leerzeichen in den Playbooks zu machen. Die Einrichtung erkläre ich hier nicht, das sollte jeder mit dem bereits vorhandenen Material selbst hinkriegen können. VSCodium kann nativ mit git commits umgehen, das macht das Anlegen und V.a. das Ändern von Playbooks wesentlich komfortabler.

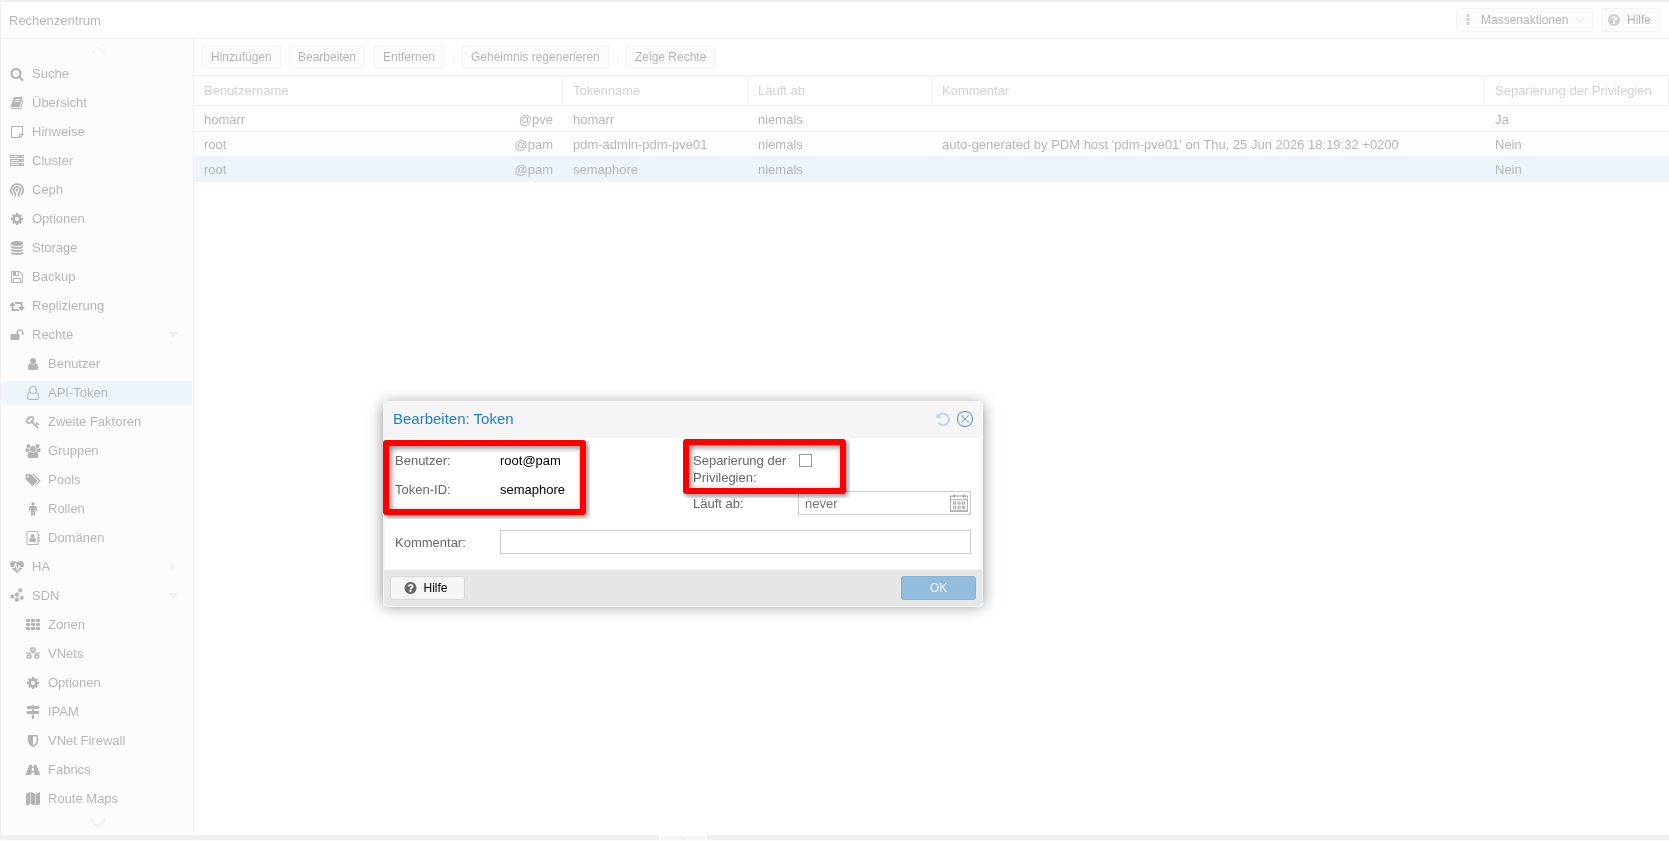
An den PVE Hosts die ferngesteuert und abgefragt werden sollen, müssen noch API Token generiert werden. Bei mir zuhause sind das zwei PVE Hosts, jeweils standalone. Ich muss also zwei API Token generieren. Der Token wird nur einmal, direkt nach dem Erzeugen angezeigt, es empfiehlt sich daher den Token an einem sicheren Ort (Passwortmanager) zu speichern.

Bildschirmfoto_20260901_153712.png

Bei den Playbooks habe ich ein neues yml File angelegt mit folgendem Inhalt:

---
- name: NetBox VM-Config gegen PVE abgleichen (Standort_A)
  hosts: localhost
  connection: local
  gather_facts: false
  vars:
    netbox_api: "https://192.168.2.10"
    netbox_token: "{{ lookup('env', 'NETBOX_TOKEN') }}"
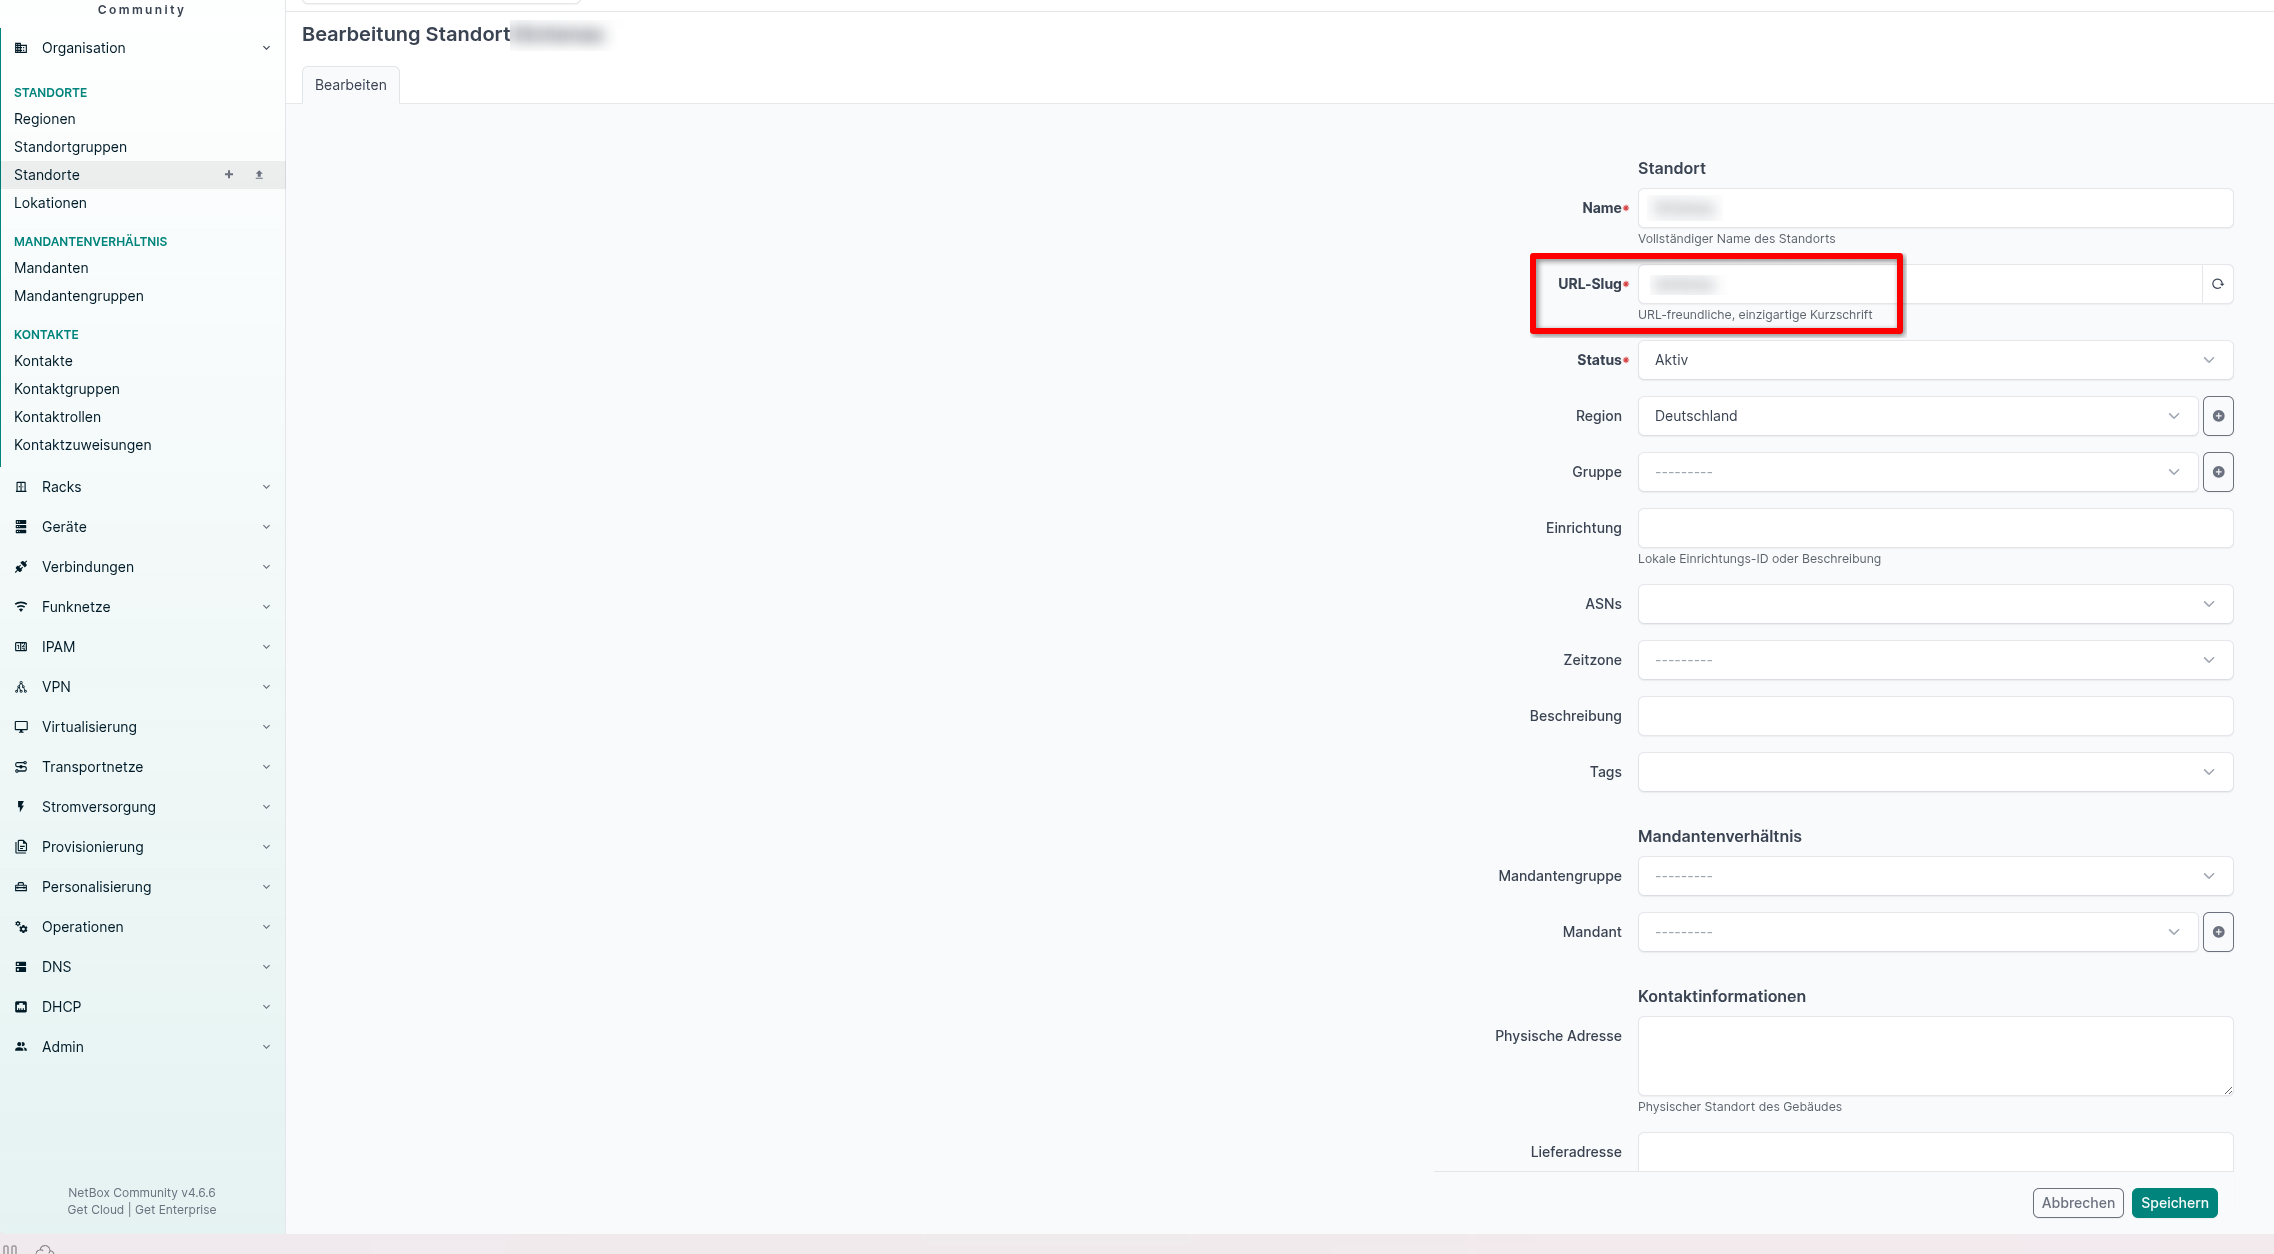
    # ACHTUNG: Slug, steht bei Standort und ist nur in Bearbeitung sichtbnar
    target_site_slug: "standort-a"
        pve_nodes:
      - name: pve01
        api: "https://192.168.2.16:8006/api2/json"
        token_id: "{{ lookup('env', 'PVE01_TOKEN_ID') }}"
        token_secret: "{{ lookup('env', 'PVE01_TOKEN_SECRET') }}"
      - name: pve03
        api: "https://192.168.2.18:8006/api2/json"
        token_id: "{{ lookup('env', 'PVE03_TOKEN_ID') }}"
        token_secret: "{{ lookup('env', 'PVE03_TOKEN_SECRET') }}"
        dry_run: false
    start_on_boot_enabled_value: "on"
    start_on_boot_disabled_value: "off"
    start_on_boot_laststate_value: "last-state"
    resource_drift: []
    onboot_actions: []
    netbox_update_actions: []
  tasks:
    # -----------------------------------------------------------------
    # 1. NetBox-VMs der Ziel-Site holen und auf vmid pruefen
    # -----------------------------------------------------------------
    - name: NetBox-VMs der Ziel-Site holen
      ansible.builtin.set_fact:
        netbox_vms: >-
          {{ query('netbox.netbox.nb_lookup', 'virtual-machines',
                    api_endpoint=netbox_api,
                    token=netbox_token,
                    api_filter='site=' ~ target_site_slug,
                    validate_certs=false)
             | map(attribute='value')
             | list }}
    - name: Anzahl gefundener NetBox-VMs
      ansible.builtin.debug:
        msg: "{{ netbox_vms | length }} VMs in NetBox fuer Site '{{ target_site_slug }}' gefunden"
    - name: Nur VMs mit gepflegter vmid behalten
      ansible.builtin.set_fact:
        netbox_vms_ready: >-
          {{ netbox_vms
             | selectattr('custom_fields.vmid', 'defined')
             | selectattr('custom_fields.vmid', 'ne', None)
             | list }}
        netbox_vms_incomplete: >-
          {{ netbox_vms
             | rejectattr('custom_fields.vmid', 'defined')
             | list
             + netbox_vms | selectattr('custom_fields.vmid', 'defined')
             | selectattr('custom_fields.vmid', 'equalto', None) | list }}
    - name: "WARNUNG - VMs ohne vmid in NetBox (werden uebersprungen)"
      ansible.builtin.debug:
        msg: "'{{ item.name }}': vmid={{ item.custom_fields.vmid | default('FEHLT') }}"
      loop: "{{ netbox_vms_incomplete }}"
      loop_control:
        label: "{{ item.name }}"
    # -----------------------------------------------------------------
    # 2. PVE-Ressourcen von BEIDEN Standalone-Nodes holen, zusammenfuehren
    #    und nach vmid indexieren (liefert vmid, name, node, maxcpu,
    #    maxmem, maxdisk - reicht fuer node-Aufloesung UND den
    #    vCPU/RAM/Disk-Diff)
    # -----------------------------------------------------------------
    - name: Ressourcen-Stand von JEDEM PVE-Node einzeln holen (Standalone, kein Proxmox-Cluster)
      ansible.builtin.uri:
        url: "{{ item.api }}/cluster/resources?type=vm"
        method: GET
        headers:
          Authorization: "PVEAPIToken={{ item.token_id }}={{ item.token_secret }}"
        validate_certs: false
        status_code: [200]
      loop: "{{ pve_nodes }}"
      loop_control:
        label: "{{ item.name }}"
      register: pve_resources_raw
      no_log: true
    - name: Ergebnisse aller Nodes zu einer Liste zusammenfuehren
      ansible.builtin.set_fact:
        pve_resources_all: >-
          {{ pve_resources_raw.results
             | map(attribute='json')
             | map(attribute='data')
             | flatten(levels=1) }}
    - name: PVE-Node-Name zu vollen Node-Infos (API-URL + Token) Lookup bauen
      ansible.builtin.set_fact:
        pve_node_lookup_helper: "{{ dict(pve_nodes | map(attribute='name') | list | zip(pve_nodes)) }}"
    - name: "PVE-Ressourcen (LXC UND QEMU) nach vmid indexieren (inkl. API-URL + Token + Typ des jeweiligen Nodes)"
      ansible.builtin.set_fact:
        pve_by_vmid: "{{ pve_by_vmid | default({}) | combine({ (item.vmid | string): (item | combine({
          'api': pve_node_lookup_helper[item.node].api,
          'token_id': pve_node_lookup_helper[item.node].token_id,
          'token_secret': pve_node_lookup_helper[item.node].token_secret
        })) }) }}"
      loop: "{{ pve_resources_all | selectattr('type', 'in', ['lxc', 'qemu']) | list }}"
      loop_control:
        label: "{{ item.name }}"
    - name: "WARNUNG - NetBox-vmid ohne Treffer in PVE (werden uebersprungen)"
      ansible.builtin.debug:
        msg: "'{{ item.name }}' (vmid={{ item.custom_fields.vmid }}) nicht in PVE gefunden"
      loop: "{{ netbox_vms_ready }}"
      loop_control:
        label: "{{ item.name }}"
      when: (item.custom_fields.vmid | string) not in pve_by_vmid
    - name: Nur tatsaechlich in PVE vorhandene VMs weiterverarbeiten
      ansible.builtin.set_fact:
        netbox_vms_matched: >-
          {{ netbox_vms_ready
             | selectattr('custom_fields.vmid', 'in', pve_by_vmid.keys() | map('int') | list)
             | list }}
    # -----------------------------------------------------------------
    # 3. vCPU/RAM/Disk-Drift anzeigen (NUR Anzeige, noch kein Push)
    # -----------------------------------------------------------------
    - name: Ressourcen-Drift bauen (vCPU/RAM/Disk, Diff-Anzeige only)
      ansible.builtin.set_fact:
        resource_drift: "{{ resource_drift | default([]) + [{
          'name': item.name,
          'netbox_id': item.id,
          'vmid': item.custom_fields.vmid,
          'node': pve_by_vmid[item.custom_fields.vmid | string].node,
          'netbox_vcpus': item.vcpus | default(None),
          'pve_vcpus': pve_by_vmid[item.custom_fields.vmid | string].maxcpu | int,
          'netbox_memory_mb': item.memory | default(None),
          'pve_memory_mb': (pve_by_vmid[item.custom_fields.vmid | string].maxmem | int / 1024 / 1024) | round(0, 'common') | int,
          'netbox_disk_mb': item.disk | default(None),
          'pve_disk_mb': (pve_by_vmid[item.custom_fields.vmid | string].maxdisk | int / 1024 / 1024) | round(0, 'common') | int
        }] }}"
      loop: "{{ netbox_vms_matched }}"
      loop_control:
        label: "{{ item.name }}"
    - name: "INFO - Ressourcen-Drift je VM (Anzeige; Reverse-Push PVE->NetBox folgt darunter)"
      ansible.builtin.debug:
        msg: >-
          {{ item.name }} (vmid={{ item.vmid }}, node={{ item.node }}):
          vCPU NetBox={{ item.netbox_vcpus }} PVE={{ item.pve_vcpus }}
          {{ '[ABWEICHUNG]' if item.netbox_vcpus | int != item.pve_vcpus else '' }} |
          RAM(MB) NetBox={{ item.netbox_memory_mb }} PVE={{ item.pve_memory_mb }}
          {{ '[ABWEICHUNG]' if item.netbox_memory_mb | int != item.pve_memory_mb else '' }} |
          Disk(MB) NetBox={{ item.netbox_disk_mb }} PVE={{ item.pve_disk_mb }}
          {{ '[ABWEICHUNG - SHRINK, wird NICHT gepusht]' if item.netbox_disk_mb | int < item.pve_disk_mb
             else ('[ABWEICHUNG - GROW]' if item.netbox_disk_mb | int > item.pve_disk_mb else '') }}
      loop: "{{ resource_drift }}"
      loop_control:
        label: "{{ item.name }}"
    - name: NetBox-Update-Aktionsplan bauen (PVE-Ist-Werte sollen nach NetBox uebernommen werden)
      ansible.builtin.set_fact:
        netbox_update_actions: "{{ netbox_update_actions | default([]) + [{
          'name': item.name,
          'netbox_id': item.netbox_id,
          'vmid': item.vmid,
          'target_vcpus': item.pve_vcpus,
          'target_memory': item.pve_memory_mb,
          'target_disk': item.pve_disk_mb,
          'any_change': (item.netbox_vcpus | int != item.pve_vcpus)
                         or (item.netbox_memory_mb | int != item.pve_memory_mb)
                         or (item.netbox_disk_mb | int != item.pve_disk_mb)
        }] }}"
      loop: "{{ resource_drift }}"
      loop_control:
        label: "{{ item.name }}"
    - name: "UEBERSICHT - NetBox-Objekte, die auf PVE-Ist-Werte aktualisiert werden"
      ansible.builtin.debug:
        msg: "'{{ item.name }}' (netbox_id={{ item.netbox_id }}): vCPU->{{ item.target_vcpus }} RAM->{{ item.target_memory }}MB Disk->{{ item.target_disk }}MB"
      loop: "{{ netbox_update_actions }}"
      loop_control:
        label: "{{ item.name }}"
      when: item.any_change
    - name: "PVE-Ist-Werte nach NetBox schreiben (NUR wenn dry_run=false, NUR bei Abweichung)"
      ansible.builtin.uri:
        url: "{{ netbox_api }}/api/virtualization/virtual-machines/{{ item.netbox_id }}/"
        method: PATCH
        headers:
          Authorization: "Token {{ netbox_token }}"
        body_format: json
        body:
          vcpus: "{{ item.target_vcpus }}"
          memory: "{{ item.target_memory }}"
          disk: "{{ item.target_disk }}"
        validate_certs: false
        status_code: [200]
      loop: "{{ netbox_update_actions }}"
      loop_control:
        label: "{{ item.name }}"
      when:
        - not (dry_run | bool)
        - item.any_change
      register: netbox_update_result
      failed_when: false
    - name: Fehlgeschlagene NetBox-Updates auflisten
      ansible.builtin.debug:
        msg: "FEHLER bei {{ item.item.name }}: {{ item.msg | default('unbekannt') }}"
      loop: "{{ netbox_update_result.results | default([]) }}"
      loop_control:
        label: "{{ item.item.name }}"
      when:
        - item.item is defined
        - item.status is defined
        - item.status != 200
    # -----------------------------------------------------------------
    # 4. onboot / start_on_boot: vollstaendig implementiert, inkl. Push
    # -----------------------------------------------------------------
    - name: "'Letzter Status' VMs herausfiltern (werden bewusst nicht gepusht)"
      ansible.builtin.set_fact:
        netbox_vms_laststate: "{{ netbox_vms_matched | selectattr('start_on_boot.value', 'equalto', start_on_boot_laststate_value) | list }}"
        netbox_vms_pushable: "{{ netbox_vms_matched | rejectattr('start_on_boot.value', 'equalto', start_on_boot_laststate_value) | list }}"
    - name: "INFO - VMs mit 'Letzter Status' (nicht abbildbar in Proxmox, wird uebersprungen)"
      ansible.builtin.debug:
        msg: "'{{ item.name }}' (vmid={{ item.custom_fields.vmid }}) steht auf 'Letzter Status' - wird nicht angefasst"
      loop: "{{ netbox_vms_laststate }}"
      loop_control:
        label: "{{ item.name }}"
    - name: Aktuelle PVE-Config je gematchter, pushbarer VM/LXC holen (fuer onboot-Wert)
      ansible.builtin.uri:
        url: "{{ pve_by_vmid[item.custom_fields.vmid | string].api }}/nodes/{{ pve_by_vmid[item.custom_fields.vmid | string].node }}/{{ pve_by_vmid[item.custom_fields.vmid | string].type }}/{{ item.custom_fields.vmid }}/config"
        method: GET
        headers:
          Authorization: "PVEAPIToken={{ pve_by_vmid[item.custom_fields.vmid | string].token_id }}={{ pve_by_vmid[item.custom_fields.vmid | string].token_secret }}"
        validate_certs: false
        status_code: [200]
      loop: "{{ netbox_vms_pushable }}"
      loop_control:
        label: "{{ item.name }}"
      register: pve_configs_raw
    - name: Aktionsplan bauen (Diff NetBox start_on_boot vs. PVE onboot)
      ansible.builtin.set_fact:
        onboot_actions: "{{ onboot_actions | default([]) + [{
          'name': item.item.name,
          'vmid': item.item.custom_fields.vmid,
          'node': pve_by_vmid[item.item.custom_fields.vmid | string].node,
          'type': pve_by_vmid[item.item.custom_fields.vmid | string].type,
          'api': pve_by_vmid[item.item.custom_fields.vmid | string].api,
          'token_id': pve_by_vmid[item.item.custom_fields.vmid | string].token_id,
          'token_secret': pve_by_vmid[item.item.custom_fields.vmid | string].token_secret,
          'netbox_start_on_boot': item.item.start_on_boot.value,
          'netbox_wants_enabled': (item.item.start_on_boot.value == start_on_boot_enabled_value),
          'pve_onboot': (item.json.data.onboot | default(0) | int == 1)
        }] }}"
      loop: "{{ pve_configs_raw.results }}"
      loop_control:
        label: "{{ item.item.name }}"
    - name: "DRY RUN / UEBERSICHT - Alle gematchten, pushbaren VMs mit onboot-Stand"
      ansible.builtin.debug:
        msg: >-
          {{ item.name }} (vmid={{ item.vmid }}, node={{ item.node }}):
          NetBox={{ item.netbox_start_on_boot }} ({{ 'on' if item.netbox_wants_enabled else 'off' }})
          PVE-onboot={{ item.pve_onboot }}
          {{ '[WIRD GEAENDERT]' if item.netbox_wants_enabled != item.pve_onboot else '[unveraendert]' }}
      loop: "{{ onboot_actions }}"
      loop_control:
        label: "{{ item.name }}"
    - name: onboot-Wert in PVE setzen (nur bei tatsaechlicher Abweichung, nur wenn dry_run=false)
      ansible.builtin.uri:
        url: "{{ item.api }}/nodes/{{ item.node }}/{{ item.type }}/{{ item.vmid }}/config"
        method: PUT
        headers:
          Authorization: "PVEAPIToken={{ item.token_id }}={{ item.token_secret }}"
        body_format: form-urlencoded
        body:
          onboot: "{{ 1 if item.netbox_wants_enabled else 0 }}"
        validate_certs: false
        status_code: [200]
      loop: "{{ onboot_actions }}"
      loop_control:
        label: "{{ item.name }}"
      when:
        - not (dry_run | bool)
        - item.netbox_wants_enabled != item.pve_onboot
      register: onboot_push_result
      failed_when: false
    - name: Fehlgeschlagene onboot-Updates auflisten
      ansible.builtin.debug:
        msg: "FEHLER bei {{ item.item.name }}: {{ item.msg | default('unbekannt') }}"
      loop: "{{ onboot_push_result.results | default([]) }}"
      loop_control:
        label: "{{ item.item.name }}"
      when:
        - item.item is defined
        - item.status is defined
        - item.status != 200

den “slug” sieht man am Standort wenn man auf Bearbeiten klickt. Da ich meinen Wohnrt nicht im Internet teilen möchte, habe ich die Felder verpixelt. In meinem Fall sind zwei PVE Hosts vorhanden und deren beiden IPs sind hart in das Skript kodiert. Wer das Skript verwenden möchte muss es an die eigene Situation anpassen.

Bildschirmfoto_20260901_161631.png

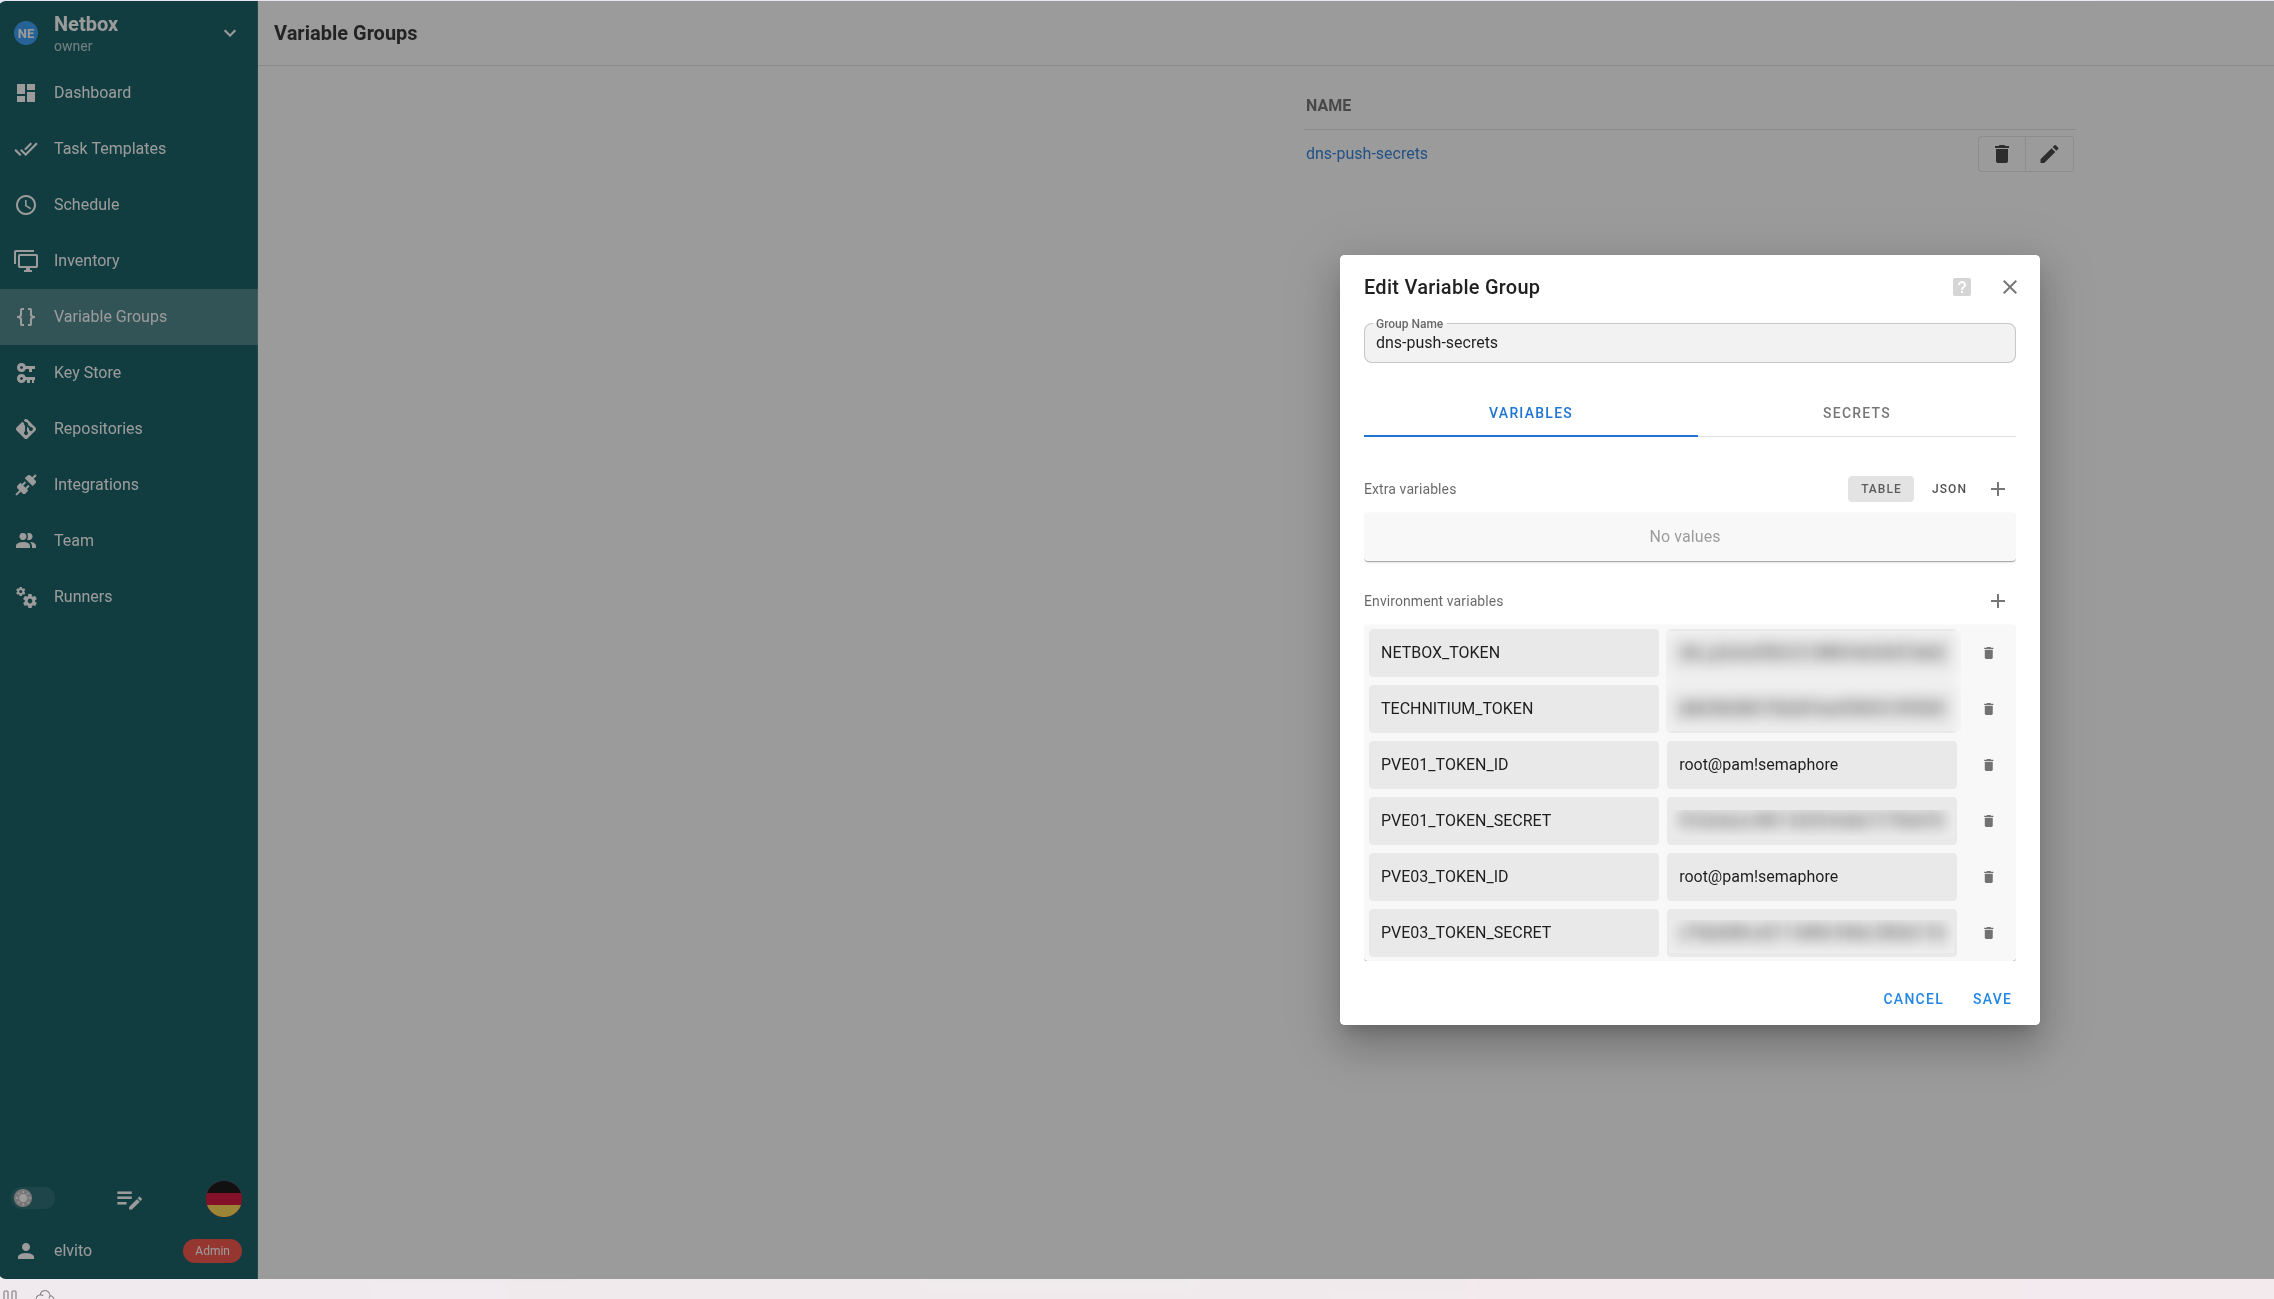
Aus Faulheitsgründen habe ich die vorher erzeugten PVE Token einfach in das Variablenfile der dns-push skripte dazugepackt. Man könnte das natürlich auch trennen, hat beides Vor- und Nachteile…

Bildschirmfoto_20260901_162918.png

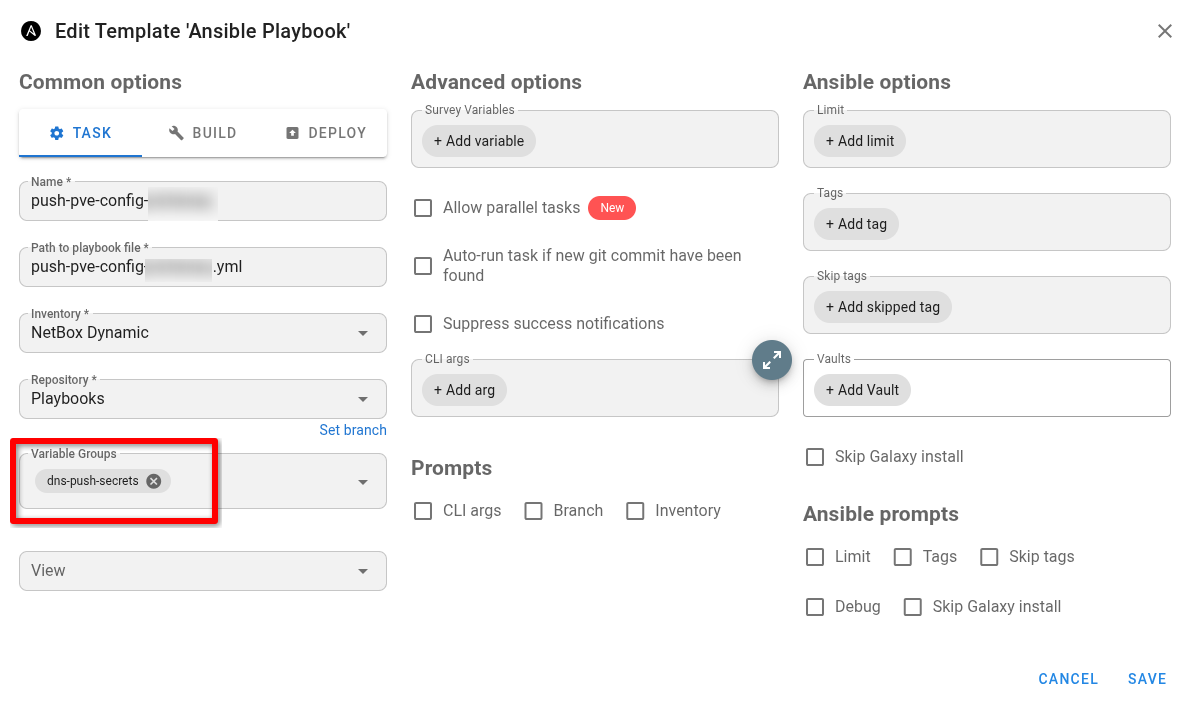
Dem bereits vorhandenen Netbox Token habe ich nachträglich noch Scheibrechte eingeräumt (geht nachträglich über die GUI), sonst ließen sich keine Werte (vCPU, RAM etc.) aus PVE in Netbox schreiben. Zum Schluss noch das neue Playbook via Template in Semaphore einfügen.

Bildschirmfoto_20260901_163224.png

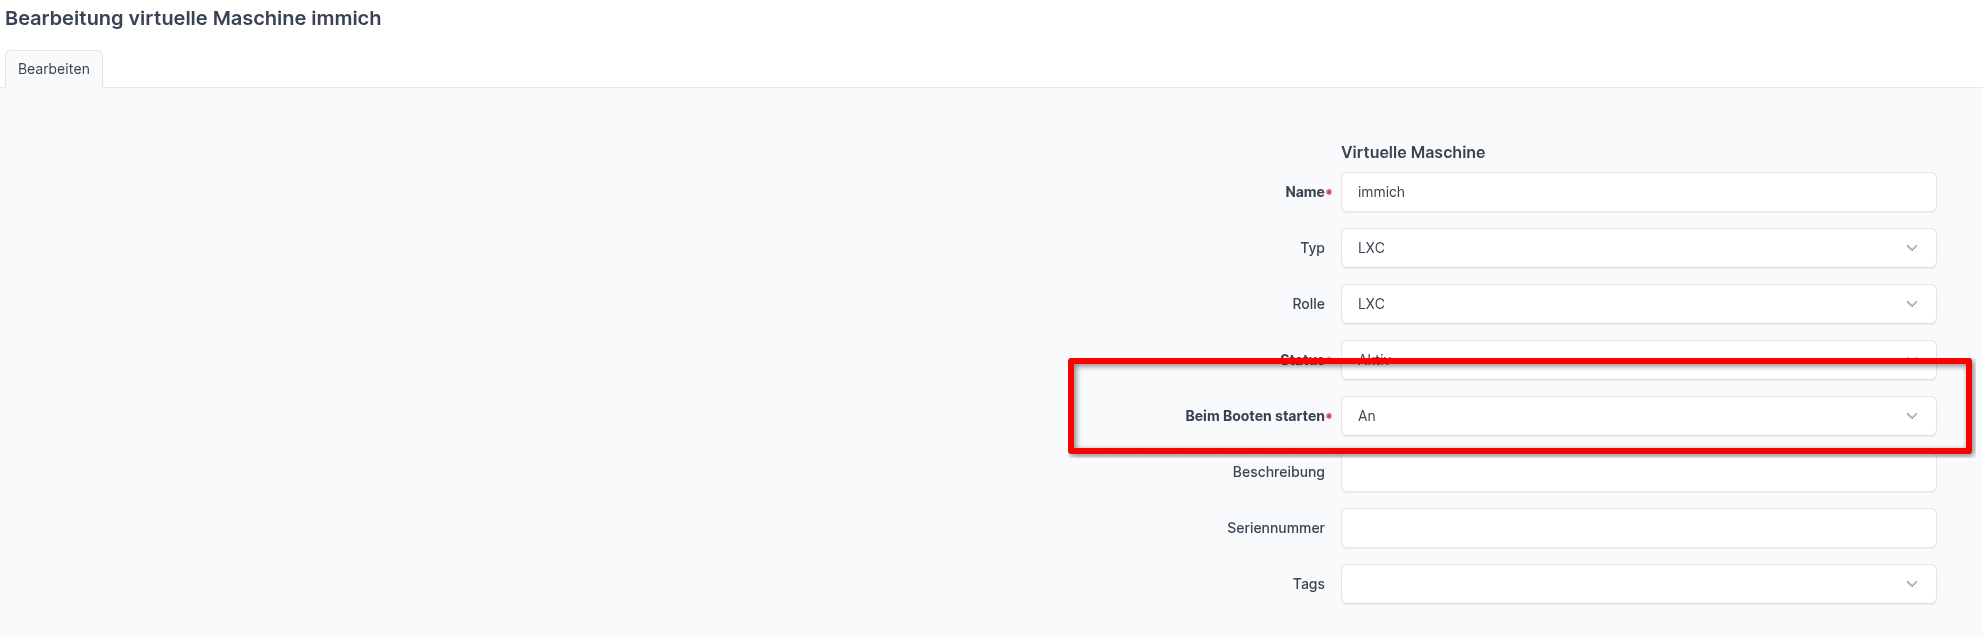
Die virtuellen Maschinen kennen bei Netbox bereits ein Feld für den Zustand nach Reboot

Bildschirmfoto_20260901_163659.png

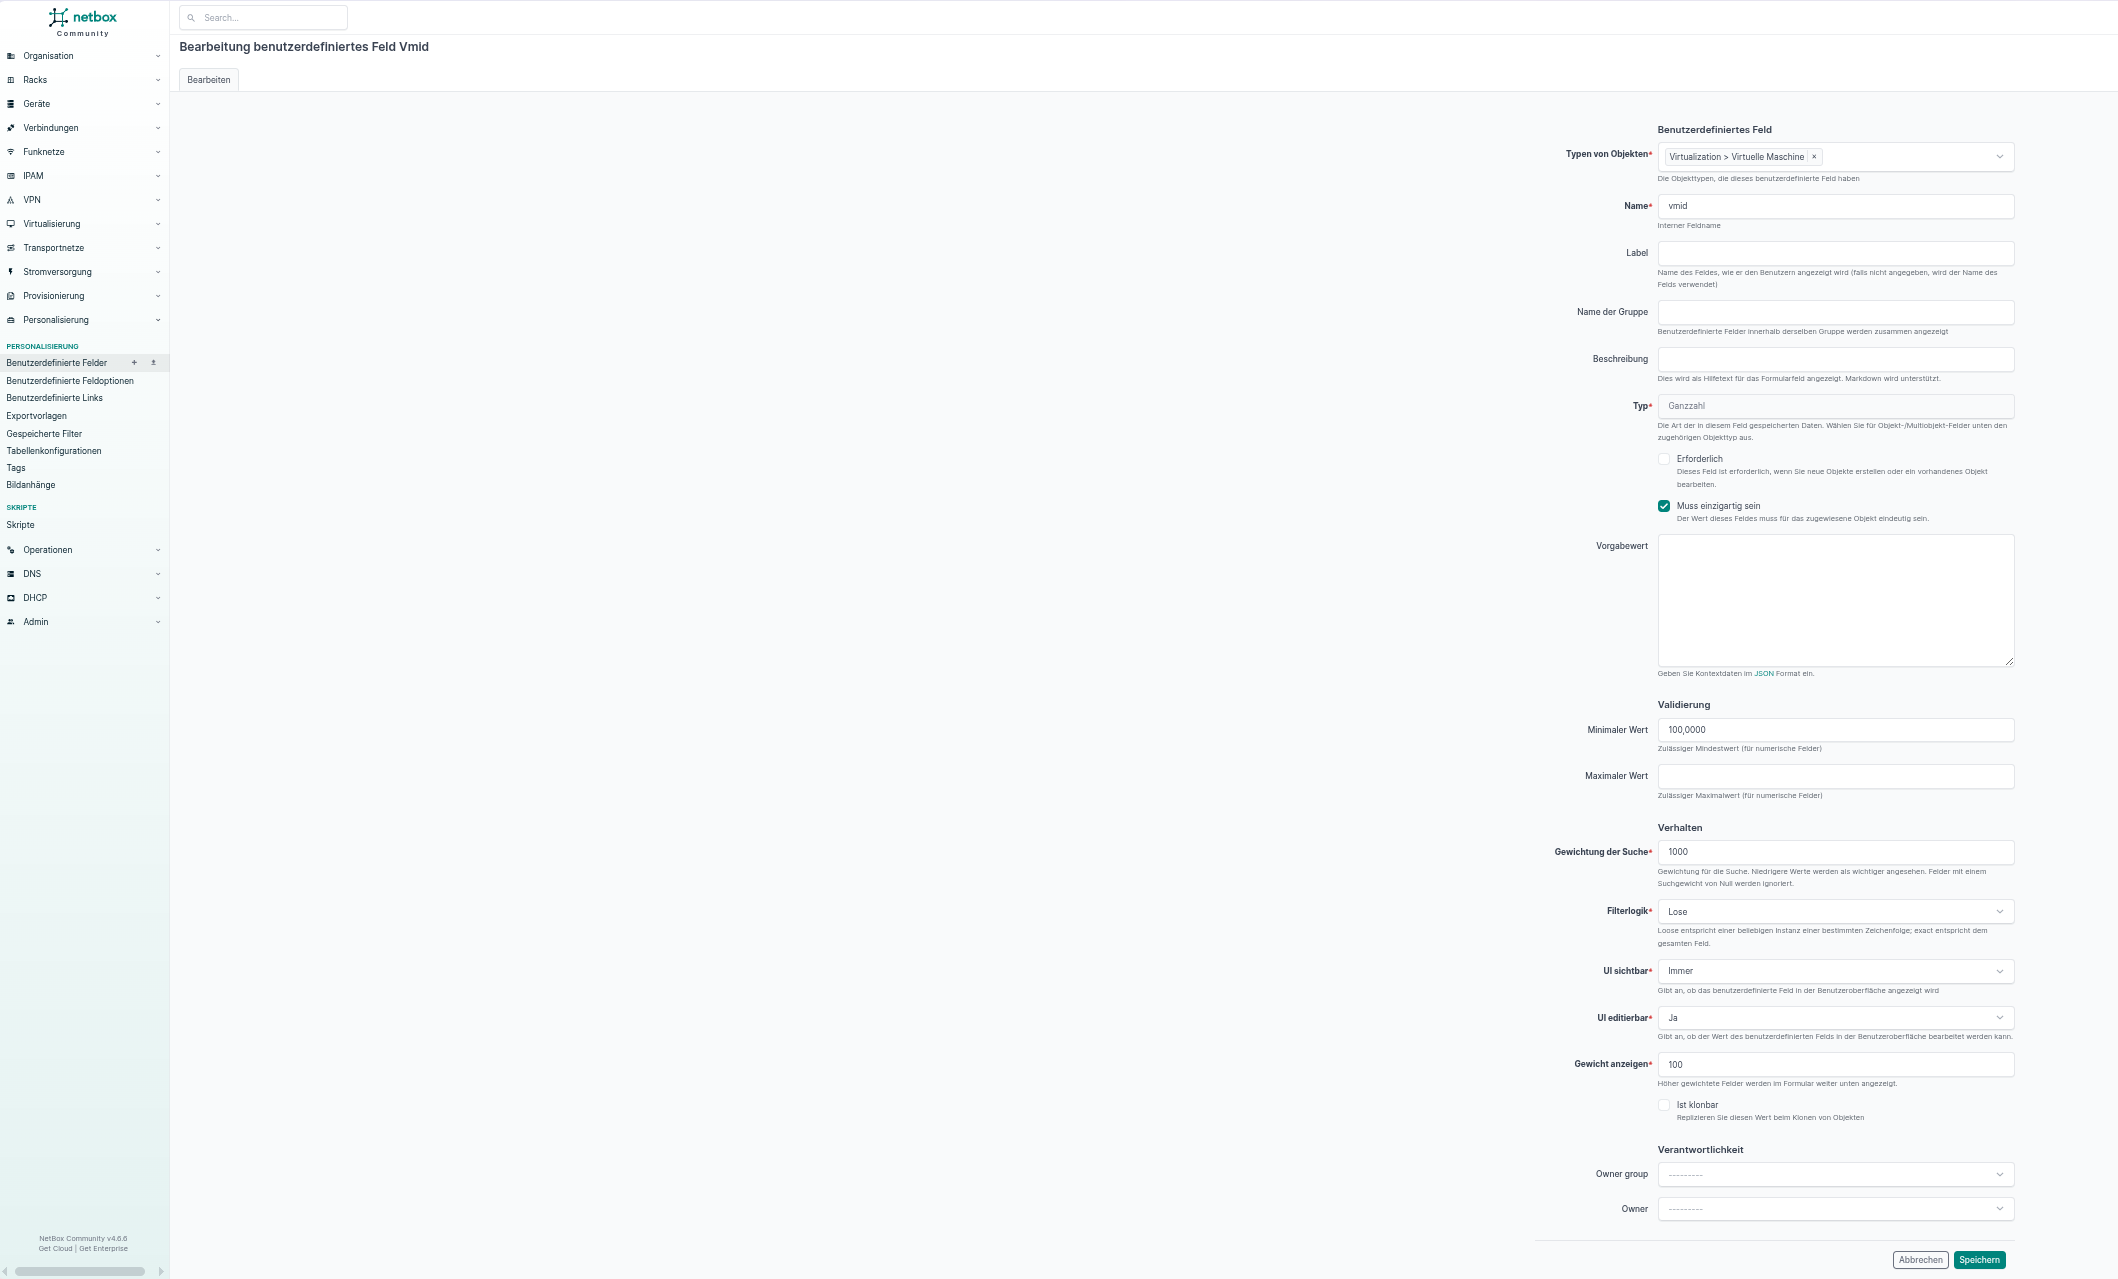
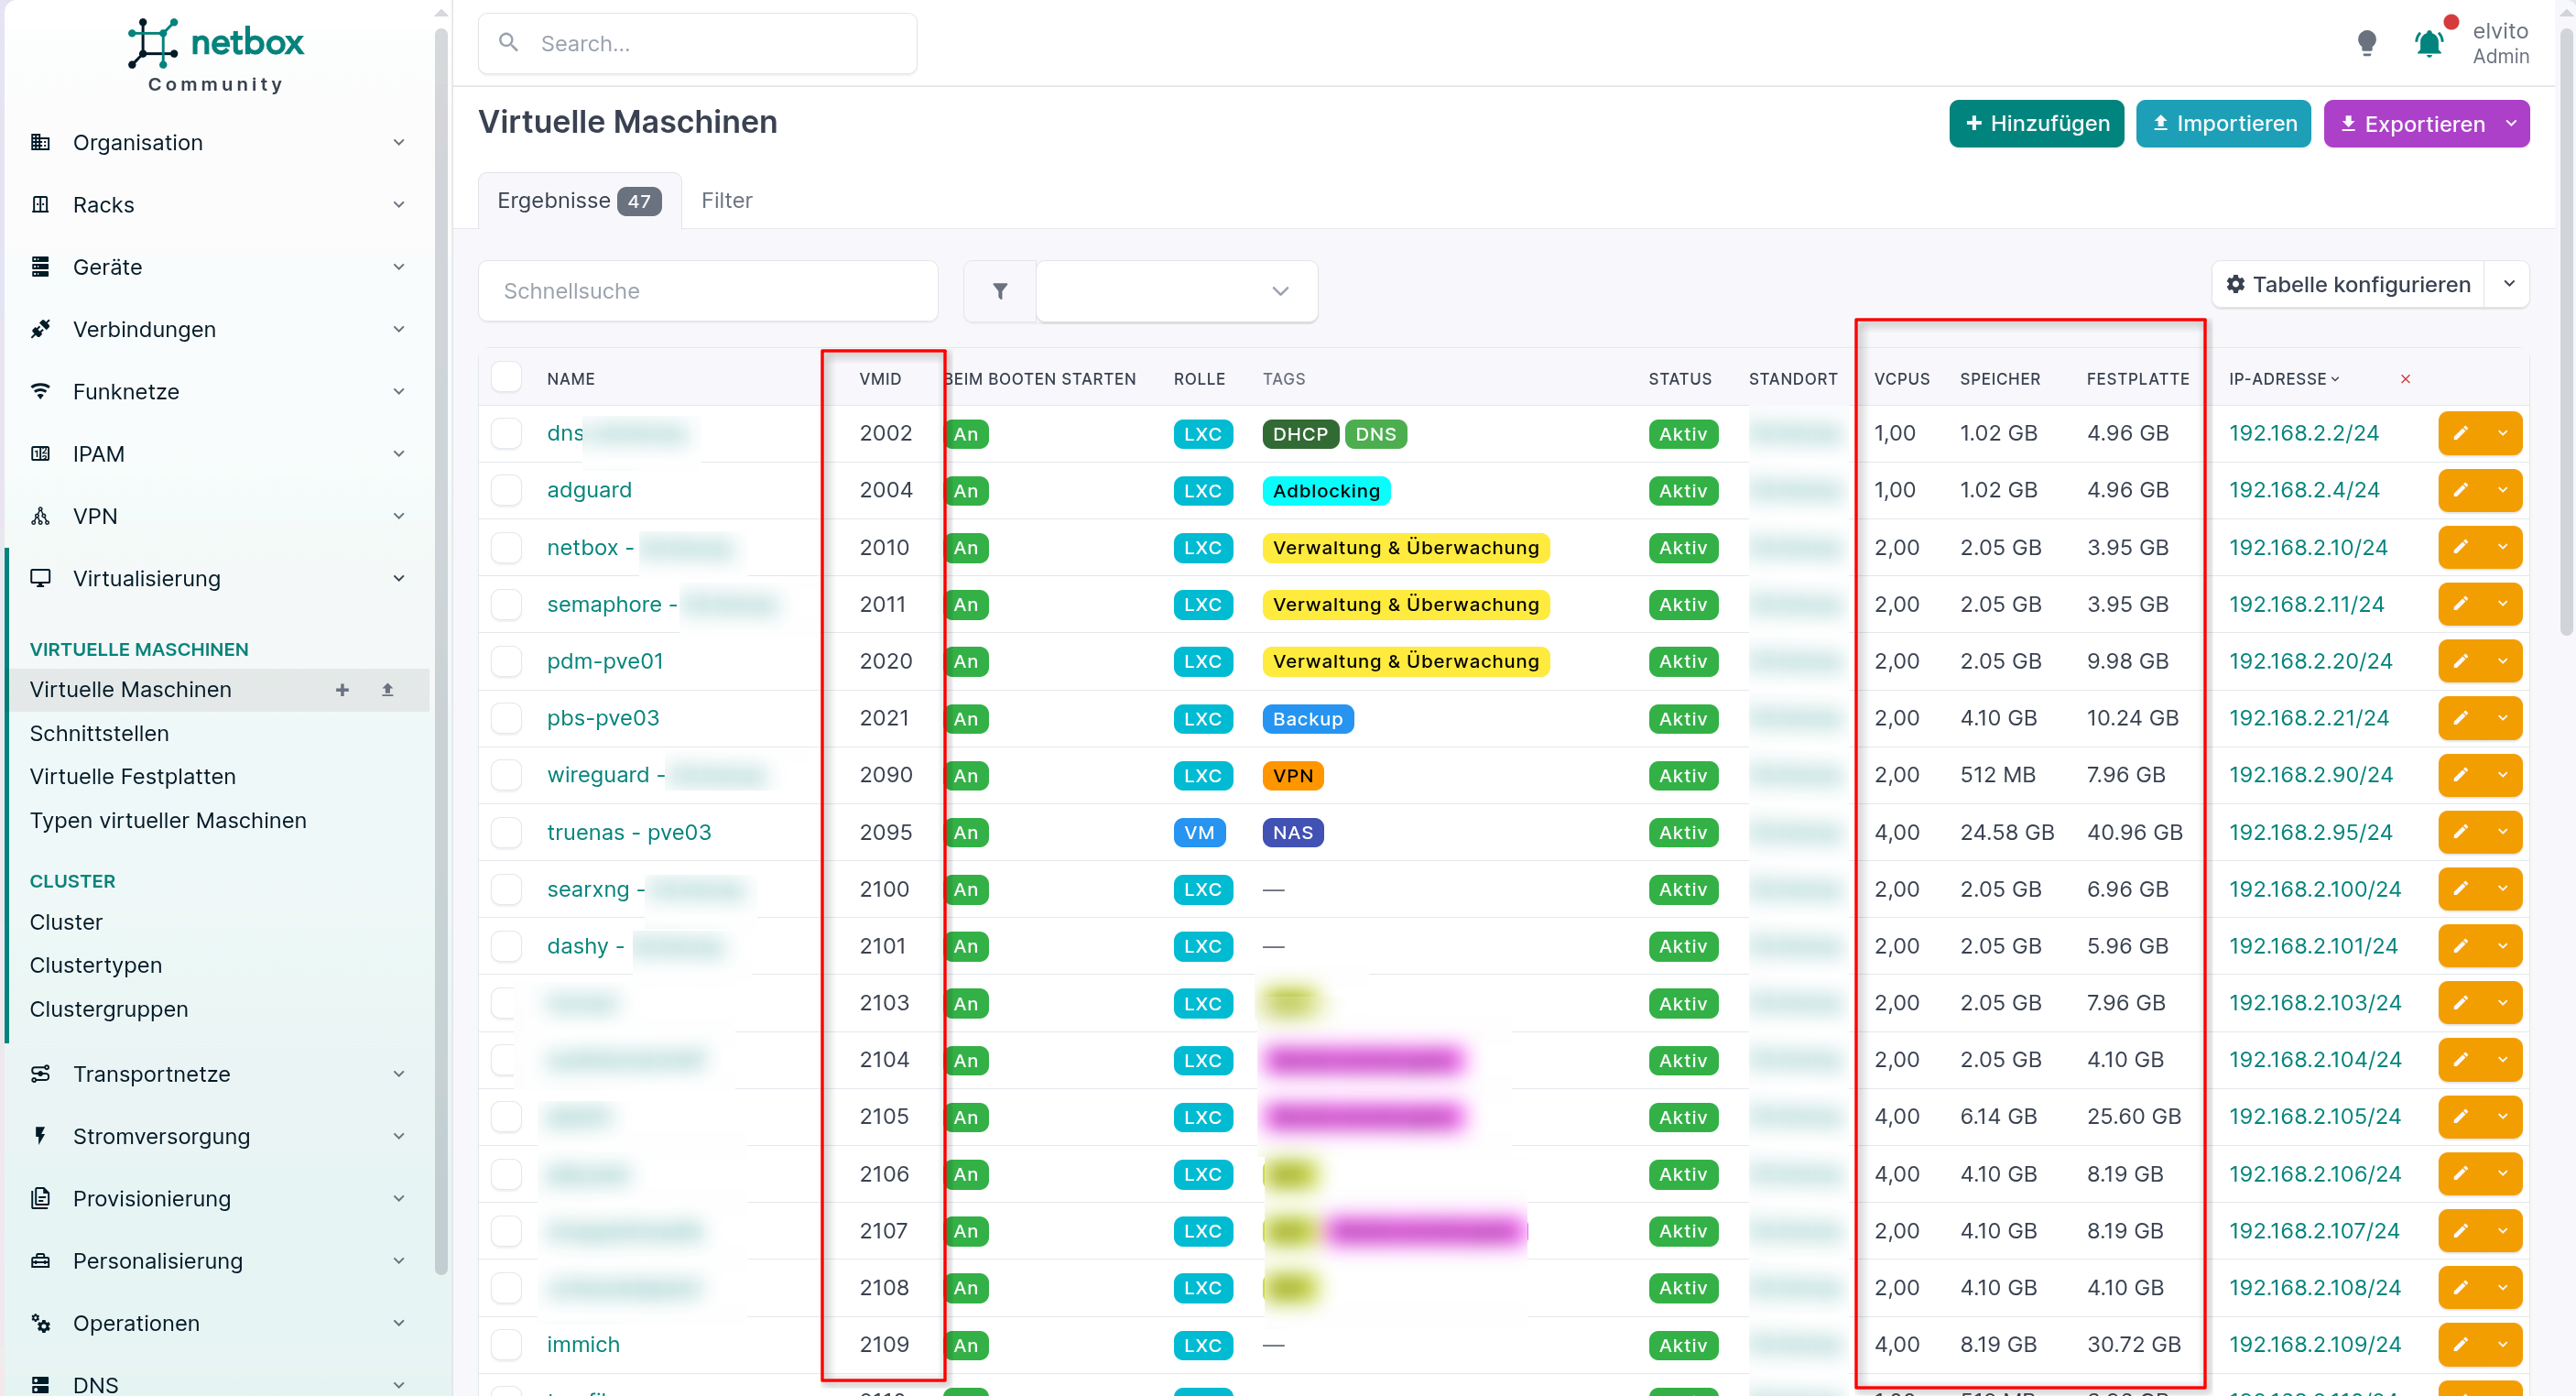
Bei PVE wird als “Primary Key” zur Identifikation die sogenannte VMID verwendet. Dafür gibt es (noch) kein Feld bei Netbox. Nachdem man das neue Feld erzeugt hat, muss man es noch für jede virtuelle Instanz manuell befüllen. Nur LXCs und VMs die in Netbox manuell eine solche vmid zugewiesen bekommen haben, werden von obigen Skript auch berücksichtigt, der Rest wird ignoriert.

Bildschirmfoto_20260901_164407.png
Bildschirmfoto_20260902_095710-1.png

Nachdem ich das Skript ein paar mal getestet hatte, habe ich einen cronjob alle 10 Minuten dafür eingerichtet, das geht in Semaphore ja auch über die GUI. Ich kann jetzt zentral in Netbox das Verhalten aller virtuellen Instanzen nach einem Reboot des jeweiligen PVE Hosts steuern. Im gleichen Schritt werden die Werte für vCPU, RAM etc von den virtuellen Instanzen ausgelesen und in Netbox synchronisiert. Netbox tut sich etwas schwer mit der Umrechnung (Bei Netbox sind 1000MB ein GB und nicht 1024MB wie es richtig wäre), das stört mich aber nicht weiter. Der große Vorteil dabei ist nun, dass ich das Rebootverhalten nun auch massenhaft ändern kann und ich mich nicht mehr einzeln durchklicken muss.

Freitag, Juli 24, 2026

Netbox - Erweiterung des Tailscale Tunnels für Loki/Alloy

Die Logs laufen nun von allen PVEs (an beiden Standorten), der lokalen Netbox-Instanz und dem lokalen Technitium-Server bei Loki zusammen. Der Technitium-Server am anderen Standort kann jedoch seine Logs aktuell noch nicht an Loki (läuft in meinem Heimnetz) schicken. Bei den anderen Instanzen war dies kein Problem, denn Tailscale ist auf allen PVEs installiert und fungiert mit den beiden TS-Subnet-Routern als Transportschicht ins entfernte Subnetz.

Auf meinen Technitium-Servern möchte ich kein Tailscale installieren, daher bleibt mir nur der Trick mit dem Tailscale-Tunnel, diesmal jedoch in die andere Richtung. Das ist eh nicht verkehrt, den Weg zusätzlich einzurichten, ich kann damit jederzeit weiteren Geräten/LXCs/VMs eine Verbindung ins jeweils andere Subnet geben, ohne extra Tailscale installieren zu müssen. Ich habe auch bereits einen Weg gefunden, solche Routen in Netbox abzubilden, das werde ich aber erst angehen, sobald die Fernsteuerung per Ansible funktioniert.

Zunächst lege ich in den Tailscale-ACLs einen neuen Host namens loki an und weise ihm die tatsächliche LAN-IP-Adresse zu. Ich muss zusätzlich eine neue Action in den ACLs definieren. Die Änderungen in den ACLs sollten anhand der Screenshots selbsterklärend sein.

Bildschirmfoto_20260724_162249.png
Bildschirmfoto_20260724_162535.png

Nun trage ich die Route vom externen Technitium-Server (dns-giesing) in mein Heimnetz ein. Ich wechsele dazu in die Shell von dns-giesing und setze zunächst eine temporäre Route. Wenn es funktioniert, mache ich die Route persistent.

ip route add 192.168.2.0/24 via 192.168.3.67

Die IP-Adresse 192.168.3.67 gehört dem LXC mit Tailscale, das als Tailscale-Subnet-Router und Exit-Node im entfernten Subnetz fungiert. Mit

ip route show

kann man die aktuell gesetzte Route kontrollieren.

Bildschirmfoto_20260724_163737-1.png

Nur zum Spaß teste ich einen Ping bereits vor der iptables-Regel auf dem TS-Subnet-Router hier im Heimnetz und stelle entsetzt fest, dass der Ping bereits jetzt durchgegangen ist… Ich vermute, das liegt an den TS-eigenen Masquerading-, SNAT- und sonstigen Geschichten, die da im Hintergrund laufen. (Hier steht die Erklärung, SNAT war die richtige Vermutung) Ich setze auf dem TS-Subnet-Router in meinem Heimnetz die iptables-Regel mit Masquerading trotzdem. Die Verbindung sollte dann auch noch funktionieren, wenn ich irgendwann mal etwas an der globalen Tailscale-SNAT-Einstellung ändere.

iptables -t nat -A POSTROUTING -o eth0 -s 192.168.3.0/24 -j MASQUERADE

Der Ping geht nun vom entfernten Technitium-LXC zu meinem lokalen Loki-LXC.

Bildschirmfoto_20260724_171050.png

Optimal! Nun mache ich noch die Änderungen persistent, auf dem LXC im Heimnetz mit dem TS-Subnet-Router.

apt install iptables-persistent -y
netfilter-persistent save

und auf dns-giesing (Technitium) noch die Route fest in die /etc/network/interfaces eintragen:

auto lo
iface lo inet loopback
auto eth0
iface eth0 inet static
address 192.168.3.2/24
gateway 192.168.3.1
post-up ip route add 192.168.2.0/24 via 192.168.3.67

Donnerstag, Juli 23, 2026

Netbox - Loki - Housekeeping - Abschluss des zentralen Loggings

Nachtrag 30.07.26: Man sollte einen anderen Pfad für das Logfile wählen, da sonst spätere Updates des LXCs fehlschlagen werden.

Damit die Logs nicht das LXC mit Loki vollschreiben und so zum Absturz bringen, muss ich eine Logrotation konfigurieren. Das ist per default nicht aktiviert. Man kann das bei Loki sehr fein einstellen. Manche Logs sollten evtl. länger als andere aufbewahrt werden und ich sollte mir möglichst vorher darüber Gedanken machen, wie ich das am besten strukturiere.
Grundsätzlich möchte ich zentrale Logs von

  1. NetBox (1x Einrichtung bekannt)
  2. Technitium (2x Einrichtung bekannt)
  3. PVE (4x Einrichtung bekannt)
  4. PBS (3x)
  5. TrueNAS (3x)
  6. einige LXCs (z.B. zigbee2mqtt, evtl. auch noch Home Assistant)

Punkt 4-6 wären nur ein Nice-to-have. Das zentrale Logging für die drei wichtigsten Dienste (Technitium, PVE und NetBox) funktioniert bereits bzw. die Einrichtung ist bekannt. Nun zur Vorhaltedauer der jeweiligen Logs. Ich lasse zwei KIs den voraussichtlichen Platzbedarf im Loki-LXC schätzen. Dafür werden 4–12 GB/Jahr geschätzt. Loki scheint die Logs effizient komprimieren zu können. Ich habe das LXC bereits vorher auf 10 GB resized, aktuell werden ca. 1,5 GB verbraucht, das sollte also vorerst locker reichen und ich werde mich jetzt hier nicht verkünsteln. Ich werde einfach eine globale Retention von 180 Tagen einstellen. Ich hoffe nicht, dass ich jemals in den Logs etwas nachsehen muss, das länger als 180 Tage in der Vergangenheit liegt.

cp /etc/loki/config.yml /etc/loki/config.yml.bak
nano /etc/loki/config.yml

Ich mache ein Backup der Original-Config-Datei und trage in der Config eine globale Vorhaltezeit ein:

limits_config:
  metric_aggregation_enabled: true
  retention_period: 4320h

4320h entsprechen den 180 Tagen. Das reicht aber noch nicht, die eingestellte Vorhaltezeit muss noch von dem sogenannten Compactor umgesetzt werden. Bei Loki ist der Compactor quasi der Buchhalter. Der Compactor braucht für die Komprimier-/Lese-/Schreib-/Löschvorgänge ein Arbeitsverzeichnis. Das Verzeichnis gibt es bereits unter /var/lib/loki/compactor. In der Config setze ich den neuen Codeblock mit dem Compactor zwischen die Blöcke limits_config und ruler:

compactor:
  working_directory: /var/lib/loki/compactor
  retention_enabled: true
  retention_delete_delay: 2h
  delete_request_store: filesystem

Wie oft der Compactor läuft, kann man in der gleichen Config unter dem Punkt compaction_interval eintragen, Default sind 10 Minuten, das passt für mich bereits. Abschließend Loki neu starten mit

systemctl restart loki

Ich hab’s eine Zeit lang laufen lassen. Man kann nach einiger Zeit mit

journalctl -u loki -f

Zeilen wie diese sehen:

Jul 23 13:10:12 loki loki[560]: level=info ts=2026-07-23T11:10:12.534471137Z caller=tables_manager.go:289 msg="finished compacting table" table-name=index_20654

Der Compactor scheint zu “kompaktieren” 😃
Bei der Gelegenheit räume ich auch gleich mein dämliches Konstrukt mit rsyslog in dem NetBox-LXC auf. Ich editiere dazu die /opt/netbox/netbox/netbox/configuration.py und ersetze dort den gesamten Part mit LOGGING durch:

LOGGING = {
    'version': 1,
    'disable_existing_loggers': False,
    'formatters': {
        'normal': {'format': '%(asctime)s %(name)s %(levelname)s: %(message)s'},
    },
    'handlers': {
        'console': {
            'level': 'INFO',
            'class': 'logging.StreamHandler',
        },
        'file': {
            'level': 'INFO',
            'class': 'logging.handlers.WatchedFileHandler',
            'filename': '/opt/netbox/logs/netbox.log',
            'formatter': 'normal',
        },
    },
    'loggers': {
        'netbox': {'handlers': ['console', 'file'], 'level': 'INFO'},
        'django': {'handlers': ['console', 'file'], 'level': 'WARNING'},
    },
}

Damit möchte ich die Logs zusätzlich in der Datei /opt/netbox/logs/netbox.log speichern. Das Verzeichnis gibt es noch nicht, also lege ich es an und übertrage die Ownership auf den User netbox.

mkdir -p /opt/netbox/logs
chown netbox:netbox /opt/netbox/logs

Jetzt NetBox neu starten

systemctl restart netbox netbox-rq

und ein Fantasiegerät in NetBox anlegen und wieder löschen.

cat /opt/netbox/logs/netbox.log

zeigt nun bei mir

2026-07-23 11:23:55,221 netbox.views.ObjectEditView INFO: Created Gerät jhghjvbhj (PK: 83)
2026-07-23 11:24:33,928 netbox.views.ObjectDeleteView INFO: Deleted Gerät jhghjvbhj

In UTC-Zeit, sehr schön, so soll das sein. Jetzt muss Alloy installiert werden, der dann das Ganze an das Loki-LXC schickt. Mein Denkfehler war, dass ich zuerst gedacht habe, dass EINE Alloy-Instanz alle Daten “einsammelt”, Alloy ist allerdings ein Agent, der auf dem sendenden Service mitlaufen muss.

apt update && apt install -y gpg wget
mkdir -p /etc/apt/keyrings
wget -q -O /etc/apt/keyrings/grafana.asc https://apt.grafana.com/gpg-full.key
chmod 644 /etc/apt/keyrings/grafana.asc
echo "deb [signed-by=/etc/apt/keyrings/grafana.asc] https://apt.grafana.com stable main" | tee /etc/apt/sources.list.d/grafana.list
apt update
apt install -y alloy

sollte Alloy auf alle Debian-basierten Geräte/Services packen können. Das wäre evtl. auch gleich ein Alloy-Deploy-Script für Ansible. Sobald Alloy in dem NetBox-LXC installiert ist, die /etc/alloy/config.alloy editieren, ich schmeiß dort alles raus und setze für das NetBox-LXC stattdessen folgendes ein:

loki.source.file "netbox" {
  targets = [
    {__path__ = "/opt/netbox/logs/netbox.log", job = "netbox", host = "netbox01"},
  ]
  forward_to = [loki.write.central.receiver]
}
loki.write "central" {
  endpoint {
    url = "http://192.168.2.12:3100/loki/api/v1/push"
  }
}

Alloy auf NetBox starten und enablen mit

systemctl enable --now alloy

Jetzt rsyslog wieder zurückbauen

systemctl disable --now rsyslog
rm -f /etc/rsyslog.d/99-loki-forward.conf
apt purge -y rsyslog
apt autoremove

und schon ist rsyslog wieder weg.

Als Nächstes Technitium reparieren. Dazu in das Technitium-LXC wechseln und Alloy genauso wie im NetBox-LXC installieren. Bei Technitium wird bereits das Log in ein File geschrieben, ich muss hier also kein extra Verzeichnis anlegen. Die /etc/alloy/config.alloy sieht für Technitium so bei mir aus:

local.file_match "technitium" {
  path_targets = [
    {__path__ = "/etc/dns/logs/*.log", job = "technitium", host = "technitium01"},
  ]
}
loki.source.file "technitium" {
  targets    = local.file_match.technitium.targets
  forward_to = [loki.write.central.receiver]
}
loki.write "central" {
  endpoint {
    url = "http://192.168.2.12:3100/loki/api/v1/push"
  }
}

Die einzelnen Werte muss man bei allen Configs natürlich entsprechend an sein Setup anpassen. Nun Alloy starten und enablen. rsyslog lässt sich genau so wie im NetBox-LXC entfernen

systemctl enable --now alloy
Bildschirmfoto_20260723_144248.png
Bildschirmfoto_20260723_144514.png

In Grafana kann ich jetzt mit einem Klick zwischen den Logs der einzelnen Services/Geräte hin- und herschalten. Man kann so auch die Logs mehrerer Geräte im gleichen Zeitraum nebeneinanderlegen, die Logs bequem durchsuchen oder sich anhand von Mustern oder Schlüsselwörtern alarmieren lassen. Wie cool ist das denn bitte! 😃 Der Aufwand hat sich definitiv gelohnt. Das Einbinden der restlichen Geräte werde ich nun der Reihe nach durchführen, dann geht’s weiter mit Ansible.

Mittwoch, Juli 22, 2026

Netbox - Einbinden weiterer Geräte in Alloy/Loki/Grafana - PVE

Nach meinem kleinen ungeplanten Exkurs bezüglich “Codedarstellung in Flatpress” kann ich mich wieder dem ursprünglichen Exkurs “zentrales Logging”, vom eigentlichen Hauptthema “Zentrale Steuerung via NetBox”, widmen. Man kommt schnell vom 100sten ins 1000ste, wenn man nicht aufpasst. Nun binde ich mal einen PVE ein. Hoffentlich geht das etwas simpler als die beiden vorherigen Dienste (NetBox & Technitium). Danach muss ich unbedingt noch die Aufräumfunktion für Logs in Alloy/Loki ansehen, sonst läuft mir das LXC ruckzuck mit Logfiles voll. Log-Housekeeping bekommt danach auch einen eigenen Artikel, doch zunächst zurück zu PVE/Loki.

Zuerst kläre ich mal, welche Uhrzeit überhaupt in PVE läuft

Bildschirmfoto_20260722_173156.png

irgendwie sehen die rohen Logs von PVE aber auch so aus, als ob sie Loki vom Format her nicht schmecken würden. Ich lese also doch mal lieber die Alloy/Loki-Doku, was ich von Anfang an hätte tun sollen, und stelle fest, dass ich die anderen beiden Geräte mit einer meiner irrsinnigen Overengineering-Frickellösungen “falsch” eingerichtet habe. 😂 Es funktioniert zwar, geht aber über einen Alloy-Agent VIEL einfacher. Das probieren wir doch gleich mal in PVE aus und revertieren danach die anderen beiden Dienste wieder.

Ich bin natürlich nicht der Erste, der Alloy mit PVE verheiraten will. Wie man Alloy am besten in PVE einbindet, wurde im Proxmox-Forum bereits diskutiert. Der Kommentar #8 klingt jedenfalls interessant. Der Kollege hat via Ansible nicht nur remote auf allen Zielgeräten den Alloy-Agent deployed, sondern er hält ihn über Ansible auch aktuell. Sehr clever 😃

Ich wollte auf den PVE-Hosts eigentlich so wenig wie möglich installieren, bei NUT habe ich bereits eine Ausnahme gemacht, eigentlich gefällt es mir nicht so gut, zusätzliche Software auf den PVE-Hosts selbst zu installieren. Ein eigenes LXC nur für Alloy klingt aber auch nicht viel besser. Ich habe mal im deutschen Discord-Channel der Community-Scripts nachgefragt, wie die Profis das so machen, aber MickLesk hat mich scheinbar missverstanden: Er dachte wohl, ich will zentral Metriken sammeln, was bei PVE wenig Sinn machen würde.

Ich gehe mal den direkten Weg und installiere Alloy direkt auf PVE:

apt update && apt install -y gpg wget
mkdir -p /etc/apt/keyrings #kann entfallen, falls es das Verzeichnis schon gibt
wget -q -O /etc/apt/keyrings/grafana.asc https://apt.grafana.com/gpg-full.key
chmod 644 /etc/apt/keyrings/grafana.asc
echo "deb [signed-by=/etc/apt/keyrings/grafana.asc] https://apt.grafana.com stable main" 
  | tee /etc/apt/sources.list.d/grafana.list
apt update
apt install -y alloy

Danach muss ich dem Alloy-Agent auf dem PVE noch eine passende Config verpassen. Den Inhalt von /etc/alloy/config.alloy auf dem PVE habe ich ersetzt durch:

loki.source.journal "pve_journal" {
  forward_to    = [loki.write.central.receiver]
  relabel_rules = loki.relabel.journal.rules
  labels        = {
    job  = "systemd-journal",
    host = "pve01",
  }
}
loki.relabel "journal" {
  forward_to = []
  rule {
    source_labels = ["__journal__systemd_unit"]
    target_label  = "unit"
  }
}
loki.write "central" {
  endpoint {
    url = "http://192.168.2.12:3100/loki/api/v1/push"
  }
}

und starten/enablen mit:

systemctl enable --now alloy
Bildschirmfoto_20260722_213550.png

Da sind die PVE Logs in Grafana. Das war wesentlich einfacher als meine Verrenkungen davor.